

Investigadores de la Universidad de Cambridge han publicado una técnica para la inserción encubierta de código malicioso en textos fuente revisados. El método de ataque preparado (CVE-2021-42574) se presenta bajo el nombre Trojan Source y se basa en la formación de texto que aparentemente se ve diferente para el compilador/interprete y para las personas que revisan el código. Se han demostrado ejemplos de la técnica para varios compiladores e intérpretes utilizados en lenguajes como C, C++ (gcc y clang), C#, JavaScript (Node.js), Java (OpenJDK 16), Rust, Go y Python.
El método se basa en el uso de caracteres Unicode especiales en los comentarios del código, que alteran el orden de visualización de texto bidireccional. Con estos caracteres de control, algunas partes del texto pueden mostrarse de izquierda a derecha, mientras que otras de derecha a izquierda. En la práctica diaria, tales caracteres de control pueden utilizarse, por ejemplo, para insertar líneas en hebreo o árabe en un archivo de código. Sin embargo, si se combinan cadenas con diferentes direcciones de texto en una sola línea, utilizando los caracteres mencionados, fragmentos de texto mostrados de derecha a izquierda pueden superponerse al texto normal mostrado de izquierda a derecha.
Usando este método, se puede añadir una construcción maliciosa en el código, pero luego hacer que el texto de esta construcción pase desapercibido al revisarlo, mediante la adición en el siguiente comentario o dentro de un literal de caracteres mostrados de derecha a izquierda, lo que dará como resultado la superposición de caracteres totalmente diferentes sobre la inserción maliciosa. Este tipo de código permanecerá semánticamente correcto, pero será interpretado y mostrado de manera diferente.
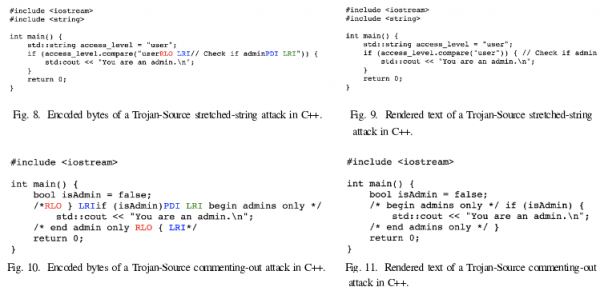
Durante el proceso de revisión del código, el desarrollador se encontrará con el orden visual de los caracteres y verá en un editor de texto moderno, interfaz web o IDE un comentario que no levantará sospechas, pero el compilador e intérprete utilizarán el orden lógico de los caracteres y procesarán la inserción maliciosa tal como es, sin prestar atención al texto bidireccional en el comentario. Varios editores de código populares (VS Code, Emacs, Atom) y las interfaces para ver código en repositorios (GitHub, Gitlab, BitBucket y todos los productos de Atlassian) son vulnerables a este problema.
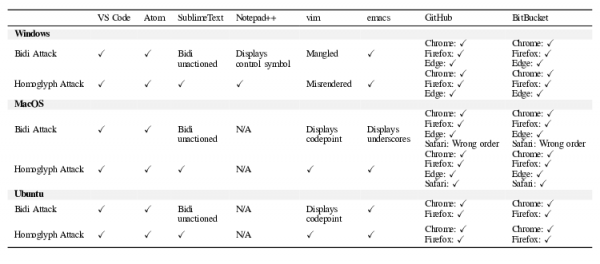
Se destacan varios métodos de uso del método para realizar acciones maliciosas: agregar una expresión oculta 'return', que lleva a la finalización de la ejecución de la función antes de tiempo; comentar expresiones que normalmente se ven como construcciones válidas (por ejemplo, para desactivar comprobaciones importantes); asignar otros valores de cadena que conducen a fallos en la verificación de cadenas.
Por ejemplo, un atacante podría sugerir un cambio que incluya la línea: if access_level != 'user{U+202E} {U+2066}// Check if admin{U+2069} {U+2066}' {
que se mostrará en la interfaz para revisión como if access_level != 'user' { // Check if admin
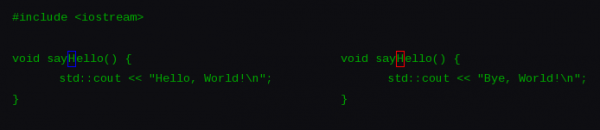
Adicionalmente, se ha propuesto otra variante de ataque (CVE-2021-42694) relacionada con el uso de homógrafos, caracteres que se parecen a nivel visual, pero que tienen diferentes significados y códigos unicode distintos (por ejemplo, el carácter 'ɑ' se parece a 'a', 'ɡ' a 'g', 'ɩ' a 'l'). Tales caracteres pueden ser utilizados en algunos lenguajes en los nombres de funciones y variables para confundir a los desarrolladores. Por ejemplo, pueden definirse dos funciones con nombres indistinguibles que realizan acciones diferentes. Sin un análisis detallado, no es evidente cuál de estas dos funciones se llama en un lugar específico.
Como medida de protección, se recomienda implementar en los compiladores, intérpretes y herramientas de construcción que soportan caracteres Unicode, la emisión de un error o advertencia ante la presencia de caracteres de control impares que cambian la dirección de la salida (U+202A, U+202B, U+202C, U+202D, U+202E, U+2066, U+2067, U+2068, U+2069, U+061C, U+200E y U+200F). Tales caracteres también deben ser explícitamente prohibidos en las especificaciones de los lenguajes de programación y deben ser considerados en los editores de código y las interfaces para trabajar con repositorios.
Apéndice 1: Se han preparado correcciones para eliminar la vulnerabilidad en GCC, LLVM/Clang, Rust, Go, Python y binutils. GitHub, Bitbucket y Jira también han solucionado el problema. Se está preparando una corrección para GitLab. Para detectar el código problemático, se ha propuesto usar el comando: grep -r $'[\u061C\u200E\u200F\u202A\u202B\u202C\u202D\u202E\u2066\u2067\u2068\u2069]' /path/to/source
Adición 2: Russ Cox, uno de los desarrolladores del sistema operativo Plan 9 y del lenguaje de programación Go, criticó la atención excesiva que se presta al método de ataque descrito, el cual ya es bien conocido (Go, Rust, C++, Ruby) y no se toma en serio. Según Cox, el problema se relaciona principalmente con la correcta visualización de la información en los editores de código y las interfaces web, que se aborda mediante el uso de herramientas y analizadores de código adecuados durante la revisión. Por lo tanto, en lugar de llamar la atención sobre ataques hipotéticos, sería más acertado centrarse en mejorar los procesos de revisión de código y dependencias.
Russ Cox también cree que los compiladores no son el lugar donde se debe solucionar el problema, ya que al prohibir símbolos peligrosos a nivel de compilador, sigue existiendo una gran cantidad de herramientas en las que el uso de dichos símbolos es aceptable, como sistemas de construcción, ensambladores, gestores de paquetes y diversos analizadores de configuración y datos. Por ejemplo, se menciona el proyecto Rust, que prohibió el procesamiento de código LTR/RTL en el compilador, pero no añadió una corrección en el gestor de paquetes Cargo, lo que permite realizar un ataque similar a través del archivo Cargo.toml. De manera similar, archivos como BUILD.bazel, CMakefile, Cargo.toml, Dockerfile, GNUmakefile, Makefile, go.mod, package.json, pom.xml y requirements.txt pueden ser fuentes de ataques.
Fuente: opennet.ru
