

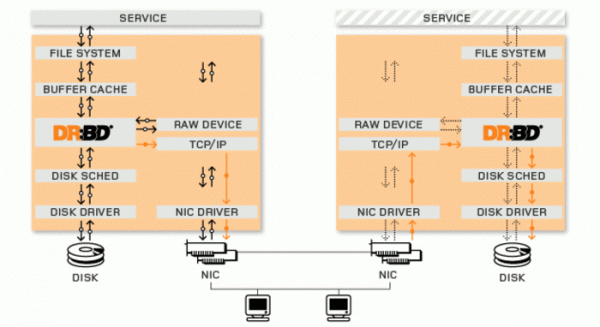
Se ha publicado la versión del dispositivo de bloques replicables distribuidos DRBD 9.2.0, que permite implementar una especie de matriz RAID-1 formada por varios discos de diferentes máquinas conectados por red (replicación a través de la red). El sistema está diseñado como un módulo para el núcleo de Linux y se distribuye bajo la licencia GPLv2. La rama drbd 9.2.0 se puede utilizar para reemplazar de manera transparente drbd 9.x.x y es completamente compatible a nivel de protocolo, archivos de configuración y utilidades.
DRBD permite combinar los dispositivos de los nodos de un clúster en un almacenamiento tolerante a fallos unificado. Para las aplicaciones y el sistema, este almacenamiento se presenta como un dispositivo de bloque idéntico para todos los sistemas. Al usar DRBD, todas las operaciones con el disco local se envían a otros nodos y se sincronizan con los discos de otras máquinas. En caso de fallo de un nodo, el almacenamiento continuará funcionando automáticamente gracias a los nodos restantes. Cuando el nodo fallido se vuelve a poner en línea, su estado se actualizará automáticamente a la versión más reciente.
El clúster que forma el almacenamiento puede incluir varias decenas de nodos, ubicados tanto en una red local como geográficamente dispersos en diferentes centros de datos. La sincronización en estos tipos de almacenamiento distribuidos se realiza utilizando tecnologías de red en malla (los datos se difunden en cadena de un nodo a otro). La replicación de nodos puede realizarse en modo síncrono o asíncrono. Por ejemplo, los nodos ubicados localmente pueden usar replicación síncrona, mientras que para despliegues remotos se puede aplicar replicación asíncrona con compresión y cifrado adicionales del tráfico.
En esta nueva versión:
- Se han reducido las latencias para las solicitudes de escritura replicadas. Una integración más cercana con la pila de red ha permitido disminuir el número de cambios de contexto del planificador.
- Se ha reducido la competencia entre las entradas/salidas de aplicaciones y las entradas/salidas de la re-sincronización mediante la optimización de bloqueos durante la re-sincronización de los extensos.
- Se ha aumentado considerablemente el rendimiento de la re-sincronización en los backends que utilizan asignación de espacio dinámica (‘thin provisioning’). Se logró incrementar el rendimiento gracias a la combinación de operaciones de trim/discard, que se ejecutan considerablemente más lentamente que las operaciones de escritura normales.
- Se ha agregado soporte para espacios de nombres de red (network namespaces), lo que permitió implementar la integración con Kubernetes para el tránsito del tráfico de replicación a través de una red separada vinculada a los contenedores, en lugar de la red del entorno host.
- Se ha añadido el módulo transport_rdma para ser utilizado como transporte Infiniband/RoCE en lugar de TCP/IP sobre Ethernet. La utilización de este nuevo transporte permite reducir las latencias, disminuir la carga del CPU y garantizar la obtención de datos sin operaciones de copia adicionales (zero-copy).
Fuente: opennet.ru
