

La empresa Stability AI ha publicado la segunda edición del sistema de aprendizaje automático Stable Diffusion, capaz de sintetizar y modificar imágenes en función de una plantilla propuesta o una descripción textual en lenguaje natural. El código de las herramientas para entrenar la red neuronal y generar imágenes está escrito en Python utilizando el marco PyTorch y se ha publicado bajo la licencia MIT. Los modelos ya entrenados están abiertos bajo la licencia permisiva Creative ML OpenRAIL-M, que permite su uso con fines comerciales. Además, está disponible un generador de imágenes online para demostración.
Mejoras clave en la nueva edición de Stable Diffusion:
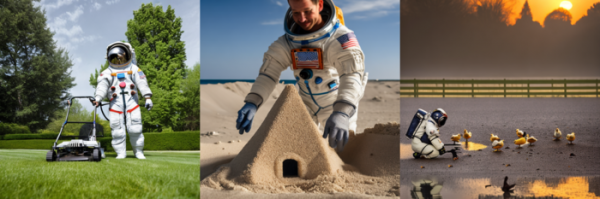
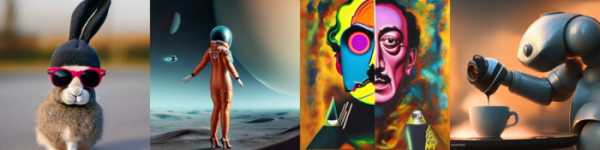
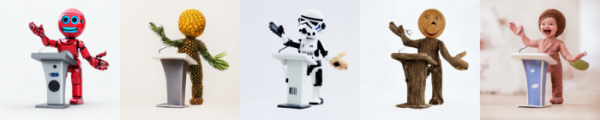
- Se ha creado un nuevo modelo de síntesis de imágenes a partir de descripciones de texto — SD2.0-v, que admite la generación de imágenes con una resolución de 768×768. El nuevo modelo ha sido entrenado utilizando la colección LAION-5B, que incluye 5.85 mil millones de imágenes con descripciones textuales. El modelo utiliza el mismo conjunto de parámetros que el modelo Stable Diffusion 1.5, pero se diferencia por la transición a un codificador OpenCLIP-ViT/H fundamentalmente diferente, lo que ha permitido mejorar significativamente la calidad de las imágenes resultantes.

- Se ha preparado una versión simplificada SD2.0-base, entrenada en imágenes de 256×256 utilizando un modelo clásico de predicción de ruido y que admite la generación de imágenes con una resolución de 512×512.

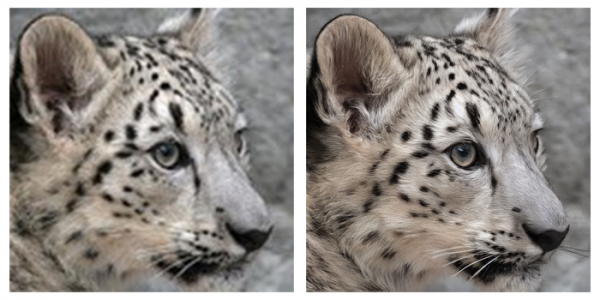
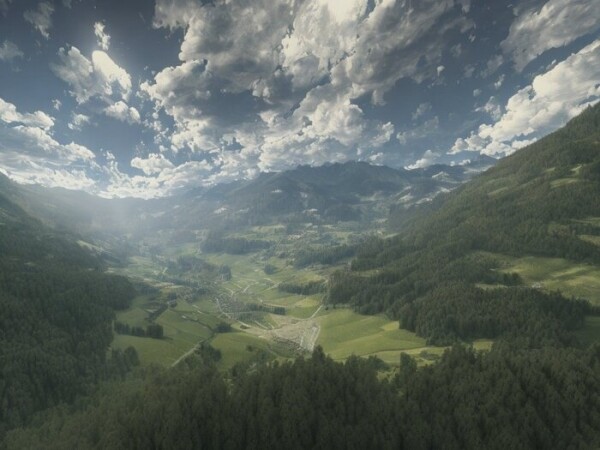
- Se ha proporcionado la posibilidad de usar la tecnología de supermuestreo (Super Resolution) para aumentar la resolución de la imagen original sin pérdida de calidad, utilizando algoritmos de escalado espacial y reconstrucción de detalles. El modelo de procesamiento de imágenes proporcionado (SD20-upscaler) admite un aumento de cuatro veces, lo que permite crear imágenes con una resolución de 2048×2048.

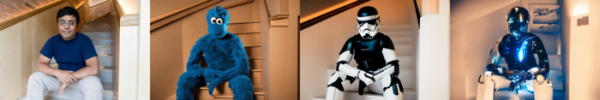
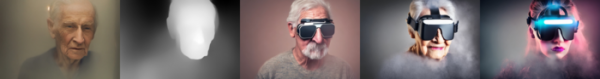
- Se ha propuesto el modelo SD2.0-depth2img, que tiene en cuenta la profundidad y la disposición espacial de los objetos. Para la evaluación monocular de la profundidad se utiliza el sistema MiDaS. El modelo permite sintetizar nuevas imágenes, utilizando otra imagen como plantilla, que pueden diferir drásticamente del original, pero que mantienen la composición general y la profundidad. Por ejemplo, se puede usar la postura de una persona en una fotografía para formar otro personaje en la misma postura.


- Se ha actualizado el modelo para la modificación de imágenes: SD 2.0-inpainting, que permite reemplazar y cambiar partes de la imagen mediante indicaciones textuales.
- Se han optimizado los modelos para su uso en sistemas convencionales con una sola GPU.
Fuente: opennet.ru
