

Las principales empresas dedicadas al desarrollo en el ámbito del aprendizaje automático han presentado el proyecto OpenXLA, orientado a desarrollar conjuntamente herramientas para la compilación y optimización de modelos para sistemas de aprendizaje automático. El proyecto acoge el desarrollo de herramientas que permiten unificar la compilación de modelos creados en los frameworks TensorFlow, PyTorch y JAX, para un entrenamiento y ejecución eficientes en diferentes GPU y aceleradores especializados. Se han unido al trabajo conjunto empresas como Google, NVIDIA, AMD, Intel, Meta, Apple, Arm, Alibaba y Amazon.
Se espera que, gracias a la colaboración de equipos de investigación líderes y representantes de la comunidad, se logre impulsar el desarrollo de sistemas de aprendizaje automático y resolver el problema de la fragmentación de la infraestructura para diferentes frameworks y hardware. OpenXLA permite implementar un soporte efectivo para diversos equipos, independientemente del framework en el que se haya creado el modelo de aprendizaje automático. Se espera que OpenXLA reduzca el tiempo de entrenamiento de los modelos, aumente el rendimiento, disminuya la latencia, reduzca los costos en recursos computacionales y acorte el tiempo de lanzamiento al mercado.
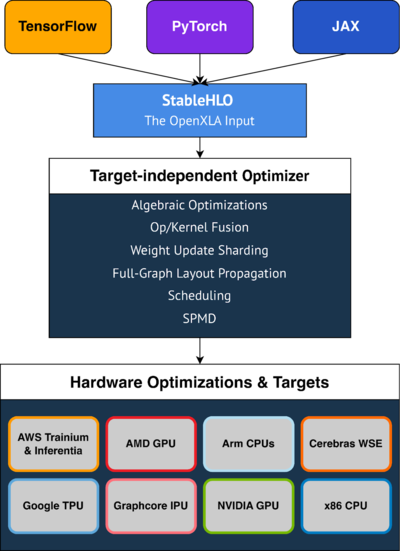
OpenXLA se compone de tres componentes principales, cuyo código se distribuye bajo la licencia Apache 2.0:
- XLA (Accelerated Linear Algebra) — un compilador que optimiza modelos de aprendizaje automático para su ejecución de alto rendimiento en diversas plataformas de hardware, incluyendo GPU, CPU y aceleradores especializados de diferentes fabricantes.
- StableHLO — especificación e implementación base de un conjunto de operaciones de alto nivel (HLO, High-Level Operations) para ser utilizadas en modelos de sistemas de aprendizaje automático. Actúa como una capa intermedia entre los frameworks de aprendizaje automático y los compiladores que transforman el modelo para su ejecución en hardware específico. Se han preparado capas para generar modelos en formato StableHLO para los frameworks PyTorch, TensorFlow y JAX. La base de StableHLO se ha construido sobre el conjunto MHLO, el cual se ha ampliado con soporte para serialización y versionado.
- IREE (Entorno de Ejecución de Representación Intermedia) — un compilador y runtime que transforma modelos de aprendizaje automático en una representación intermedia universal basada en el formato MLIR (Representación Intermedia de Múltiples Niveles) del proyecto LLVM. Entre sus características se destaca la posibilidad de compilación anticipada (ahead-of-time), soporte para el control de flujo, la capacidad de usar elementos dinámicos en los modelos y la optimización para diferentes CPU y GPU, con bajos recursos adicionales.
Principales ventajas de la herramienta OpenXLA:
- Lograr un rendimiento óptimo sin necesidad de profundizar en la escritura de código específico para dispositivos. Proporcionar optimizaciones listas que incluyen la simplificación de expresiones algebraicas, colocación eficiente en memoria y planificación de la ejecución con la consideración de la reducción del consumo máximo de memoria y sobrecargas.
- Simplificación del escalado y la paralelización de cálculos. El desarrollador solo necesita agregar anotaciones para un subconjunto de tensores críticos, sobre la base de las cuales el compilador puede generar automáticamente código para cálculos paralelos.
- Garantizar la portabilidad mediante el soporte de diversas plataformas de hardware, como GPU AMD y NVIDIA, CPU basadas en arquitecturas x86 y ARM, aceleradores de ML TPU de Google, IPU AWS Trainium e Inferentia, Graphcore y Cerebras Wafer-Scale Engine.
- Soporte para conectar extensiones con la implementación de capacidades adicionales, como el soporte para escribir primitivos de aprendizaje profundo utilizando CUDA, HIP, SYCL, Triton y otros lenguajes para cálculos paralelos. Posibilidad de ajustes manuales para corregir cuellos de botella en los modelos.
Fuente: opennet.ru
