

Está disponible la versión del proyecto Vortex 3.0, que desarrolla GPGPU abierto basado en la arquitectura de conjunto de instrucciones RISC-V, diseñado para llevar a cabo cálculos paralelos utilizando la API OpenCL y el modelo de ejecución SIMT (Single Instruction, Multiple Threads). El proyecto también se puede utilizar para investigaciones en gráficos 3D y para el desarrollo de nuevas arquitecturas de GPU. Los esquemas, descripciones de bloques de hardware en Verilog, simulador, controladores y documentación del proyecto se distribuyen bajo la licencia Apache 2.0.
La base del GPGPU es el ISA típico RISC-V, ampliado con instrucciones adicionales para soportar funciones de GPU y gestión de flujos. Los cambios en la arquitectura del conjunto de instrucciones RISC-V se han minimizado y se utilizan, siempre que sea posible, instrucciones vectoriales ya existentes. Entre las instrucciones adicionales se encuentran: «tex» para acelerar el procesamiento de texturas; vx_rast para gestionar la rasterización, vx_rop para procesar fragmentos, profundidad y transparencia; vx_imadd para realizar la operación «multiplicar y sumar»; vx_wspawn, vx_split, vx_join, vx_tmc y vx_bar para activar grupos de flujos (wavefronts) que se ejecutan en paralelo en el SIMD Engine.
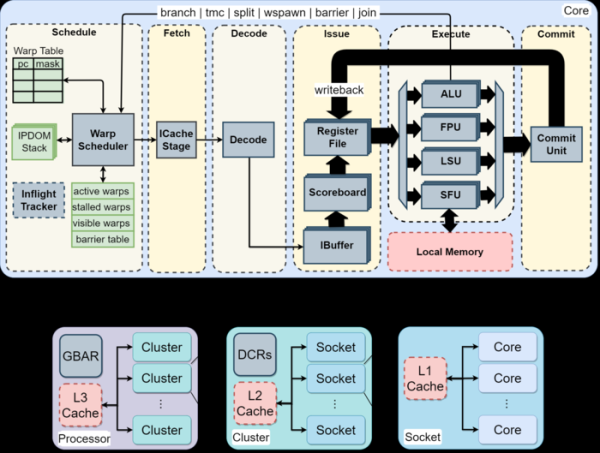
El GPGPU en desarrollo soporta arquitecturas de conjunto de instrucciones RISC-V de 32 y 64 bits, RV32IMF y RV64IMAFD, y puede incluir memoria compartida opcional, cachés de niveles L1, L2 y L3, así como un número configurable de núcleos, bloques de tareas (warps) y flujos. A su vez, para cada núcleo se prevé la posibilidad de incluir un número configurable de ALU, FPU, LSU y SFU. Se pueden utilizar FPGA de Xilinx y Altera para la creación de prototipos, y para la simulación del funcionamiento del chip se pueden emplear Verilator (simulador Verilog), RTLSIM (simulación RTL) y SimX (simulación de software).
Para el desarrollo de aplicaciones se ofrece un conjunto de herramientas, que incluye versiones adaptadas para trabajar con Vortex de PoCL (compilador y runtime de OpenCL), LLVM/Clang, GCC y Binutils. El proyecto soporta la especificación OpenCL 1.2 y a través de la traducción a OpenCL se implementa la compatibilidad con la representación intermedia de los sombreadores SPIR-V.
Entre los cambios en Vortex 3.0:
- Se ha añadido una pila gráfica de hardware, que incluye bloques para rasterización, superposición de texturas y fusión de salida (OM - Output Merger). Para Mesa, se ha preparado un controlador Vulkan vortexpipe basado en la pila gráfica implementada y el rasterizador de software lavapipe.
- Se han ampliado las capacidades del núcleo tensorial, diseñado para acelerar la ejecución de modelos de aprendizaje automático, que ahora implementa soporte para la esparsidad estructural (structured sparsity) para la compresión de matrices de pesos.
- Se ha implementado la operación WGMMA (multiplicación de matrices a nivel de grupo de hilos) para multiplicación de matrices de forma asincrónica.
- Se ha añadido el motor DXA (Aceleración de Transferencia de Datos) para acelerar la transmisión de datos de la memoria global a la local.
- Se ha realizado una nueva arquitectura basada en el procesador de comandos (CP, Command Processor) y un planificador de hardware de núcleos de cálculo (KMU — Kernel Management Unit), que permite delegar fuera del chip las operaciones de programación de flujos de cálculo.
- Se propone una nueva biblioteca de runtime, que opera en modo no bloqueante y proporciona abstracciones que se traducen en comandos ejecutables en hardware de manera asíncrona. Se soportan colas, eventos, módulos y sincronización basada en barreras asíncronas con semántica arrive/wait/event.
- Se ha agregado soporte para instrucciones acortadas de RISC-V (RVC).
- Se ha implementado soporte de hardware para operaciones atómicas (Hardware Atomics).
- Se ha rediseñado completamente la FPU y se han propuesto nuevos bloques multiplicadores (Wallace-tree, Folded-radix) y sumadores (Kogge-Stone).
- Se ha añadido una pila de memoria virtual basada en el controlador de memoria (MMU) con soporte para arquitectura de direccionamiento virtual de 32 bits SV32.
- Soporte para la extensión RISC-V Zicond con implementación de operaciones condicionales.
- Se ha integrado el control del reloj (clock gating).
- Se ha implementado soporte para el lenguaje HIP (Interfaz Heterogénea para Portabilidad) a través del marco chipStar, que traduce HIP a SPIR-V.
- Se asegura una integración completa con el simulador GEM5 y se ha añadido soporte para el simulador SimX en arquitectura TLM (Modelado a Nivel de Transacción).
- Se ha añadido soporte para las herramientas de Synopsys y Yosys para la síntesis de lógica para la producción de chips, así como soporte para el uso de bibliotecas de elementos estándar ASAP7 (7nm), SAED14 (14nm) y NanGate (15nm).
- El kit de herramientas de referencia se ha actualizado a LLVM 20 y POCL 7.0.
Fuente: opennet.ru
