

Me inspiró a hacer esta publicación .
Lo presento aquí:
hoy a las 18:53
Hoy me alegró el proveedor. Junto con la actualización del sistema de bloqueo de sitios, ha bloqueado el correo mail.ru. Desde la mañana estoy molestando al soporte técnico, no pueden hacer nada. El proveedor es pequeño y parece que están bloqueados por los proveedores superiores. También noté una desaceleración en la carga de todos los sitios, ¿quizás han implementado algún DLP defectuoso? Antes no había problemas de acceso. La destrucción de Runet está ocurriendo justo ante mis ojos...
El hecho es que, parece que nosotros somos ese proveedor 🙁
Y en efecto, casi adivinamos la razón de los problemas con mail.ru (aunque nos costó mucho creer en ello).
Lo que sigue estará dividido en dos partes:
- las razones de nuestros problemas actuales con mail.ru y una emocionante búsqueda para encontrarlas
- la existencia de los ISP en las realidades actuales, la estabilidad del Runet soberano.
Problemas de accesibilidad con mail.ru
Oh, es una historia bastante larga.
El hecho es que, para cumplir con los requisitos del gobierno (más detalles en la segunda parte), hemos adquirido, configurado e instalado cierto equipo — tanto para filtrar recursos prohibidos como para llevar a cabo de los abonados.
Hace algún tiempo, finalmente reconstruimos el núcleo de la red de tal manera que todo el tráfico de los abonados pasara a través de este equipo estrictamente en la dirección correcta.
Hace unos días activamos en él la filtración de contenido prohibido (al mismo tiempo manteniendo funcionando el sistema antiguo) — a simple vista todo salió bien.
Luego, gradualmente comenzamos a activar NAT en este equipo para diferentes partes de los abonados. A simple vista — también, todo parecía ir bien.
Pero hoy, al activar NAT en el equipo para otra parte de los abonados, desde por la mañana nos enfrentamos a una cantidad considerable de quejas sobre la inaccesibilidad o accesibilidad parcial de y otros recursos del Grupo Mail Ru.
Comenzamos a verificar: algo en algún lugar a veces, de vez en cuando envía en respuesta a solicitudes exclusivamente a las redes de mail.ru. Además, envía un TCP RST generado incorrectamente (sin ACK), claramente artificial. Así es como se veía:
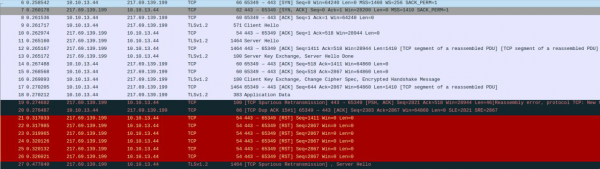
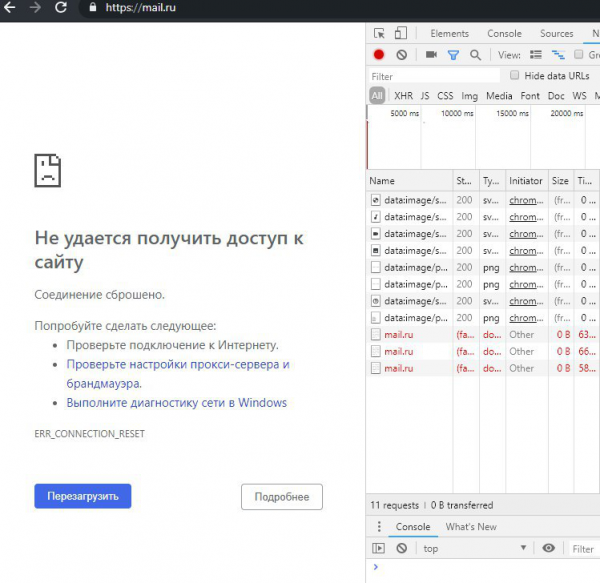
Naturalmente, los primeros pensamientos fueron sobre el nuevo equipo: un aterrador DPI, ninguna confianza en él, ¿quién sabe lo que podría hacer — ya que el TCP RST es algo bastante común entre las herramientas de bloqueo.
Suposición sobre si alguien 'superior' está filtrando, también lo planteamos, pero lo descartamos de inmediato.
En primer lugar, tenemos suficientes uplinks razonables para no sufrir de eso 🙂
En segundo lugar, estamos conectados a varios en Moscú, y el tráfico hacia mail.ru pasa precisamente a través de ellos, y no tienen ni obligaciones ni ningún otro motivo para filtrar el tráfico.
La siguiente mitad del día se gastó en lo que normalmente se llama chamanismo; junto con el proveedor del equipo, a quienes agradecemos, no nos abandonaron 🙂
- se desactivó completamente la filtración
- se desactivó NAT según un nuevo esquema
- la PC de prueba se trasladó a un grupo aislado
- cambió la direccionamiento IP
En la segunda mitad del día se asignó una máquina virtual que salía a la red como un usuario normal, y tanto ella como el equipo fueron accesibles para los representantes del proveedor. El chamanismo continuó 🙂
Finalmente, el representante del proveedor afirmó con confianza que el equipo no tenía nada que ver: los rst llegan de algún lugar superior.
NotaEn este punto, alguien podría argumentar: pero sería mucho más fácil tomar un volcado no desde la PC de prueba, sino desde la traza por encima del DPI?
No, desafortunadamente, tomar un volcado (e incluso simplemente hacer un mirror) de 40+ gbps no es nada trivial.
Después de eso, ya por la noche, no quedaba más remedio que regresar a la suposición de un extraño filtrado en algún lugar superior.
Verifiqué por qué IX estaba pasando el tráfico hacia las redes de MRG y simplemente apagué las sesiones bgp hacia él. Y — ¡oh milagro! — todo se normalizó de inmediato 🙁
Por un lado, es muy lamentable que se desperdiciara todo un día en la búsqueda del problema, cuando se resolvía en cinco minutos.
Por otro lado:
— en mi memoria, esto es algo sin precedentes. Como mencioné anteriormente, a los IXs realmente no les tiene sentido filtrar el tráfico de tránsito. Por lo general, tienen cientos de gigabits / terabits por segundo. Simplemente, hasta el último momento no podría suponer algo así en serio.
— una coincidencia increíblemente afortunada: un nuevo equipo complicado, en el que no hay mucha confianza y del que no está claro qué esperar, diseñado precisamente para bloquear recursos, incluidos los TCP RST
En este momento, el NOC de este intercambio de internet está buscando el problema. Según su afirmación (y les creo), no tienen ningún sistema de filtración implementado intencionalmente. Pero, gracias al cielo, la siguiente búsqueda ya no es nuestro problema 🙂
Fue un pequeño intento de disculparse, pedimos entender y perdonar 🙂
P.D.: No menciono ni al fabricante de DPI/NAT, ni a IX (de hecho, no tengo quejas en particular, lo principal es entender qué fue lo que sucedió)
La realidad de hoy (así como la de ayer y anteayer) desde el punto de vista de un proveedor de internet
Las últimas semanas las he pasado reestructurando significativamente el núcleo de la red, realizando un montón de manipulaciones "en vivo", con el riesgo de afectar considerablemente el tráfico de usuarios activo. Teniendo en cuenta los objetivos, resultados y las consecuencias de todo esto, moralmente ha sido bastante difícil. Especialmente al escuchar una vez más los discursos optimistas sobre la protección de la estabilidad de Runet, la soberanía, etc.
En esta sección intentaré contar sobre la "evolución" del núcleo de la red de un proveedor de internet típico en la última década.
Hace una década.
En esos tiempos benditos, el núcleo de la red del proveedor podía ser simple y fiable, como un corcho:
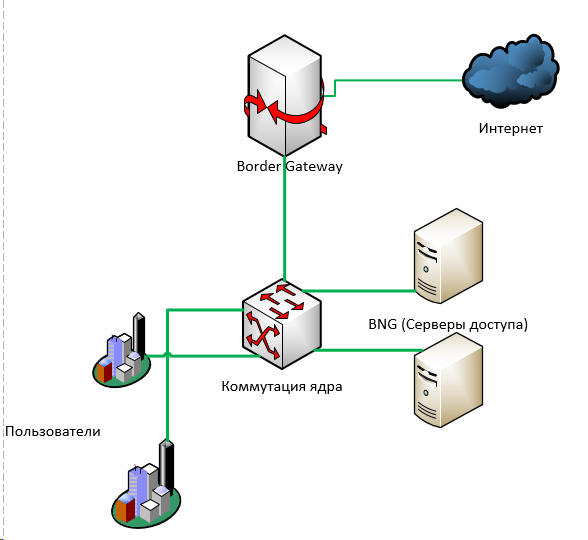
En esta imagen muy, muy simplificada faltan las autopistas, anillos, y el enrutamiento ip/mpls.
Lo esencial es que el tráfico de los usuarios en última instancia llegaba a la conmutación de nivel núcleo — de donde se dirigía a , desde donde, como regla general, regresaba a la conmutación de núcleo, y luego "salía" — a través de una o más puertas de enlace fronterizas hacia internet.
Este esquema es muy, muy fácil de redundar tanto en L3 (enrutamiento dinámico) como en L2 (MPLS).
Puedes poner N+1 de cualquier cosa: servidores de acceso, conmutadores, fronteras — y de una forma u otra hacerlos redundantes para el failover automático.
Después de unos años todos en Rusia se dieron cuenta de que así no se podía seguir viviendo: era necesario proteger urgentemente a los niños de la mala influencia de la red.
Surgió la necesidad de buscar urgentemente maneras de filtrar el tráfico de los usuarios.
Aquí hay diferentes enfoques.
En un caso no muy bueno, se coloca algo "en corte": entre el tráfico de usuarios y internet. El tráfico que pasa a través de este "algo" es analizado y, por ejemplo, se envía un paquete falso al abonado con un redireccionamiento.
En el mejor de los casos, si los volúmenes de tráfico lo permiten, se puede hacer un pequeño truco: enviar a filtrar solo el tráfico saliente de los usuarios hacia aquellas direcciones que necesitan ser filtradas (para esto se pueden tomar las direcciones IP indicadas en el registro o resolver adicionalmente los dominios en el registro).
En su momento, escribí un sencillo — aunque ni siquiera me atrevería a llamarlo así. Es muy simple y no muy eficiente; sin embargo, tanto a nosotros como a decenas (si no cientos) de otros proveedores nos permitió no gastar millones en sistemas DPI industriales de inmediato, sino que nos dio unos años adicionales.
Por cierto, sobre los DPI de entonces y los actualesCabe mencionar que muchos que compraron los sistemas DPI disponibles en el mercado en ese momento ya los deshecharon. No están diseñados para esto: cientos de miles de direcciones, decenas de miles de URL.
Al mismo tiempo, los fabricantes nacionales han crecido mucho en este mercado. No estoy hablando de la parte de hardware — aquí todo está claro — pero el software, lo más importante en un DPI, puede que hoy sea, si no el más avanzado del mundo, al menos a) se desarrolla a pasos agigantados y b) en términos de precios, simplemente no se puede comparar con los competidores extranjeros.
Me gustaría sentir orgullo, pero es un poco triste =)
Ahora todo se veía así:
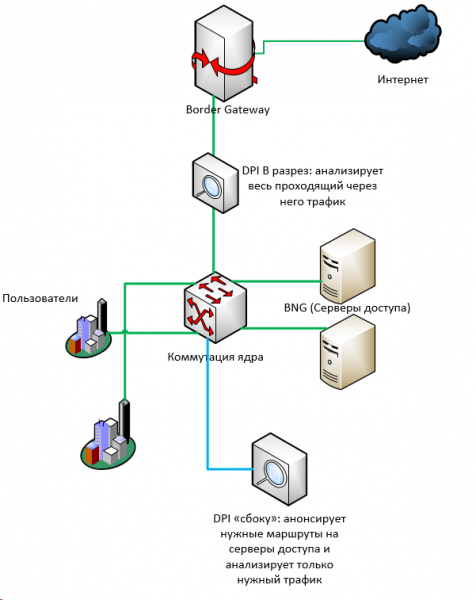
A los pocos años siguientes todos ya tenían revisores; los recursos en el registro aumentaban constantemente. Para cierto hardware antiguo (por ejemplo, Cisco 7600), el esquema de 'filtración lateral' se volvió inaplicable: el número de rutas en las plataformas 76 está limitado a alrededor de novecientas mil, mientras que el número de rutas IPv4 ya se acerca a las 800 mil. Y si además contamos con ipv6... ¿Y cuántos eran? ¿900,000 direcciones individuales en la lista negra de RKN? =)
Algunos pasaron al esquema de espejar todo el tráfico troncal en un servidor de filtrado, que debe analizar todo el flujo y, al detectar algo sospechoso, enviar RST en ambas direcciones (al remitente y al destinatario).
Sin embargo, cuanto mayor es el tráfico, menos aplicable es tal esquema. Con el más mínimo retraso en el procesamiento, el tráfico espejado simplemente pasará desapercibido, y el proveedor recibirá un aviso de multa.
Cada vez más proveedores se ven obligados a implementar sistemas DPI de diferentes niveles de confiabilidad a lo largo de las líneas de tránsito.
Hace uno o dos años se rumorea que prácticamente todos los FSB exigen la instalación real del equipo (anteriormente, la mayoría de los proveedores se conformaban con acordar con las autoridades el plan SORМ — plan de actividades operativas en caso de que sea necesario encontrar algo en algún lugar)
Además de dinero (no tan astronómico, pero aún así — millones), el SORМ exigió a muchos manipulaciones adicionales con la red.
- El SORМ necesita ver las direcciones "grises" de los usuarios, antes de la traducción NAT
- El SORМ tiene un número limitado de interfaces de red
Por lo tanto, en particular, tuvimos que reestructurar bastante una parte del núcleo — simplemente para recoger en un solo lugar el tráfico de los usuarios hacia los servidores de acceso. Para reflejarlo en el SORМ a través de varios enlaces.
Es decir, de manera muy simplificada, fue (izquierda) vs se convirtió (derecha):
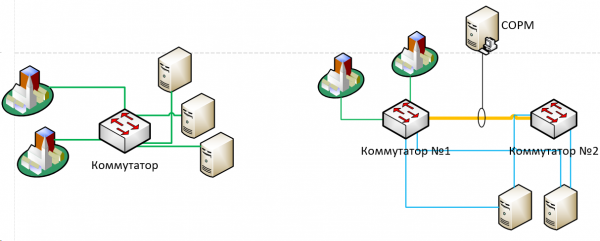
Ahora la mayoría de los proveedores también requieren la implementación de SORМ-3 — que incluye, entre otras cosas, el registro de traducciones NAT.
Con estos fines, en el esquema anterior tuvimos que añadir también equipo separado para NAT (precisamente lo que se menciona en la primera parte). Y añadirlo en un orden determinado: dado que el SORМ debe "ver" el tráfico antes de la traducción de direcciones — el tráfico debe fluir estrictamente de la siguiente manera: usuarios -> conmutación, núcleo -> servidores de acceso -> SORМ -> NAT -> conmutación, núcleo -> internet. Para ello, literalmente, tuvimos que "invertir" los flujos de tráfico en la otra dirección, lo cual también fue bastante complicado.
En total: en una década, el esquema del núcleo de un proveedor medio se ha complicado enormemente, y se ha incrementado significativamente el número de puntos de fallo adicionales (tanto en términos de hardware como de líneas de conmutación únicas). En realidad, la exigencia de "ver todo" implica concentrar este "todo" en un solo punto.
Me parece que esto se puede extrapolar de manera bastante transparente a las iniciativas actuales sobre la soberanía de Runet, su protección, estabilización y mejora 🙂
Y aún queda por delante Yarovaya.
Fuente: habr.com
