

A veces, para resolver un problema, solo es necesario mirarlo desde un ángulo diferente. Aunque en los últimos diez años se hayan abordado problemas similares de la misma manera con diferentes resultados, no significa que este método sea el único.
Hay un tema que se llama fuga de clientes. Es algo inevitable, porque los clientes de cualquier empresa pueden dejar de usar sus productos o servicios por múltiples razones. Por supuesto, para una empresa, la fuga, aunque natural, no es la acción más deseada, por lo que todos intentan minimizarla. Y aún mejor: predecir la probabilidad de fuga de determinada categoría de usuarios o de un usuario concreto y proponer acciones para retenerlos.
Es necesario analizar y tratar de retener al cliente, si es posible, por al menos las siguientes razones:
- la adquisición de nuevos clientes es más costosa que los procedimientos de retención. Para atraer nuevos clientes, generalmente se necesita invertir una cierta cantidad de dinero (publicidad), mientras que a los clientes existentes se les puede activar con una oferta especial con condiciones particulares;
- entender las razones de la salida de los clientes es clave para mejorar productos y servicios.
Existen enfoques estándar para pronosticar la fuga. Sin embargo, en uno de los campeonatos de IA decidimos intentar utilizar la distribución de Weibull para esto. Se utiliza principalmente para el análisis de supervivencia, pronóstico del clima, análisis de desastres naturales, en ingeniería industrial y temas similares. La distribución de Weibull es una función de distribución especial, parametrizada por dos parámetros  y
 .
Wikipedia
En general, es un tema interesante, pero para la predicción de la fuga, y en finanzas en general, no se utiliza tan a menudo. A continuación, contaremos cómo lo hicimos en el Laboratorio de Análisis de Datos Inteligentes, ganando además el oro en el Campeonato de Inteligencia Artificial en la categoría 'IA en bancos'.
Sobre la fuga en general
Vamos a aclarar un poco qué es la rotación de clientes y por qué es tan importante. Para un negocio, la base de clientes es crucial. En esta base entran nuevos clientes, que llegan a conocer el producto o servicio a través de publicidad, permanecen activos durante un tiempo (utilizando los productos) y, después de un tiempo, dejan de hacerlo. Este período se denomina "Ciclo de vida del cliente" (en inglés, Customer Lifecycle) — es un término que describe las etapas que atraviesa un cliente desde que conoce un producto, toma la decisión de comprar, paga, utiliza y se convierte en un consumidor leal, hasta que en última instancia deja de usarlo por diversas razones. Por lo tanto, la rotación es la etapa final del ciclo de vida del cliente, cuando el cliente deja de utilizar los servicios, lo que para el negocio significa que el cliente ha dejado de aportar ganancias y cualquier beneficio.
Cada cliente del banco es una persona concreta que elige una u otra tarjeta bancaria según sus necesidades. Si viaja con frecuencia, le vendrá bien una tarjeta con millas. Si compra mucho, ¡hola, tarjeta con cashback! Si compra mucho en tiendas específicas, ya existe un plástico asociado para eso. Por supuesto, a veces la tarjeta se elige también por el criterio de "el mantenimiento más barato". En resumen, hay muchas variables aquí.
Además, la persona elige el banco — ¿cuál es el sentido de elegir una tarjeta de un banco cuyas sucursales solo están en Moscú y sus alrededores, cuando tú eres de Jabarovsk? Aunque esa tarjeta sea dos veces más ventajosa, la proximidad de las sucursales del banco sigue siendo un criterio importante. Sí, 2019 ya está aquí y el digital es nuestro todo, pero hay ciertas cuestiones que algunos bancos solo se pueden resolver en la sucursal. Además, otra parte de la población confía mucho más en un banco físico que en una aplicación en su smartphone, lo cual también debe tenerse en cuenta.
Como consecuencia, puede haber muchas razones para abandonar los productos del banco (o al propio banco). Cambié de trabajo, y la tarifa de la tarjeta cambió de "salario" a "para mortales", que es menos ventajosa. Me mudé a otra ciudad donde no hay sucursales del banco. No me gustó la interacción con un cajero no cualificado en la sucursal. Es decir, puede haber muchas más razones para cerrar una cuenta que para usar un producto.
Además, el cliente puede no solo expresar explícitamente su intención de acudir al banco y presentar una solicitud, sino simplemente dejar de utilizar los productos sin cancelar el contrato. Para comprender tareas como esta, se decidió utilizar el aprendizaje automático y la inteligencia artificial.
Además, la pérdida de clientes puede ocurrir en cualquier sector (telecomunicaciones, proveedores de Internet, compañías de seguros, en general, donde haya una base de clientes y transacciones periódicas).
Lo que hicimos
Primero que nada, es necesario definir un límite claro: desde qué momento comenzamos a considerar que un cliente se ha ido. Desde el punto de vista del banco que nos proporcionó los datos para trabajar, el estado de actividad del cliente era binario: o estaba activo o no. Había un indicador ACTIVE_FLAG en la tabla de 'Actividad', cuyo valor podía ser '0' o '1' (respectivamente, 'Inactivo' y 'Activo'). Y todo estaría bien, pero las personas pueden utilizar un servicio activamente durante un tiempo y luego caer en inactividad durante un mes: pueden enfermar, irse a otro país de vacaciones, o incluso probar la tarjeta de otro banco. O pueden volver a utilizar los servicios del banco después de un largo período de inactividad.
Por lo tanto, decidimos llamar a un período de inactividad un intervalo continuo de tiempo durante el cual el indicador se establecía en '0'.
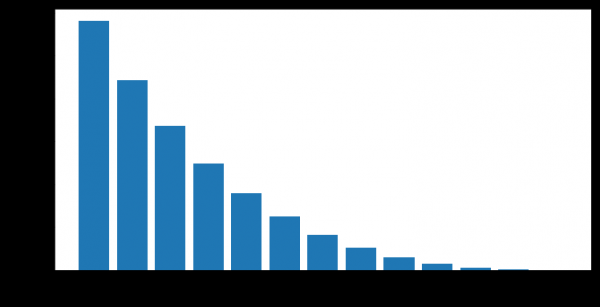
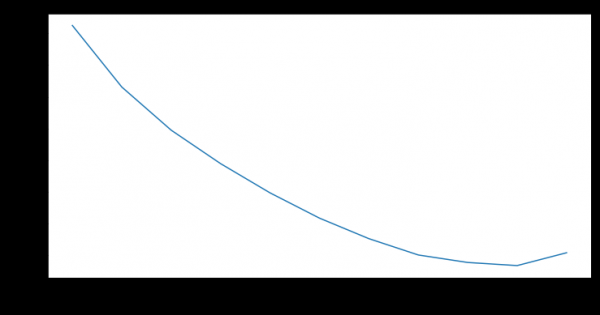
Los clientes pasan de inactivos a activos después de períodos de inactividad de diversas longitudes. Tenemos la oportunidad de calcular el grado de la magnitud empírica 'fiabilidad de los períodos de inactividad' — es decir, la probabilidad de que una persona vuelva a utilizar los productos del banco después de un período de inactividad.
Por ejemplo, en este gráfico se muestra la reactivación de la actividad (ACTIVE_FLAG=1) de los clientes después de varios meses de inactividad (ACTIVE_FLAG=0).
Aquí vamos a detallar un poco el conjunto de datos con el que comenzamos a trabajar. Entonces, el banco proporcionó información agregada durante 19 meses en las siguientes tablas:
- ‘Actividad’ — transacciones mensuales de clientes (a través de tarjetas, en la banca en línea y banca móvil), incluyendo depósitos salariales e información sobre los movimientos.
- ‘Tarjetas’ — datos sobre todas las tarjetas que tiene el cliente, con una detallada lista de tarifas.
- «Contratos» — información sobre los contratos del cliente (tanto abiertos como cerrados): créditos, depósitos y demás, con la indicación de los parámetros de cada uno.
- «Clientes» — conjunto de datos demográficos (sexo y edad) y disponibilidad de datos de contacto.
Para nuestra labor, necesitábamos todas las tablas, excepto «Tarjetas».
La complejidad aquí radicaba en que el banco no indicaba qué tipo de actividad se había llevado a cabo con las tarjetas. Es decir, podíamos saber si hubo transacciones o no, pero no podíamos determinar su tipo. Por lo tanto, no estaba claro si el cliente retiró efectivo, recibió su salario o gastó dinero en compras. Además, no teníamos datos sobre los saldos en las cuentas, lo cual habría sido útil.
La muestra en sí no estaba sesgada: en este corte, durante 19 meses, el banco no realizó ningún intento por retener clientes ni minimizar la fuga.
Así que, sobre los períodos de inactividad.
Para formular la definición de fuga, se debe elegir un período de inactividad. Para crear un pronóstico de fuga en un momento dado,  , se debe tener un historial de clientes de al menos 3 meses en el intervalo
 . Nuestro historial estaba limitado a 19 meses, por lo que decidimos tomar un período de inactividad de 6 meses, si existía. Y para el período mínimo para un pronóstico de calidad, tomamos 3 meses. Los números de 3 y 6 meses los tomamos empíricamente basándonos en el análisis del comportamiento de esos clientes.
Definimos la fuga de la siguiente manera: el mes de fuga del cliente  es el primer mes con ACTIVE_FLAG=0, donde desde ese mes hay al menos seis ceros consecutivos en el campo ACTIVE_FLAG, en otras palabras, el mes desde el cual el cliente estuvo 6 meses inactivo.
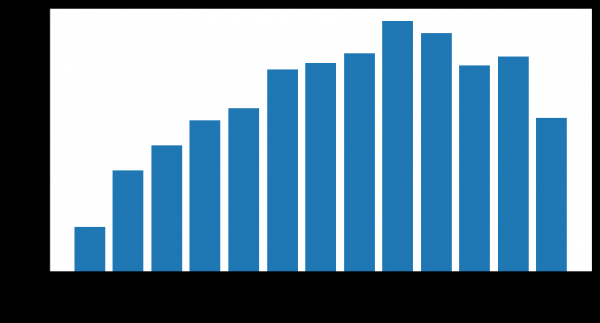
Número de clientes que se fueron
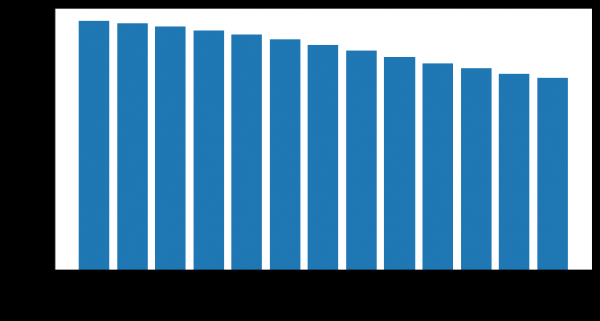
Número de clientes que permanecieron
Como se considera normalmente la fuga
En competiciones similares, y en general en la práctica, la fuga se pronostica con bastante frecuencia de esta manera. El cliente utiliza productos y servicios en diferentes intervalos de tiempo, los datos sobre su interacción se presentan en forma de un vector de características de longitud fija n. Frecuentemente, esta información incluye:
- Datos que caracterizan al usuario (datos demográficos, segmento de mercado).
- Historial de uso de productos y servicios bancarios (son acciones de los clientes que siempre están vinculadas a un momento específico o al periodo del intervalo que necesitamos).
- Datos externos, si se pudieron obtener, por ejemplo, opiniones de redes sociales.
Y ya después de esto, se emite una definición de abandono, adaptada a cada tarea. Luego utilizan un algoritmo de aprendizaje automático que predice la probabilidad de que el cliente se vaya.  basado en el vector de factores.
 . Para entrenar el algoritmo, se utiliza uno de los marcos conocidos para construir conjuntos de árboles de decisión, , , o sus modificaciones.
El algoritmo en sí no es malo, pero en lo que respecta a la predicción de abandono, tiene varios inconvenientes serios.
- No posee lo que se llama "memoria".. En la entrada del modelo llega un número determinado de características que corresponden al momento actual. Para incluir información sobre la historia de los cambios de parámetros, es necesario calcular características especiales que caracterizan los cambios de parámetros a lo largo del tiempo, como el número o la suma de transacciones bancarias durante los últimos 1, 2, 3 meses. Este enfoque solo puede reflejar parcialmente la naturaleza de los cambios temporales.
- Horizonte de predicción fijo. El modelo solo puede predecir el abandono de clientes para un intervalo de tiempo previamente establecido, por ejemplo, una predicción para un mes adelante. Si se requiere una predicción para otro intervalo de tiempo, como tres meses, es necesario reestructurar la muestra de entrenamiento y volver a entrenar un nuevo modelo.
Nuestro enfoque.
Decidimos desde el principio que no usaríamos enfoques estándar. En el campeonato, además de nosotros, se registraron otras 497 personas, cada una con una sólida experiencia. Así que intentar hacer algo según el esquema estándar en tales condiciones no es la mejor idea.
Y comenzamos a resolver los problemas planteados ante el modelo de clasificación binaria mediante la predicción de la distribución probabilística del tiempo de abandono de los clientes. Este enfoque puede ser visto, permite predecir el abandono de manera más flexible y probar hipótesis más complejas que en el enfoque clásico. Como familia de distribuciones modelando el tiempo de abandono, elegimos la distribución por su amplio uso en el análisis de supervivencia. El comportamiento del cliente puede considerarse como una especie de supervivencia.
Aquí hay ejemplos de la distribución de densidades de probabilidad de Weibull dependiendo de sus parámetros.  y
 :
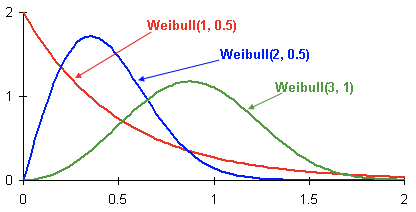
Esta es la densidad de distribución de probabilidad de fuga de clientes de tres clientes diferentes a lo largo del tiempo. El tiempo se presenta en meses. En otras palabras, este gráfico muestra cuándo es más probable que ocurra la fuga de un cliente en los próximos dos meses. Como se puede ver, el cliente con esta distribución tiene un mayor potencial de abandonar antes que los clientes con distribuciones Weibull(2, 0.5) y Weibull(3,1).
En resumen, se obtiene un modelo que predice para cada cliente, en cualquier
mes, los parámetros de la distribución de Weibull que mejor reflejan la probabilidad de fuga a lo largo del tiempo. En detalle:
- Las características objetivo en el conjunto de datos de entrenamiento son el tiempo restante hasta la fuga en un mes específico para un cliente determinado.
- Si no hay un indicador de fuga para un cliente, suponemos que el tiempo de fuga es mayor que el número de meses desde el actual hasta el final de la historia que tenemos.
- Modelo utilizado: red neuronal recurrente con capa LSTM.
- Como función de pérdida, utilizamos la función logarítmica negativa de verosimilitud para la distribución de Weibull.
Aquí están las ventajas de este método:
- La distribución de probabilidad, además de la obvia posibilidad de clasificación binaria, permite predecir eventos diversos, por ejemplo, si un cliente dejará de utilizar los servicios del banco en un plazo de 3 meses. Además, si es necesario, se pueden promediar diferentes métricas utilizando esta distribución.
- La red neuronal recurrente LSTM tiene memoria y utiliza eficazmente toda la historia disponible. Con la ampliación o refinamiento de la historia, la precisión aumenta.
- El enfoque se puede escalar fácilmente al dividir los intervalos de tiempo en segmentos más pequeños (por ejemplo, al dividir los meses en semanas).
Pero no basta con crear un buen modelo; también es necesario evaluar su calidad adecuadamente.
Cómo evaluamos la calidad
Como métrica, elegimos la Curva de Lift. Se utiliza en el negocio para tales casos debido a su interpretación clara, está bien descrita. y Si se describe el significado de esta métrica en una frase, sería: «¿Cuántas veces el algoritmo hace una mejor predicción en los primeros  % que al azar?»
Entrenamos los modelos.
Las condiciones del concurso no establecían una métrica de calidad específica para comparar diferentes modelos y enfoques. Además, la definición del concepto de deserción puede variar y depender de los objetivos comerciales definidos. Por lo tanto, para entender qué método es mejor, entrenamos dos modelos:
- Enfoque común de clasificación binaria utilizando el algoritmo de aprendizaje automático de un conjunto de árboles de decisión ();
- Modelo Weibull-LSTM
La muestra de prueba consistió en 500 clientes preseleccionados que no estaban en el conjunto de entrenamiento. Se realizaron ajustes de hiperparámetros para el modelo utilizando validación cruzada basada en clientes. Se utilizaron conjuntos de características idénticos para el entrenamiento de cada modelo.
Debido a que el modelo no tiene memoria, se tomaron características especiales que mostraban la relación entre el cambio de parámetros de un mes con el valor medio de los parámetros en los últimos tres meses. Esto caracterizaba la velocidad de cambio de los valores en el último período de tres meses. Sin esto, el modelo basado en Random Forest estaría en una desventaja anticipada en relación con Weibull-LSTM.
Por qué el LSTM con distribución Weibull es mejor que el enfoque basado en un conjunto de árboles de decisión
Aquí todo es evidente con solo un par de imágenes.
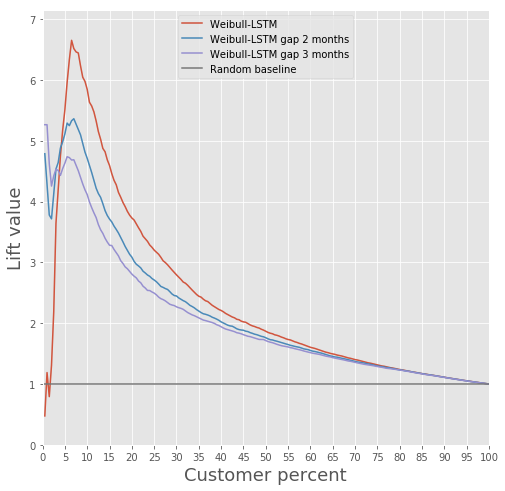
Comparación de la Curva Lift para el algoritmo clásico y Weibull-LSTM
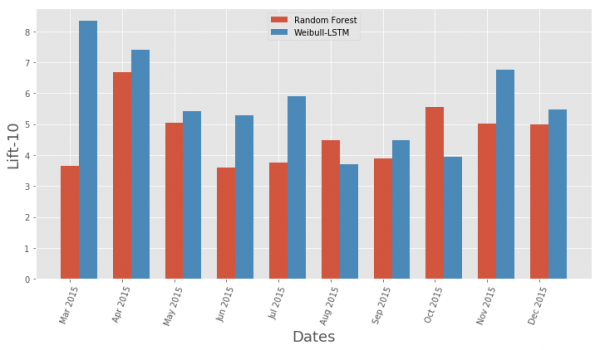
Comparación de la métrica de la Curva Lift por meses para el algoritmo clásico y Weibull-LSTM
En general, LSTM supera al algoritmo clásico casi en todos los casos.
Predicción de deserción
Un modelo basado en una red neuronal recurrente con celdas LSTM con distribución Weibull puede predecir la deserción anticipadamente, por ejemplo, predecir la partida de un cliente dentro de los próximos n meses. Consideremos el caso de n = 3. En este caso, la red neuronal debe determinar correctamente: si el cliente se irá, comenzando desde el próximo mes y hasta el mes n. En otras palabras, debe determinar correctamente si el cliente permanecerá después de n meses. Esto puede considerarse una predicción anticipada: prever el momento en que un cliente comienza a pensar en irse.
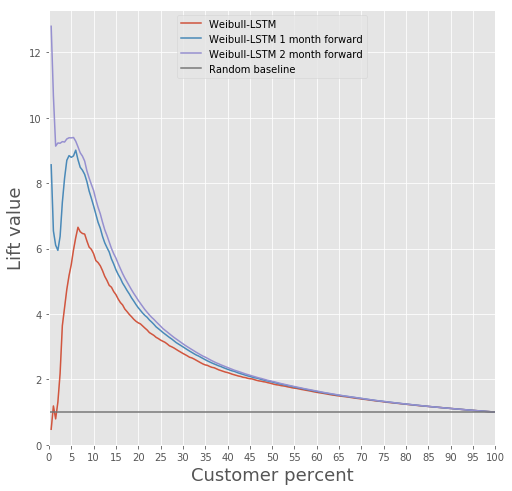
Comparamos la Curva Lift para Weibull-LSTM 1, 2 y 3 meses antes de la deserción:
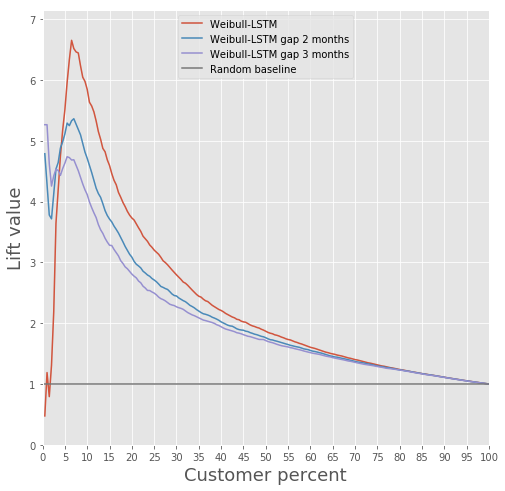
Como ya mencionamos anteriormente, también son importantes las predicciones realizadas para los clientes que se vuelven inactivos durante un tiempo. Por lo tanto, aquí agregaremos a la muestra tales casos en los que un cliente que se fue ya había estado inactivo durante uno o dos meses, y verificaremos que Weibull-LSTM clasifique correctamente tales casos como pérdida de clientes. Dado que tales casos estaban presentes en la muestra, esperamos que la red los maneje bien:
Retención de clientes
En realidad, esto es lo más importante que se puede hacer al tener información de que ciertos clientes están a punto de dejar de usar el producto. Hablando sobre la creación de un modelo que podría ofrecer algo útil a los clientes para retenerlos, esto no se podrá lograr si no tienes un historial de intentos similares que hayan terminado bien.
No teníamos tal historia, por lo que decidimos hacerlo así.
- Construimos un modelo que determina productos interesantes para cada cliente.
- Cada mes ejecutamos el clasificador y determinamos clientes potencialmente salientes.
- A algunas partes de los clientes les ofrecemos un producto, de acuerdo con el modelo del punto 1, recordamos nuestras acciones.
- Después de unos meses, vemos quién de estos clientes potencialmente salientes se ha ido y quién se ha quedado. De esta manera, formamos un conjunto de datos de entrenamiento.
- Entrenamos el modelo con la historia obtenida en el punto 4.
- Opcionalmente, repetimos el procedimiento reemplazando el modelo del punto 1 con el modelo obtenido en el punto 5.
La verificación de la calidad de tal retención puede ser un A/B testing tradicional: dividimos a los clientes que están potencialmente saliendo en dos grupos. A uno le ofrecemos productos basados en nuestro modelo de retención, y al otro no le ofrecemos nada. Decidimos entrenar un modelo que podría ser beneficioso ya en el punto 1 de nuestro ejemplo.
Queríamos hacer la segmentación lo más interpretativa posible. Para ello, seleccionamos algunas características que pudieran ser fácilmente interpretables: el número total de transacciones, el salario, el volumen total de la cuenta, la edad, el género. Las características de la tabla "Tarjetas" no se tomaron en cuenta debido a que son poco informativas, y las características de la tabla 3 "Contratos" se descartaron por la complejidad de su procesamiento para evitar filtraciones de datos entre el conjunto de validación y el conjunto de entrenamiento.
La clustering se realizó utilizando modelos de mezcla gaussianos. El criterio de información de Akaike permitió identificar 2 óptimos. El primer óptimo corresponde a 1 clúster. El segundo óptimo, menos pronunciado, corresponde a 80 clústeres. A partir de este resultado, se puede concluir que los datos son extremadamente difíciles de dividir en clústeres sin información apriorística. Para una mejor clasificación, se necesitan datos que describan detalladamente a cada cliente.
Por lo tanto, se consideró la tarea de aprendizaje supervisado, para ofrecer a cada cliente un producto específico. Se contemplaron los siguientes productos: "Depósito a plazo", "Tarjeta de crédito", "Descubierto", "Crédito al consumo", "Crédito automotriz", "Hipoteca".
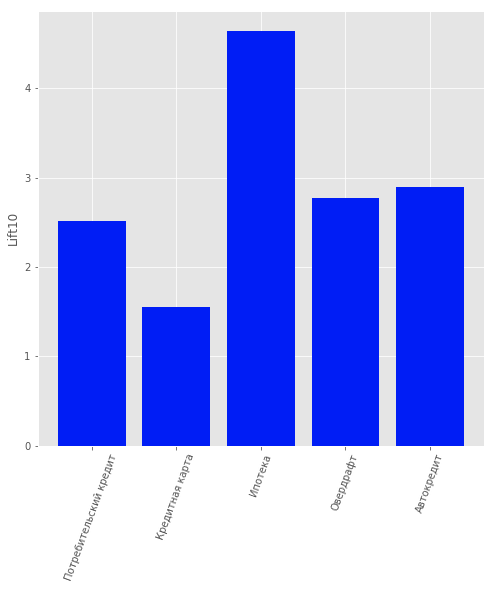
En los datos también había otro tipo de producto: "Cuenta corriente". Pero no lo consideramos debido a su escasa informatividad. Se construyó un modelo basado en los usuarios que son clientes del banco, es decir, aquellos que no han dejado de utilizar sus productos, el cual predice qué producto puede ser de su interés. Se eligió la regresión logística como modelo, y como métrica para evaluar la calidad se utilizó el valor de Lift para los primeros 10 percentiles.
La calidad del modelo se puede evaluar en la figura.
Resultados del modelo de recomendación de productos para clientes
Summary
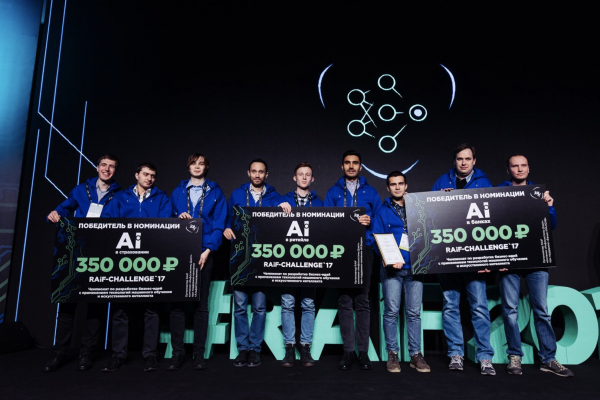
Este enfoque nos valió el primer lugar en la categoría "IA en bancos" en el Campeonato de IA RAIF-Challenge 2017.
Aparentemente, lo principal era abordar el problema desde un ángulo poco convencional y utilizar un método que se suele aplicar en otras situaciones.
Aunque la fuga masiva de usuarios puede ser un desastre natural para los servicios.
Este método se puede tener en cuenta también para cualquier otro ámbito en el que sea importante considerar la fuga, no solo para bancos. Por ejemplo, lo utilizamos para calcular nuestra propia fuga en las filiales de Siberia y San Petersburgo de Rostelecom.
"Laboratorio de análisis inteligente de datos" empresa "Portal de búsqueda Spudnik"
Fuente: habr.com
