

Los algoritmos RAID fueron presentados al público en 1987. Hasta hoy, siguen siendo la tecnología más demandada para la protección y aceleración del acceso a datos en el ámbito del almacenamiento de información. Sin embargo, la edad de esta tecnología de IT, que ha superado los 30 años, no representa madurez, sino más bien vejez. La razón es el progreso, que implacablemente trae nuevas posibilidades. En tiempos en que prácticamente no había otros dispositivos de almacenamiento aparte de los HDD, los algoritmos RAID permitieron utilizar de manera más efectiva los recursos de almacenamiento disponibles. Sin embargo, con la llegada de los SSD, la situación cambió radicalmente. Ahora, el RAID al trabajar con unidades de estado sólido se ha convertido en un 'estrangulador' de su rendimiento. Por lo tanto, para liberar el pleno potencial de velocidad de los SSD, se requiere un enfoque completamente diferente en su manejo.
Además de las diferencias evidentes entre HDD y SSD en los principios de funcionamiento, estos tipos de medios tienen otra característica importante: cualquier disco duro puede sobrescribir cualquier dato con una granularidad de un bloque (que actualmente suele ser de 4KB). En el caso de los SSD, el proceso de sobrescritura es una procedimiento mucho más complicado:
- Los datos modificados se copian a una nueva ubicación. La granularidad sigue siendo el mismo bloque, pero consiste en varias páginas y tiene un tamaño de entre 256KB y 4MB. Es decir, al modificar esos mismos 4KB, es necesario copiar también todas las páginas adyacentes que forman un solo bloque.
- Los 'bloques viejos' se marcan como no utilizados para luego ser borrados por el recolector de 'basura' (Garbage Collector).
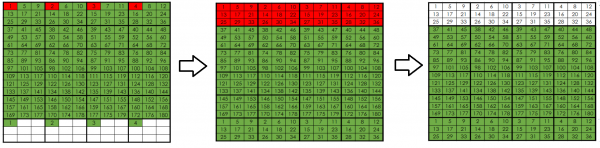
Escritura/sobrescritura secuencial en SSD
En el caso de la escritura/sobrescritura secuencial, esta característica en el funcionamiento del SSD no juega un gran papel en términos de rendimiento, ya que los bloques están cerca unos de otros y el recolector de 'basura' puede manejar su trabajo en segundo plano. Sin embargo, en la vida real, y especialmente en el segmento empresarial, los SSD suelen ser utilizados para acceso aleatorio a datos. Y esos datos se escriben en ubicaciones arbitrarias en las unidades.
Cuanto más datos se escriben en un SSD, más difícil es para el recolector de "basura" trabajar, ya que la fragmentación aumenta significativamente. Como resultado, llega un momento en que el proceso de limpieza del almacenamiento deja de ser "en segundo plano": el rendimiento del SSD cae drásticamente, ya que una parte notable de este es absorbida por el recolector de basura.
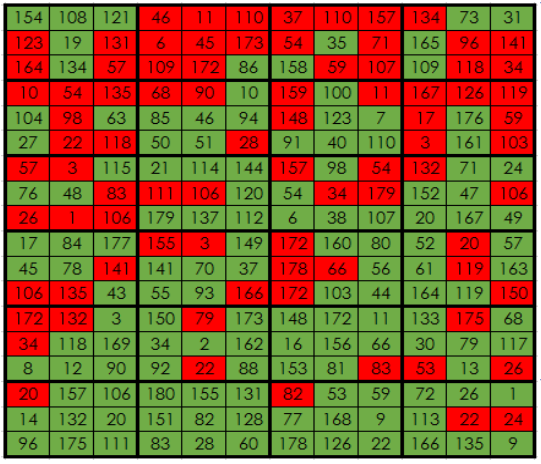
La ubicación real de los datos en el SSD durante el uso diario
Para ilustrar el efecto del funcionamiento del recolector de "basura" en función del modo de escritura en el almacenamiento, se pueden realizar pruebas sencillas: escritura secuencial y aleatoria de bloques de 4KB en un SSD de 100GB. (Fuente – compañía )
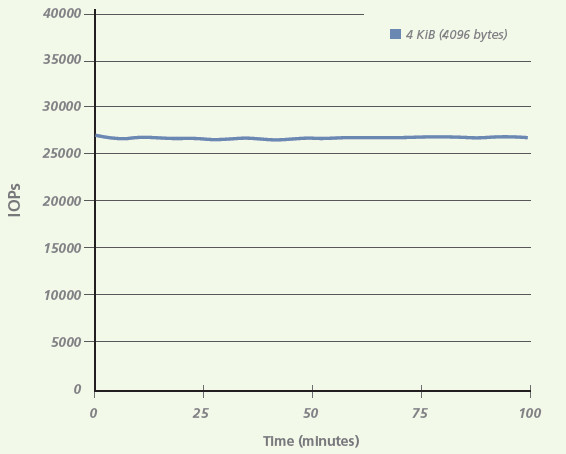
Rendimiento en escritura secuencial
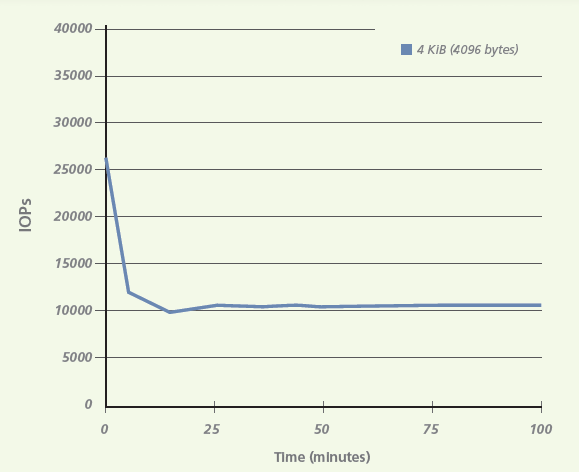
Rendimiento en escritura aleatoria
Como se puede ver en las pruebas, la caída del rendimiento puede alcanzar más de dos veces. Y esto es solo con un único dispositivo de almacenamiento. En caso de utilizar SSD en un grupo RAID, la cantidad de operaciones de sobrescritura aumenta considerablemente debido al trabajo con paridad.
En general, gracias a estas características de funcionamiento de los SSD, existe un parámetro llamado coeficiente de escritura (write amplification). Este es la relación entre el volumen de datos escritos en el dispositivo de almacenamiento y el volumen de datos que realmente envió el host. Y para el RAID5 más popular, este coeficiente es de aproximadamente 3.5.
Como resultado, los sistemas con RAID clásico en su esencia utilizan solo aproximadamente el 10% de la velocidad real de los SSD y escalan débilmente en rendimiento al aumentar el número de dispositivos de almacenamiento a más de una docena.
También es importante destacar que las operaciones de escritura excesivas no solo reducen el rendimiento de los SSD, sino que también disminuyen su recurso no infinito, acortando así la vida útil del dispositivo de almacenamiento.
, que es el núcleo de todos los productos AccelStor, ha sido diseñada precisamente como una alternativa a los algoritmos RAID clásicos al trabajar con SSD. La innovación de la tecnología ha sido reconocida con diversas patentes y premios (incluido en el Flash Memory Summit 2016), así como por los resultados de pruebas independientes (por ejemplo, SPC1).
Esencia se basa en la conversión de todas las solicitudes de escritura entrantes, principalmente del tipo aleatorio, en un conjunto de bloques que se asemejan lo más posible a un modo de escritura secuencial desde la perspectiva del almacenamiento. Como resultado, la escritura en SSD se lleva a cabo en la forma más cómoda para ellos, y el rendimiento final supera a cualquier sistema con RAID clásico.
Todos los SSD en los sistemas AccelStor se dividen en dos grupos simétricos FlexiRemap®. El tamaño del grupo depende del modelo y varía de 5 a 11 unidades. Para garantizar la resistencia a fallos dentro del grupo, se aplica paridad similar a RAID5. Ambos grupos se utilizan conjuntamente, formando un espacio de almacenamiento común. Por lo tanto, la resistencia final a fallos será similar a la de un arreglo RAID50 compuesto por dos grupos: el sistema puede tolerar la falla de hasta dos SSD, pero no más de uno en cada grupo FlexiRemap®.
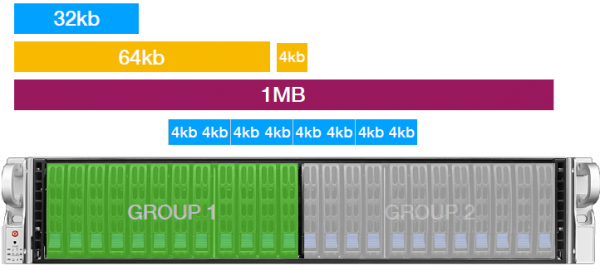
Todas las solicitudes de escritura entrantes se dividen en bloques de 4KB, que se escriben en un modo round robin en ambos grupos FlexiRemap®. Al mismo tiempo, el sistema lleva un registro constante de la demanda de los bloques escritos, tratando de grabar bloques similares lo más cerca posible unos de otros cuando cambian. Esto resulta en un análogo virtual de striping, si se expresa en términos de almacenamiento. En este caso, el trabajo del recolector de ‘basura’ se facilita considerablemente: los bloques no utilizados se mantendrán continuamente cerca unos de otros.
Cabe mencionar que a diferencia de los productos de la competencia, no utilizan la funcionalidad de almacenamiento en caché de las solicitudes entrantes en la memoria RAM del controlador. Todos los bloques de datos entrantes se escriben de inmediato en el SSD. El host recibe confirmación de que la escritura fue exitosa solo después de que los datos se han colocado físicamente en los dispositivos de almacenamiento. En la RAM solo se almacenan tablas de ubicación de bloques en el SSD para acelerar el acceso y determinar dónde escribir el siguiente bloque de datos. Por supuesto, para mayor seguridad, copias de estas tablas también se encuentran en los propios medios. Como resultado, los sistemas AccelStor no requieren ninguna protección del caché en forma de batería/capacitor (aunque existe la posibilidad de establecer una conexión con un SAI – para un
Gracias a este enfoque en la organización de la escritura, el recolector de "basura" realmente puede operar en segundo plano sin tener un impacto significativo en la velocidad de los discos, lo que finalmente permite a la sistema reutilizar hasta el 90% del rendimiento de los SSD. Es en esto donde radica el alto rendimiento de IOPS en los sistemas de AccelStor comparado con All Flash, que se basan en algoritmos RAID.
Otra característica importante de la tecnología FlexiRemap® es la reducción significativa de las operaciones de escritura redundantes en los SSD. Así, el coeficiente de escritura (write amplification) para los sistemas de AccelStor es de solo 1.3, lo que en términos comunes significa un aumento de la vida útil de los discos en comparación con RAID5 de más de 2.5 veces.
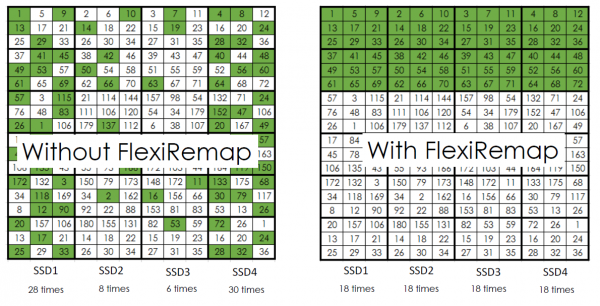
Gracias al monitoreo constante del sistema sobre la política de colocación de datos en los SSD, todos los discos se desgastan de manera uniforme. Este enfoque permite prever su vida útil y alertar anticipadamente al administrador sobre el agotamiento de recursos de escritura.
Es evidente que los SSD pueden fallar. En tal caso, el sistema comenzará de inmediato el rebuildeo en uno de los discos hot spare. En este proceso, el grupo FlexiRemap®, que se encuentra en estado degradado, pasa a modo "solo lectura", y todas las solicitudes de escritura se dirigen al segundo grupo. Este mecanismo de protección está diseñado para acelerar la operación de rebuildeo y disminuir la probabilidad de que otro disco falle en el mismo grupo. No es un secreto que durante el rebuildeo, todos los discos del grupo experimentan una carga elevada debido a las interferencias de las operaciones de lectura, escritura y recuperación en el hot spare. De este modo, aumenta la probabilidad de fallo de otro disco. Y cuanto más operaciones de escritura, más tiempo llevará el rebuildeo.
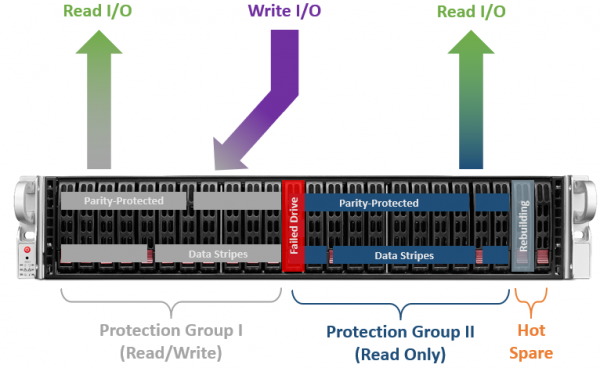
Una vez finalizado el proceso de recuperación y devuelta el grupo FlexiRemap® a su estado normal, habrá un pequeño desequilibrio en el recurso de escritura entre los dos grupos. Por lo tanto, para equilibrarlo, las operaciones de escritura posteriores se realizarán con más frecuencia en el grupo restaurado (por supuesto, con el cálculo de que el rendimiento final del sistema no se vea gravemente afectado).
Aumentar el rendimiento de los sistemas All Flash basados en algoritmos RAID más allá de ciertos valores (~280K IOPS@4K escritura aleatoria) no es posible incluso utilizando sistemas de caché complejos. La tecnología FlexiRemap®, gracias a un enfoque completamente diferente en la organización del espacio de almacenamiento, no solo supera fácilmente esta barrera, sino que también aumenta varias veces la vida útil de los SSD. Así que los sistemas tienen serias ventajas entre los arrays All Flash en muchos aspectos (IOPS/$, GB/$, TCO, ROI), convirtiéndolos en candidatos ideales para posiciones clave en los centros de datos de los clientes para resolver tareas intensivas en recursos.
Fuente: habr.com
