

Introducción filosófica
Como es sabido, existen solo dos métodos para resolver problemas:
- Método de análisis o método de deducción, o de lo general a lo particular.
- Método de síntesis o método de inducción, o de lo particular a lo general.
Para resolver el problema de 'mejorar el rendimiento de la base de datos', esto podría verse de la siguiente manera.
Análisis — descomponemos el problema en partes individuales y al resolverlas intentamos mejorar el rendimiento de la base de datos en su conjunto.
En la práctica, el análisis se ve más o menos así:
- Surge un problema (incidente de rendimiento)
- Recopilamos información estadística sobre el estado de la base de datos
- Buscamos cuellos de botella
- Resolviendo problemas en los cuellos de botella
Cuellos de botella de la base de datos — infraestructura (CPU, Memoria, Discos, Red, SO), configuraciones (postgresql.conf), consultas:
Infraestructura: las posibilidades de influencia y cambio para el ingeniero son casi nulas.
Configuraciones de la base de datos: las posibilidades de cambios son un poco mayores que en el caso anterior, pero generalmente siguen siendo bastante difíciles, especialmente en la nube.
Consultas a la base de datos: la única área para maniobras.
Síntesis — mejoramos el rendimiento de las partes individuales, esperando que como resultado el rendimiento de la base de datos mejore.
Introducción lírica o por qué todo esto es necesario
Cómo ocurre el proceso de resolución de incidentes de rendimiento cuando no se monitorea el rendimiento de la base de datos:
Cliente - 'tenemos todo mal, lento, háganlo bien'
Ingeniero - '¿mal cómo?'
Cliente - 'así como ahora (hace una hora, ayer, en el último caso), lento'
Ingeniero - '¿y cuándo fue bien?'
Cliente - 'hace una semana (dos semanas) estaba bien.' (Tuvo suerte)
Cliente - 'no recuerdo cuándo fue bien, pero ahora está mal' (Respuesta habitual)
Como resultado, obtenemos el clásico panorama:
¿Quién es el culpable y qué hacer?
La primera parte de la pregunta es más fácil de responder: siempre es culpa del ingeniero DBA.
La segunda parte también es bastante sencilla de responder: es necesario implementar un sistema de monitoreo del rendimiento de la base de datos.
Surge la primera pregunta — ¿qué monitorear?
Camino 1. Vamos a monitorear TODO
La carga de CPU, el número de operaciones de lectura/escritura en disco, el tamaño de la memoria asignada y toneladas de diferentes contadores que cualquier sistema de monitoreo medianamente funcional puede proporcionar.
El resultado es un montón de gráficos, tablas resumen y notificaciones continuas por correo, además de la ocupación del ingeniero solucionando una cantidad de tickets idénticos, a menudo con una formulación estándar: “Problema temporal. No se necesita acción”. Sin embargo, todos están ocupados, y siempre hay algo que mostrar al cliente: el trabajo no se detiene.
Ruta 2. Monitorear solo lo que es necesario, y lo que no, no se debe monitorear.
Se puede monitorear de una manera ligeramente diferente: solo entidades y eventos:
- Sobre los que el ingeniero DBA puede influir.
- Para los cuales existe un algoritmo de acciones en caso de que ocurra un evento o cambie una entidad.
Partiendo de esta suposición y recordando “Introducción filosófica”, con el objetivo de evitar la repetición regular de “Introducción lírica o por qué todo esto es necesario”, será conveniente monitorear el rendimiento de consultas individuales, para optimizar y analizar, lo que en última instancia debería llevar a una mejora en el rendimiento de toda la base de datos.
Pero para mejorar una consulta pesada que afecta el rendimiento general de la base de datos, primero hay que encontrarla.
Entonces, surgen dos preguntas interrelacionadas:
- ¿cuál consulta se considera pesada?
- ¿cómo buscar consultas pesadas?
Obviamente, una consulta pesada es una que utiliza muchos recursos del sistema operativo para obtener un resultado.
Pasemos a la segunda pregunta: ¿cómo buscar y luego monitorear consultas pesadas?
¿Qué opciones de monitoreo de consultas hay en PostgreSQL?
En comparación con Oracle, las opciones son limitadas, pero aún se puede hacer algo.
PG_STAT_STATEMENTS
Para buscar y monitorear consultas pesadas en PostgreSQL, se utiliza la extensión estándar pg_stat_statements.
Después de instalar la extensión, aparece en la base de datos objetivo una vista homónima, que es la que se debe utilizar para fines de monitoreo.
Las columnas relevantes de pg_stat_statements para construir un sistema de monitoreo son:
- queryid Código hash interno, calculado a partir del árbol de análisis de la consulta
- max_time El tiempo máximo gastado en la consulta, en milisegundos
Acumulando y utilizando las estadísticas de estas dos columnas, se puede construir un sistema de monitoreo.
Cómo se utiliza pg_stat_statements para monitorear el rendimiento de PostgreSQL
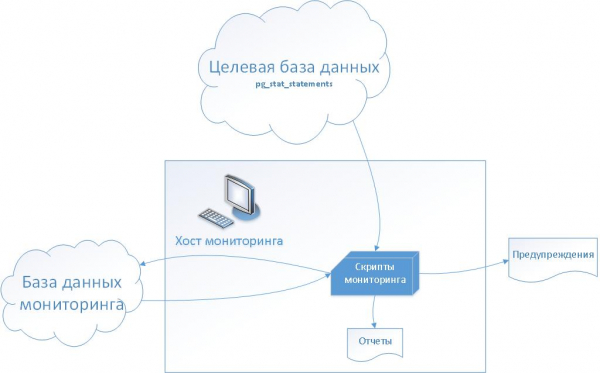
Para monitorear el rendimiento de las consultas se utiliza:
Del lado de la base de datos objetivo — la vista pg_stat_statements
Desde el lado servidores y la base de datos de monitoreo — un conjunto de scripts bash y tablas de servicios.
Etapa 1 — Recopilación de datos estadísticos
En el host de monitoreo, se ejecuta regularmente un script que copia el contenido de la vista pg_stat_statements de la base de datos objetivo en la tabla pg_stat_history de la base de datos de monitoreo.
De este modo, se forma un historial de ejecución de consultas individuales, que se puede utilizar para generar informes de rendimiento y ajustar métricas.
Etapa 2 — Configuración de métricas de rendimiento
Basándonos en los datos recopilados, seleccionamos las consultas cuya ejecución es más crítica/importante para el cliente (la aplicación). De acuerdo con el cliente, establecemos los valores de métricas de rendimiento utilizando los campos queryid y max_time.
Resultado — Inicio de la monitorización del rendimiento
- El script de monitoreo, al iniciarse, verifica las métricas de rendimiento configuradas, comparando el valor de max_time de la métrica con el valor de la vista pg_stat_statements en la base de datos objetivo.
- Si el valor en la base de datos objetivo excede el valor de la métrica, se genera una advertencia (incidente en el sistema de tickets).
Opción adicional 1
Historial de planes de ejecución de consultas
Para la resolución de incidentes de rendimiento, es muy útil tener un historial de cambios en los planes de ejecución de consultas.
Para almacenar el historial, se utiliza una tabla de servicio log_query. La tabla se llena al analizar el archivo de registro cargado de PostgreSQL. Dado que el archivo de registro, a diferencia de la vista pg_stat_statements, incluye el texto completo con los valores de los parámetros de ejecución, y no el texto normalizado, existe la posibilidad de registrar no solo el tiempo y la duración de las consultas, sino también almacenar los planes de ejecución en el momento actual.
Opción adicional 2
Proceso continuo de mejora del rendimiento
El monitoreo de consultas individuales, en general, no está destinado a abordar la cuestión de la mejora continua del rendimiento de la base de datos en su conjunto, ya que solo controla y aborda problemas de rendimiento de consultas individuales. Sin embargo, se puede ampliar el método y configurar el monitoreo de consultas para todas las bases de datos.
Para esto, es necesario introducir métricas de rendimiento adicionales:
- En los últimos días
- Por periodo base
El script selecciona consultas de la vista pg_stat_statements en la base de datos de destino y compara el valor de max_time con el valor medio de max_time, en el primer caso en los últimos días o durante un período de tiempo seleccionado (baseline), y en el segundo caso.
Así, en caso de degradación del rendimiento para cualquier consulta, se generará automáticamente una advertencia, sin necesidad de análisis manual de informes.
¿Y qué tiene que ver la síntesis?
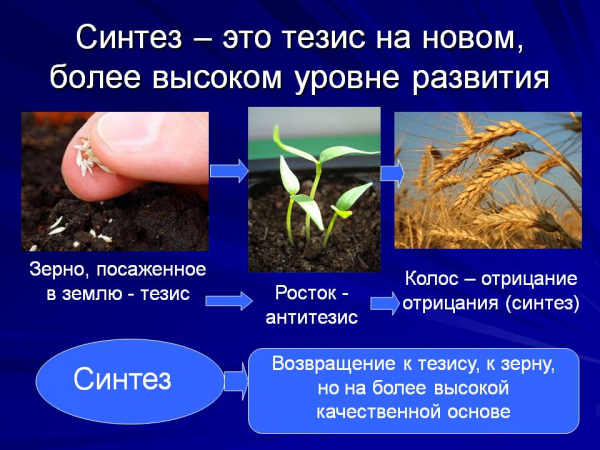
En el enfoque descrito, como lo sugiere el método de síntesis, al mejorar partes individuales del sistema, mejoramos el sistema en su conjunto.
- Consulta ejecutada por la base de datos – tesis
- Consulta modificada – antítesis
- Cambio del estado del sistema – síntesis
Desarrollo del sistema
- Ampliación de las estadísticas recogidas añadiendo historial a la vista del sistema pg_stat_activity
- Ampliación de las estadísticas recogidas añadiendo historial para las estadísticas de tablas individuales que participan en las consultas
- Integración con el sistema de monitoreo en la nube de AWS
- Y además, se puede pensar en algo más...
Fuente: habr.com
