

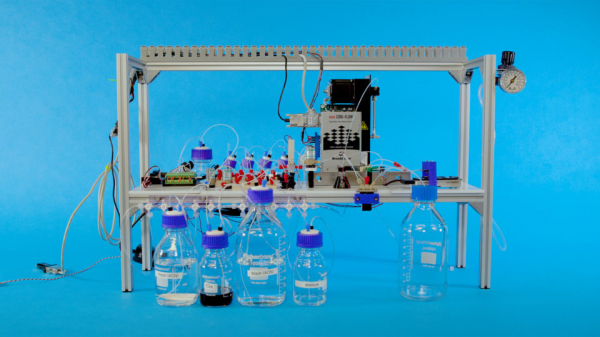
Investigadores de Microsoft y la Universidad de Washington han demostrado el primer sistema de almacenamiento de datos completamente automatizado en ADN sintético con capacidad de lectura. Este es un paso clave para llevar esta nueva tecnología de los laboratorios de investigación a los centros de datos comerciales.
Los desarrolladores confirmaron el concepto mediante una prueba simple: codificaron con éxito la palabra «hello» en fragmentos de moléculas de ADN sintético y la transformaron de nuevo en datos digitales, utilizando un sistema de extremo a extremo completamente automatizado, que se describe en , publicado el 21 de marzo en Nature Scientific Reports.
En las moléculas de ADN se puede almacenar información digital con una densidad muy alta, es decir, en un espacio físico que es muchos órdenes de magnitud menor que el que ocupan los modernos centros de datos. Esta es una de las soluciones más prometedoras para almacenar la enorme cantidad de datos que el mundo genera cada día, desde registros comerciales y videos de animales adorables hasta imágenes médicas e imágenes del espacio.
Microsoft está explorando formas de superar la posible brecha entre y queremos almacenar, y nuestra capacidad para almacenarlos. Algunas de estas formas incluyen el desarrollo de algoritmos y tecnologías de computación molecular para . Esto permitiría almacenar toda la información que se encuentra en un gran centro de datos moderno en un espacio aproximadamente del tamaño de unos pocos dados.
«Nuestro objetivo principal es poner en operación un sistema que para el usuario final se vea casi igual que cualquier otro sistema de almacenamiento en la nube: la información se envía al centro de datos y se almacena allí, y luego simplemente aparece cuando el cliente la necesita», dice Karin Strauss, investigadora principal de Microsoft. «Para ello, necesitábamos demostrar que tiene sentido práctico desde el punto de vista de la automatización».
La información se almacena en moléculas de ADN sintéticas, creadas en laboratorio, y no en el ADN de personas u otros seres vivos, y puede ser cifrada antes de ser enviada al sistema. Aunque máquinas complejas, como sintetizadores y secuenciadores, ya realizan partes clave del proceso, muchos de los pasos intermedios aún requerían trabajo manual en el laboratorio de investigación. "Esto no es adecuado para el uso comercial", dijo Chris Takahashi, investigador principal de la Escuela de Ciencias de la Computación e Ingeniería Paul G. Allen en la Universidad de EE. UU.).
"No pueden correr personas con micropipetas por el centro de datos, con este enfoque, la probabilidad de error humano es demasiado alta, es demasiado costoso y requiere demasiado espacio", explicó Takahashi.

Para que este método de almacenamiento de datos tenga sentido desde un punto de vista comercial, es necesario reducir los costos tanto de la síntesis de ADN - la creación de bloques de construcción fundamentales con secuencias significativas - como del proceso de secuenciación necesario para leer la información almacenada. Los investigadores dicen que en esta dirección se está .
Según los investigadores de Microsoft, la automatización es otra parte clave de este rompecabezas, permitiendo organizar el almacenamiento de datos a escala comercial y hacerlo más accesible.
Bajo ciertas condiciones, el ADN puede existir mucho más tiempo que los medios de archivo modernos, que se destruyen en unas pocas décadas. A algunos ADN les ha ido bien en condiciones lejos de ser ideales durante decenas de miles de años, en colmillos de mamut y en huesos de humanos primitivos. Esto significa que los datos se pueden almacenar de esta manera mientras exista la humanidad.
El sistema automatizado de almacenamiento de datos de ADN utiliza software desarrollado por especialistas de Microsoft y de la Universidad de Washington (UW). Convierte los unos y ceros de los datos digitales en secuencias de nucleótidos (A, T, C y G), que son los "bloques de construcción" del ADN. Luego, el sistema utiliza equipos de laboratorio asequibles y principalmente estándar para suministrar los líquidos y reactivos necesarios al sintetizador, que ensamblará los fragmentos de ADN producidos y los almacenará en un contenedor.
Cuando el sistema necesita extraer información, añade otros productos químicos para preparar adecuadamente el ADN y utiliza bombas microfluídicas para empujar los líquidos hacia las partes del sistema que leen las secuencias de las moléculas de ADN y las convierten de nuevo en información comprensible para las computadoras. Los investigadores dicen que el objetivo del proyecto no era demostrar que el sistema puede funcionar rápida o económicamente, sino simplemente mostrar que la automatización es posible.
Una de las ventajas más evidentes del sistema automatizado de almacenamiento de ADN es que libera a los científicos para abordar problemas más complejos, permitiendo no perder tiempo buscando frascos de reactivos o añadiendo gota a gota líquidos en tubos de ensayo.
"Contar con un sistema automatizado para realizar tareas repetitivas permite a los empleados de los laboratorios centrarse en la investigación, desarrollar nuevas estrategias para implementar innovaciones más rápidamente", dijo el investigador de Microsoft Bihlin Nguyen.
El equipo del Laboratorio de Sistemas de Información Molecular (MISL) ya ha demostrado que puede almacenar fotos de gatos, obras literarias maravillosas, y registros archivados en ADN y extraer estos archivos sin errores. Hasta ahora, han logrado almacenar 1 gigabyte de datos en ADN, estableciendo .
Los investigadores también han desarrollado métodos para , como buscar y extraer solo imágenes que contienen una manzana o una bicicleta verde, utilizando para ello las propias moléculas, sin convertir los archivos de nuevo a formato digital.
«Se puede afirmar con confianza que estamos presenciando el nacimiento de un nuevo tipo de sistema informático, en el que se utilizan moléculas para almacenar datos y electrónica para gestionar y procesar. Esta combinación abre posibilidades muy interesantes para el futuro», dijo el profesor de la escuela Allen de la Universidad de Washington. .
A diferencia de los sistemas computacionales basados en componentes de silicio, los sistemas de almacenamiento y computación basados en ADN deben utilizar líquidos para mover moléculas. Pero los líquidos, por su naturaleza, son diferentes de los electrones y requieren soluciones técnicas completamente nuevas.
El equipo de la Universidad de Washington, en colaboración con Microsoft, también está desarrollando un sistema programable que automatiza experimentos de laboratorio, utilizando propiedades de la electricidad y el agua para mover gotas sobre una red de electrodos. El conjunto completo de software y hardware, denominado , puede mezclar, separar, calentar o enfriar diferentes líquidos y llevar a cabo protocolos de laboratorio.
El objetivo es automatizar experimentos de laboratorio que actualmente se realizan manualmente o con costosos robots que trabajan con líquidos, y reducir costos.
Los próximos pasos para el equipo de MISL incluyen la integración de un sistema automatizado simple y de extremo a extremo con tecnologías como Purple Drop, así como con otras tecnologías que permiten la búsqueda en moléculas de ADN. Los investigadores han hecho su sistema automatizado modular para que pueda evolucionar a medida que surjan nuevas tecnologías para la síntesis, secuenciación y manejo de ADN.
«Una de las ventajas de este sistema es que si queremos reemplazar una de las partes por algo nuevo, más avanzado o más rápido, simplemente podemos conectar la nueva parte», dijo Nguyen. «Esto nos da una mayor flexibilidad para el futuro».
Imagen superior: investigadores de Microsoft y la Universidad de Washington grabaron y leyeron la palabra «hello», utilizando el primer sistema totalmente automatizado de almacenamiento de datos en ADN. Este es un paso clave para llevar la nueva tecnología de los laboratorios a los centros de datos comerciales.
Fuente: habr.com
