

Hola a todos, compartimos con ustedes la segunda parte de la publicación "Sistemas de archivos virtuales en Linux: ¿para qué sirven y cómo funcionan?" La primera parte se puede leer . Recordemos que esta serie de publicaciones coincide con el lanzamiento de un nuevo ciclo del curso , que comenzará muy pronto.
Cómo supervisar VFS con herramientas eBPF y bcc
La forma más sencilla de entender cómo el núcleo maneja los archivos sysfs – es observarlo en la práctica, y la manera más fácil de observar ARM64 es usar eBPF. eBPF (abreviatura de Berkeley Packet Filter) consiste en una máquina virtual que se ejecuta en el , que los usuarios privilegiados pueden consultar (query) desde la línea de comandos. El código fuente del núcleo informa al lector sobre lo que el núcleo puede hacer; ejecutar herramientas eBPF en un sistema en funcionamiento muestra lo que el núcleo realmente hace.
Afortunadamente, comenzar a usar eBPF es bastante fácil con las herramientas , que están disponibles como paquetes en la distribución general y están documentadas en detalle . Las herramientas bcc son scripts en Python con pequeñas inserciones de código en C, lo que significa que cualquiera que esté familiarizado con ambos lenguajes puede modificarlos fácilmente. En bcc/tools hay 80 scripts de Python, lo que significa que probablemente un desarrollador o administrador de sistemas podrá encontrar algo adecuado para resolver la tarea.
Para obtener al menos una visión superficial de qué trabajo realizan VFS en un sistema en funcionamiento, intente vfscount o vfsstat. Esto mostrará, por ejemplo, que decenas de llamadas vfs_open() y «sus amigos» ocurren literalmente cada segundo.
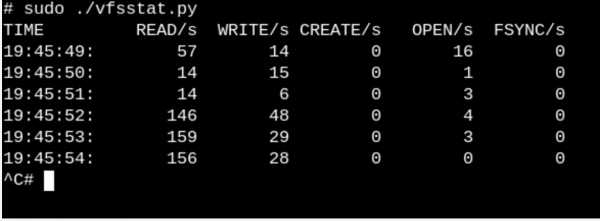
vfsstat.pyes un script en Python, con inserciones de código en C, que simplemente cuenta las llamadas a funciones VFS.
Demos un ejemplo más trivial y veamos qué sucede cuando insertamos una memoria USB en la computadora y el sistema la detecta.
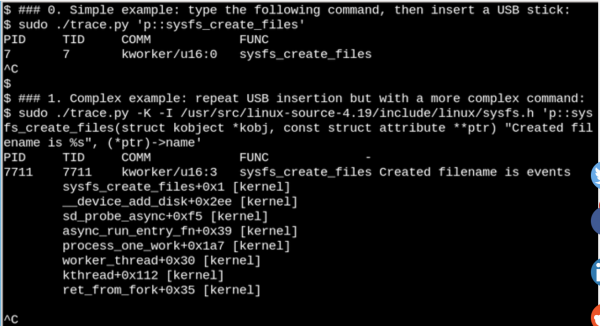
Con eBPF se puede observar qué ocurre en
/sys, cuando se inserta una memoria USB. Aquí se muestra un ejemplo simple y uno complejo.
En el ejemplo mostrado arriba, bcc herramienta imprime un mensaje cuando se ejecuta el comando sysfs_create_files().Vemos que sysfs_create_files(). se ha ejecutado mediante kworker flujos en respuesta a que se insertó la memoria USB, pero ¿qué archivo se creó en ese momento? El segundo ejemplo muestra toda la potencia de eBPF. Aquí trace.py se imprime el rastreo inverso del núcleo (kernel backtrace) (opción -K) y el nombre del archivo que se creó sysfs_create_files().. La inserción en declaraciones individuales es código en C, que incluye una cadena de formato fácilmente reconocible, proporcionada por un script de Python que ejecuta LLVM compilador just-in-time. Esta cadena se compila y se ejecuta en una máquina virtual dentro del núcleo. La firma completa de la función sysfs_create_files () debe ser reproducida en el segundo comando para que la cadena de formato pueda referenciar uno de los parámetros. Los errores en este fragmento de código en C provocan errores reconocibles del compilador de C. Por ejemplo, si falta el parámetro -l, verás "Failed to compile BPF text." Los desarrolladores que estén familiarizados con C y Python encontrarán las herramientas bcc fáciles de extender y modificar.
Cuando se inserta el dispositivo USB, el rastreo inverso del núcleo mostrará que el PID 7711 es el hilo kworker, que creó el archivo "events" en sysfs. Por lo tanto, la llamada a sysfs_remove_files() mostrará que la eliminación del dispositivo llevó a la eliminación del archivo events, lo que concuerda con el concepto general de conteo de referencias. Al mismo tiempo, la visualización de sysfs_create_link () con eBPF durante la inserción del dispositivo USB mostrará que se han creado al menos 48 enlaces simbólicos.
Entonces, ¿cuál es el propósito del archivo events? El uso de para buscar , muestra que llama a disk_add_events (), y ya sea "media_change", o "eject_request" pueden ser escritos en el archivo de eventos. Aquí, la capa de bloques del núcleo informa al espacio de usuario sobre la inserción y extracción del "disco". Observe cuán informativo es este método de investigación al comparar la inserción del dispositivo USB con intentar averiguar cómo funciona todo exclusivamente a partir del código fuente.
Los sistemas de archivos raíz de solo lectura hacen posibles los dispositivos integrados
Por supuesto, nadie apaga el servidor o su computadora desconectando el enchufe de la pared. Pero, ¿por qué? Todo porque los sistemas de archivos montados en dispositivos de almacenamiento físico pueden tener escrituras pendientes, y las estructuras de datos que registran su estado pueden no sincronizarse con las entradas en el almacenamiento. Cuando esto ocurre, los propietarios del sistema deben esperar al siguiente arranque para ejecutar la utilidad fsck filesystem-recovery y, en el peor de los casos, perder datos.
Sin embargo, todos sabemos que muchos dispositivos IoT, así como enrutadores, termostatos y automóviles, ahora funcionan con Linux. Muchos de estos dispositivos prácticamente no tienen interfaz de usuario y no hay forma de apagarlos 'correctamente'. Imagínese arrancar un automóvil con la batería descargada, cuando la alimentación del dispositivo de control está constantemente saltando hacia arriba y hacia abajo. ¿Cómo es que el sistema arranca sin un largo fsck, cuando el motor finalmente comienza a funcionar? Y la respuesta es simple. Los dispositivos integrados dependen de un sistema de archivos raíz (abreviado ro-rootfs (sistema de archivos raíz solo de lectura).
ro-rootfs ofrecen muchas ventajas que son menos obvias que la autenticidad. Una de las ventajas es que el malware no puede escribir en /usr o /lib, si ningún proceso de Linux puede escribir allí. Otra es que un sistema de archivos en gran medida inmutable es crucial para el soporte en campo de dispositivos remotos, ya que el personal de soporte utiliza sistemas locales que son nominalmente idénticos a los sistemas en el sitio. Tal vez la ventaja más importante (pero también la más engañosa) es que el ro-rootfs obliga a los desarrolladores a decidir qué objetos del sistema serán inmutables ya en la etapa de diseño del sistema. Trabajar con ro-rootfs puede ser incómodo y doloroso, como a menudo sucede con las variables const en los lenguajes de programación, pero sus beneficios fácilmente compensan los gastos generales adicionales.
Creación rootfs solo de lectura requiere un esfuerzo adicional por parte de los desarrolladores de sistemas integrados, y aquí es donde entra en juego el VFS. Linux requiere que los archivos en /var sean accesibles para escritura, y además, muchas aplicaciones populares que ejecutan sistemas integrados intentarán crear archivos de configuración dot-files en $HOME. Una de las soluciones para los archivos de configuración en el directorio home suele ser su generación previa y compilación en rootfs. Para /var uno de los enfoques posibles es montarlo en una partición separada, accesible para escritura, mientras que el mismo / se monta solo como de lectura. Otra alternativa popular es el uso de montajes enlazados o superpuestos (bind or overlay mounts).
Montajes enlazados y superpuestos, su uso en contenedores
Ejecutar el comando man mount es la mejor manera de aprender sobre montajes enlazados y superpuestos, que permiten a los desarrolladores y administradores de sistemas crear un sistema de archivos en una ruta y luego ofrecerlo a las aplicaciones en otra. Para sistemas embebidos, esto significa la posibilidad de almacenar archivos en /var en una unidad flash, accesible solo como de lectura, pero el montaje superpuesto o enlazado de la ruta desde tmpfs en /var al arrancar permitirá que las aplicaciones escriban notas en ese espacio. En la próxima activación, los cambios en /var se perderán. El montaje superpuesto crea una unión entre tmpfs y el sistema de archivos subyacente y permite hacer cambios aparentes en archivos existentes en ro-tootf mientras que el montaje enlazado puede hacer que nuevas carpetas vacías sean visibles como accesibles para escritura en tmpfs rutas. Mientras que ro-rootfs overlayfs es el tipo de sistema de archivos correcto, el montaje enlazado se implementa en el espacio de nombres VFSBasado en la descripción de los montajes superpuestos y enlazados, nadie se sorprende de quelos contenedores de Linux .
systemd-nspawn mountsnoop system-nspawn inicia el contenedor mientras está funcionando desde bcc.
mountsnoop.py Veamos qué ha resultado: durante el 'arranque' del contenedor, muestra que el entorno de ejecución del contenedor depende en gran medida del montaje enlazado (Solo se muestra el comienzo de la larga salida). proporciona archivos seleccionados en.
procfs
Lanzamiento inicia el contenedor mientras está funcionando del host al contenedor como rutas en su
Aquí Llamada . Además de MS_BIND y sysfs el flag que establece el montaje enlazado, algunos otros flags en el sistema montado determinan la relación entre los cambios en el espacio de nombres del host y del contenedor. Por ejemplo, el montaje enlazado puede omitir cambios en rootfsen el contenedor, o ocultarlos dependiendo de la llamada. en el contenedor, o ocultarlos dependiendo de la llamada. en el contenedor, o ocultarlos dependiendo de la llamada. /proc y /sys en el contenedor, o ocultarlos dependiendo de la llamada.
Conclusión
Comprender el funcionamiento interno de Linux puede parecer una tarea imposible, ya que el núcleo mismo contiene una enorme cantidad de código, dejando de lado las aplicaciones del espacio de usuario de Linux y las interfaces de llamadas al sistema en bibliotecas en C, como glibc. Una de las formas de avanzar es leer el código fuente de un subsistema del núcleo con un enfoque en entender las llamadas al sistema y los encabezados dirigidos al espacio de usuario, así como los principales interfaces internas del núcleo, por ejemplo, la tabla file_operations. Las operaciones de archivos garantizan el principio de que «todo es un archivo», por lo que gestionarlas es especialmente satisfactorio. Los archivos fuente del núcleo en C en el directorio de nivel superior fs/ representan la implementación de sistemas de archivos virtuales, que son una capa que proporciona una amplia y relativamente sencilla compatibilidad con sistemas de archivos y dispositivos de almacenamiento populares. El montaje por enlace y la superposición a través de los espacios de nombres en Linux es la magia del VFS, que permite crear contenedores y sistemas de archivos raíz de solo lectura. Junto con el estudio del código fuente, la herramienta del núcleo eBPF y su interfaz bcc
hacen que investigar el núcleo sea más fácil que nunca.
Amigos, ¿les resultó útil este artículo? ¿Tienen algún comentario o sugerencia? Aquellos interesados en el curso de «Administrador de Linux» están invitados a nuestro , que se llevará a cabo el 18 de abril.
Fuente: habr.com
