

Hola, soy Sergey Ylantsev, estoy desarrollando en Yandex.Cloud. Anteriormente, dirigué el desarrollo del balanceador L7 del portal de Yandex; mis colegas bromean que, no importa lo que haga, siempre se convierte en un balanceador. Les contaré a los lectores de Habr cómo administrar la carga en una plataforma en la nube, cuál consideramos que es la herramienta ideal para lograr este objetivo y cómo avanzamos hacia la construcción de esta herramienta.
Primero, introduzcamos algunos términos:
- VIP (IP Virtual) — la dirección IP del balanceador
- Servidor, backend, instancia — máquina virtual con una aplicación en ejecución
- RIP (IP Real) — dirección IP del servidor
- Healthcheck — verificación de disponibilidad del servidor
- Zona de disponibilidad, Availability Zone, AZ — infraestructura aislada en un centro de datos
- Región — unión de diferentes AZ
Los balanceadores de carga resuelven tres tareas principales: realizan el balanceo en sí, mejoran la resiliencia del servicio y simplifican su escalabilidad. La resiliencia se asegura mediante la gestión automática del tráfico: el balanceador supervisa el estado de la aplicación y excluye de la carga las instancias que no pasaron la verificación de disponibilidad. La escalabilidad se asegura mediante una distribución uniforme de la carga entre las instancias, así como la actualización en tiempo real de la lista de instancias. Si el balanceo no es suficientemente uniforme, algunas instancias recibirán una carga que excede su capacidad operativa, y el servicio se volverá menos fiable.
Los balanceadores de carga a menudo se clasifican según el nivel del protocolo en el modelo OSI en el que operan. El balanceador de la Nube opera en el nivel TCP, que corresponde al cuarto nivel, L4.
Pasemos a una revisión de la arquitectura del balanceador de la Nube. Aumentaremos gradualmente el nivel de detalle. Dividimos los componentes del balanceador en tres clases. La clase config plane se encarga de interactuar con el usuario y almacena el estado objetivo del sistema. El control plane mantiene el estado actual del sistema y gestiona los sistemas de la clase data plane, que son los responsables directos de entregar el tráfico desde los clientes a sus instancias.
Data plane
El tráfico llega a dispositivos costosos conocidos como routers frontera. Para aumentar la resistencia a fallos, varios de estos dispositivos funcionan simultáneamente en un mismo centro de datos. Posteriormente, el tráfico pasa a los balanceadores, que anuncian una dirección IP anycast a todas las AZ a través de BGP.
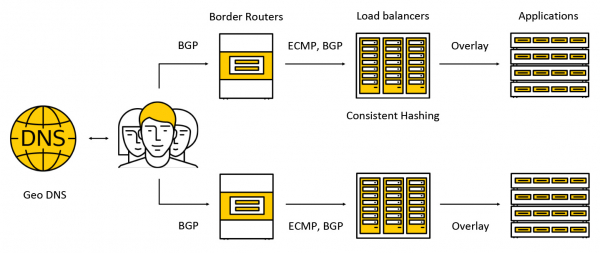
El tráfico se transmite mediante ECMP, que es una estrategia de enrutamiento donde pueden existir múltiples rutas igualmente buenas hacia el destino (en nuestro caso, el destino será la dirección IP de destino) y los paquetes pueden enviarse por cualquiera de ellas. También apoyamos el funcionamiento en varias zonas de disponibilidad según el siguiente esquema: anunciamos la dirección en cada zona, el tráfico llega a la más cercana y no sale de ahí. En la siguiente entrada, veremos más detalles sobre lo que sucede con el tráfico.
Config plane
El componente clave de config plane es la API, a través de la cual se realizan las operaciones principales con los balanceadores: creación, eliminación, modificación de la composición de instancias, obtención de resultados de healthchecks, etc. Por un lado, es una API REST, y por otro, en la Nube utilizamos con mucha frecuencia el marco gRPC, por lo que "convertimos" REST en gRPC y luego usamos solo gRPC. Cualquier solicitud genera una serie de tareas idempotentes asíncronas que se ejecutan en un grupo común de trabajadores de Yandex.Cloud. Las tareas se codifican de tal manera que pueden ser suspendidas en cualquier momento y luego reiniciadas. Esto garantiza escalabilidad, repetibilidad y registro de operaciones.
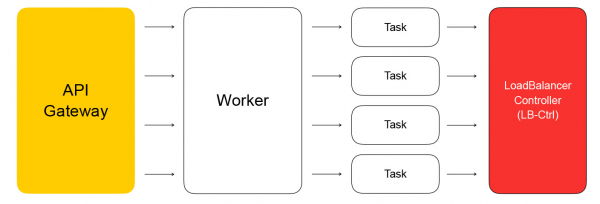
Como resultado, la tarea desde la API realizará una solicitud al controlador de servicio de balanceadores, que está escrito en Go. Puede agregar y eliminar balanceadores, modificar la composición de los backend y la configuración.
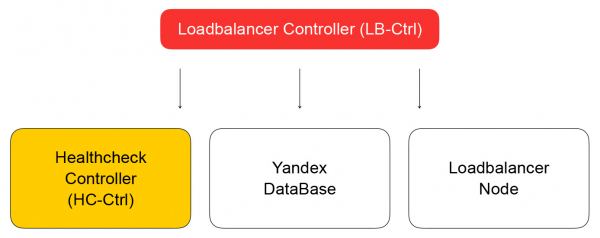
El servicio almacena su estado en Yandex Database, una base de datos distribuida administrada, que pronto podrás usar tú también. En Yandex.Cloud, como ya hemos mencionado, , empleamos el concepto de dog food: si nosotros mismos usamos nuestros servicios, nuestros clientes también estarán encantados de usarlos. Yandex Database es un ejemplo de la implementación de este concepto. Almacenamos todos nuestros datos en YDB, y no tenemos que preocuparnos por el mantenimiento y la escalabilidad de la base: esos problemas están resueltos por nosotros, usamos la base como un servicio.
Regresamos al controlador del balanceador de carga. Su tarea es mantener la información sobre el balanceador, enviar la solicitud de verificación de la disponibilidad de la máquina virtual al controlador de healthcheck.
Controlador de healthcheck
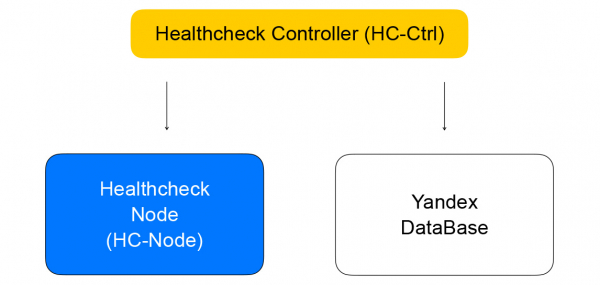
Recibe solicitudes para modificar las reglas de las verificaciones, las guarda en YDB, distribuye las tareas entre los nodos de healthcheck y agrega los resultados, que luego se guardan en la base de datos y se envían al controlador de balanceador de carga. Este, a su vez, envía una solicitud para modificar la composición del clúster en el plano de datos al nodo de balanceador de carga, del cual hablaré a continuación.
Hablemos más detalladamente sobre los healthchecks. Se pueden dividir en varias clases. Las verificaciones tienen diferentes criterios de éxito. Las verificaciones TCP necesitan establecer una conexión correctamente en un tiempo fijo. Las verificaciones HTTP requieren tanto una conexión exitosa como la recepción de una respuesta con código de estado 200.
Las verificaciones también se diferencian según su clase de acción: pueden ser activas o pasivas. Las verificaciones pasivas simplemente monitorean lo que ocurre con el tráfico sin tomar acciones especiales. Esto no funciona muy bien en L4, ya que depende de la lógica de protocolos de niveles superiores: en L4 no hay información sobre cuánto tiempo tomó la operación, ni si el cierre de la conexión fue bueno o malo. Las verificaciones activas requieren que el balanceador envíe solicitudes a cada instancia del servidor.
La mayor parte de los balanceadores de carga realizan verificaciones de "vivacidad" de manera autónoma. En la Nube hemos decidido separar estas partes del sistema para mejorar la escalabilidad. Este enfoque nos permitirá aumentar la cantidad de balanceadores manteniendo la cantidad de solicitudes de healthcheck al servicio. Las verificaciones son realizadas por nodos de healthcheck separados, donde están fragmentados y replicados los objetivos de verificación. No se pueden realizar verificaciones desde un solo host, ya que podría fallar. En ese caso, no obtendremos el estado de las instancias que ha verificado. Realizamos verificaciones de cualquiera de las instancias desde al menos tres nodos de healthcheck. Los objetivos de verificación se fragmentan entre los nodos utilizando algoritmos de hash consistente.
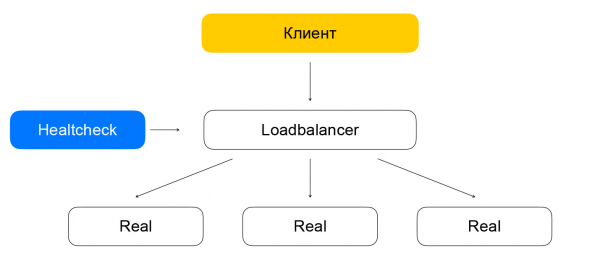
La separación del balanceo de carga y el healthcheck puede causar problemas. Si el nodo de healthcheck realiza solicitudes a la instancia, omitiendo el balanceador (que en ese momento no atiende tráfico), se produce una situación curiosa: el recurso parece estar vivo, pero el tráfico no llega a él. Solucionamos este problema asegurando que el tráfico de healthcheck pase por los balanceadores. En otras palabras, el esquema de transferencia de paquetes de tráfico de los clientes y de los healthchecks difiere mínimamente: en ambos casos, los paquetes llegarán a los balanceadores, que los enviarán a los recursos de destino.
La diferencia radica en que los clientes hacen solicitudes al VIP, mientras que los healthchecks se dirigen a cada RIP individual. Aquí surge un problema interesante: damos a nuestros usuarios la posibilidad de crear recursos en redes IP privadas. Imaginemos que hay dos propietarios de nubes diferentes que han ocultado sus servicios detrás de balanceadores. Cada uno de ellos tiene recursos en la subred 10.0.0.1/24, con las mismas direcciones. Hay que ser capaces de distinguirlos de alguna manera, y aquí es donde hay que profundizar en la estructura de la red virtual de Yandex.Cloud. Es mejor conocer los detalles en , lo que nos importa ahora es que la red es multicapa y contiene túneles que se pueden distinguir por el id de la subred.
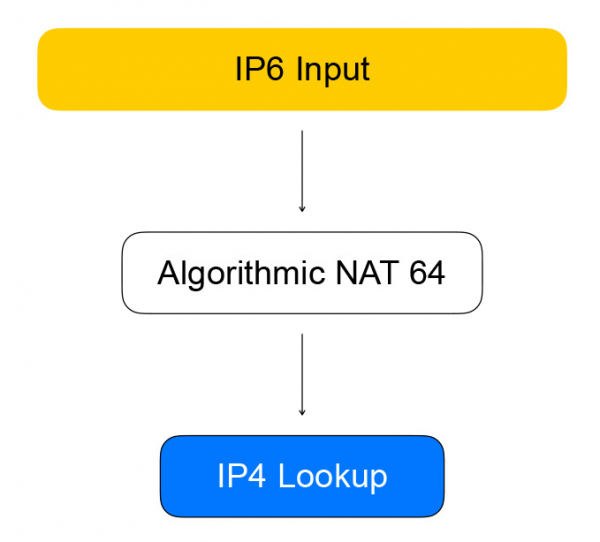
Los nodos de healthcheck se comunican con los balanceadores mediante lo que se llama direcciones cuasi-IPv6. La cuasi-dirección es una dirección IPv6 que incrusta una dirección IPv4 y el id de la subred del usuario. El tráfico llega al balanceador, que extrae de ella la dirección IPv4 del recurso, reemplaza la IPv6 por la IPv4 y envía el paquete a la red del usuario.
El tráfico de retorno se comporta de la misma manera: el balanceador ve que el destino es una red privada de healthcheckers y convierte la IPv4 en IPv6.
VPP es el corazón del data plane
El balanceador está implementado en la tecnología Vector Packet Processing (VPP), un marco de trabajo de Cisco para procesar el tráfico de red. En nuestro caso, el marco funciona sobre la biblioteca de gestión de dispositivos de red en espacio de usuario — Data Plane Development Kit (DPDK). Esto proporciona un alto rendimiento en el procesamiento de paquetes: en el núcleo se producen muchas menos interrupciones, y no hay conmutaciones de contexto entre el espacio del kernel y el espacio de usuario.
VPP va aún más lejos y maximiza el rendimiento del sistema al agrupar paquetes en lotes. Este aumento de rendimiento se logra mediante el uso agresivo de las cachés de los procesadores modernos. Se utilizan tanto las cachés de datos (los paquetes se procesan en «vectores», con datos que están cerca unos de otros) como las cachés de instrucciones: en VPP, el procesamiento de paquetes sigue un gráfico, en cuyos nodos se encuentran funciones que realizan una tarea específica.
Por ejemplo, el procesamiento de paquetes IP en VPP ocurre en el siguiente orden: primero, en el nodo de análisis, se procesan los encabezados de los paquetes, y luego se envían a un nodo que reenvía los paquetes de acuerdo con las tablas de enrutamiento.
Un poco de hardcore. Los autores de VPP no hacen concesiones en el uso de las cachés del procesador, por lo que el código típico para el procesamiento de vectores de paquetes contiene vectorización manual: hay un bucle de procesamiento en el que se maneja una situación del tipo «tenemos cuatro paquetes en la cola», luego lo mismo para dos y, finalmente, para uno. Se utilizan frecuentemente instrucciones de prefetch que cargan datos en las cachés para acelerar el acceso en las siguientes iteraciones.
n_left_from = frame->n_vectors;
while (n_left_from > 0)
{
    vlib_get_next_frame (vm, node, next_index, to_next, n_left_to_next);
    // ...
    while (n_left_from >= 4 && n_left_to_next >= 2)
    {
        // procesar múltiples paquetes a la vez
        u32 next0 = SAMPLE_NEXT_INTERFACE_OUTPUT;
        u32 next1 = SAMPLE_NEXT_INTERFACE_OUTPUT;
        // ...
        /* Prefetch de la siguiente iteración. */
        {
            vlib_buffer_t *p2, *p3;

            p2 = vlib_get_buffer (vm, from[2]);
            p3 = vlib_get_buffer (vm, from[3]);

            vlib_prefetch_buffer_header (p2, LOAD);
            vlib_prefetch_buffer_header (p3, LOAD);

            CLIB_PREFETCH (p2->data, CLIB_CACHE_LINE_BYTES, STORE);
            CLIB_PREFETCH (p3->data, CLIB_CACHE_LINE_BYTES, STORE);
        }
        // procesar datos realmente
        /* verificar encolados especulativos, tal vez cambiar el marco siguiente actual */
        vlib_validate_buffer_enqueue_x2 (vm, node, next_index,
                to_next, n_left_to_next,
                bi0, bi1, next0, next1);
    }

    while (n_left_from > 0 && n_left_to_next > 0)
    {
        // procesar paquetes uno a uno
    }

    // lote procesado
    vlib_put_next_frame (vm, node, next_index, n_left_to_next);
}
Así que los healthchecks se dirigen a VPP a través de IPv6, que los convierte en IPv4. Esto es manejado por un nodo del gráfico que llamamos NAT algorítmico. Para el tráfico de retorno (y la conversión de IPv6 a IPv4), hay un nodo similar de NAT algorítmico.
El tráfico directo de los clientes del balanceador pasa a través de los nodos del gráfico que realizan el balanceo en sí.
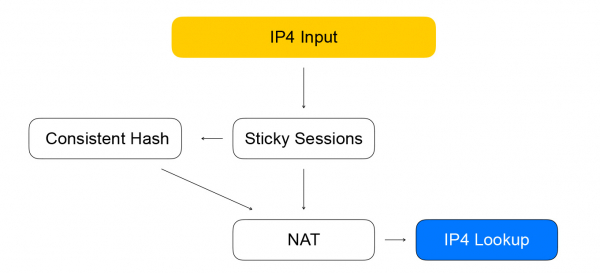
El primer nodo son las sesiones adherentes. En él se almacena un hash de para sesiones establecidas. El 5-tuple incluye la dirección y el puerto del cliente desde el cual se transmite la información, la dirección y los puertos de los recursos disponibles para recibir tráfico, así como el protocolo de red.
El hash del 5-tuple nos ayuda a realizar menos cálculos en el siguiente nodo de hashing consistente, y a manejar mejor el cambio en la lista de recursos detrás del balanceador. Cuando llega un paquete al balanceador para el cual no hay sesión, se envía al nodo de hashing consistente. Aquí es donde se realiza el balanceo con hashing consistente: elegimos un recurso de la lista de recursos 'vivos' disponibles. Luego, los paquetes se envían al nodo NAT, que realiza la sustitución del destino y el recálculo de las sumas de verificación. Como puede ver, seguimos las reglas del VPP: semejante a semejante, agrupamos cálculos similares para aumentar la eficiencia de las cachés del procesador.
Hashing consistente
¿Por qué elegimos exactamente esto y qué es? Para empezar, consideremos el problema anterior: elegir un recurso de la lista.
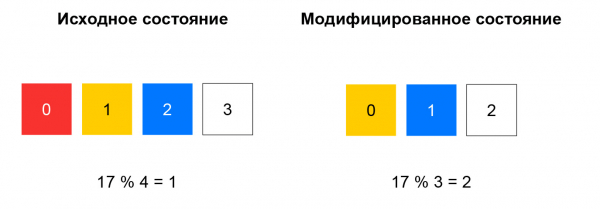
En el hashing inconsistente, se calcula el hash del paquete entrante, y se elige un recurso de la lista según el residuo de la división de este hash por el número de recursos. Mientras la lista permanezca sin cambios, este esquema funciona bien: siempre enviamos paquetes con el mismo 5-tuple a la misma instancia. Sin embargo, si, por ejemplo, algún recurso deja de responder a las comprobaciones de estado, entonces una parte significativa de los hashes cambiará. Las conexiones TCP del cliente se interrumpirán: un paquete que anteriormente iba a la instancia A puede comenzar a ir a la instancia B, que no está familiarizada con la sesión de este paquete.
El hashing consistente resuelve el problema descrito. La forma más sencilla de explicar este concepto es imaginar que tiene un anillo en el que distribuye recursos según el hash (por ejemplo, por IP:port). La elección del recurso es como girar la rueda en un ángulo determinado por el hash del paquete.
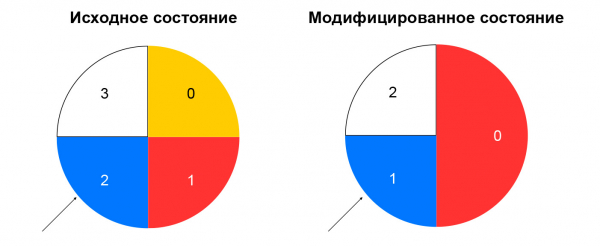
De este modo, se minimiza la redistribución del tráfico al cambiar la composición de los recursos. La eliminación de un recurso solo afectará la parte del anillo de hashing consistente donde residía dicho recurso. La adición de un recurso también cambia la distribución, pero tenemos un nodo de sesiones pegajosas que permite no cambiar las sesiones ya establecidas a nuevos recursos.
Hemos analizado qué sucede con el tráfico directo entre el balanceador y los recursos. Ahora, vamos a ver el tráfico inverso. Este sigue el mismo patrón que el tráfico de comprobación: a través de NAT algorítmico, es decir, a través de NAT 44 para el tráfico del cliente y NAT 46 para el tráfico de healthchecks. Mantenemos nuestro propio esquema: unificamos el tráfico de healthchecks y el tráfico real de los usuarios.
Loadbalancer-node y componentes en conjunto
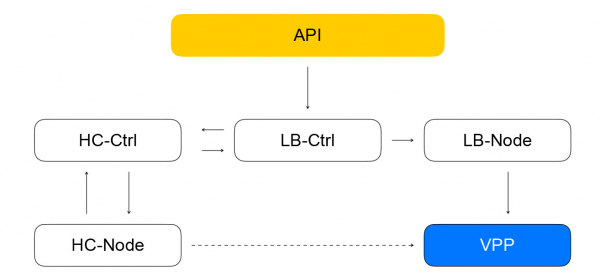
La composición de los balanceadores y recursos en VPP es informada por el servicio local: loadbalancer-node. Este se suscribe a un flujo de eventos del loadbalancer-controller, puede construir la diferencia entre el estado actual de VPP y el estado objetivo recibido del controlador. Obtenemos un sistema cerrado: los eventos de la API llegan al controlador del balanceador, que asigna tareas al controlador de healthcheck para verificar la "vitalidad" de los recursos. Este, a su vez, asigna tareas al healthcheck-node y agrega los resultados, que luego son devueltos al controlador de balanceadores. Loadbalancer-node se suscribe a eventos del controlador y modifica el estado de VPP. En este sistema, cada servicio conoce solo lo necesario sobre los servicios vecinos. La cantidad de conexiones es limitada, lo que nos permite explotar y escalar independientemente diferentes segmentos.
Preguntas que hemos evitado
Todos nuestros servicios en el control plane están escritos en Go y tienen buenas características de escalabilidad y fiabilidad. En Go hay muchas bibliotecas de código abierto para construir sistemas distribuidos. Usamos activamente GRPC, todos los componentes incluyen una implementación de código abierto para el descubrimiento de servicios: nuestros servicios supervisan la operatividad unos de otros, pueden cambiar su composición de manera dinámica, y hemos integrado esto con la balanceo de GRPC. También utilizamos una solución de código abierto para las métricas. En el data plane hemos logrado un rendimiento notable y un amplio margen de recursos: fue muy complicado montar un entorno que pudiera llegar al rendimiento de VPP, en lugar de la tarjeta de red física.
Problemas y soluciones
¿Qué no funcionó del todo bien? En Go, la gestión de memoria es automática, pero aún pueden ocurrir fugas de memoria. La forma más simple de manejarlas es ejecutar gorutinas y recordar finalizarlas. Conclusión: vigila el consumo de memoria de los programas en Go. A menudo, un buen indicador es la cantidad de gorutinas. Hay un lado positivo en esta historia: en Go es fácil obtener datos sobre el runtime: sobre el consumo de memoria, sobre la cantidad de gorutinas en ejecución y sobre muchos otros parámetros.
Además, Go puede no ser la mejor opción para pruebas funcionales. Son bastante verbosas, y el enfoque estándar de "ejecutar todo en CI en paquete" no es muy adecuado para ellas. El problema es que las pruebas funcionales son más exigentes en recursos, experimentan verdaderos timeouts. Debido a esto, las pruebas pueden fallar, ya que la CPU está ocupada con pruebas unitarias. Conclusión: si es posible, ejecuta las pruebas "pesadas" por separado de las pruebas unitarias.
La arquitectura de eventos de microservicios es más compleja que la de un monolito: raspar registros en decenas de máquinas diferentes no es muy conveniente. Conclusión: si haces microservicios, piensa desde el principio en el trazado.
Nuestros planes
Vamos a lanzar un equilibrador de carga interno, un equilibrador de carga IPv6, agregar soporte para scripts de Kubernetes, continuar fragmentando nuestros servicios (ahora solo están fragmentados healthcheck-node y healthcheck-ctrl), agregar nuevos healthchecks y también implementar una agregación inteligente de verificaciones. Estamos considerando la posibilidad de hacer que nuestros servicios sean aún más independientes: en lugar de comunicarse directamente entre sí, se comunicarán mediante una cola de mensajes. Recientemente, ha surgido en la Nube un servicio compatible con SQS. .
Recientemente tuvo lugar el lanzamiento público de Yandex Load Balancer. Estudien el servicio, gestionen los equilibradores de carga de la manera que prefieran y aumenten la resiliencia de sus proyectos.
Fuente: habr.com
