

El tema de la alta disponibilidad en sistemas de almacenamiento de datos siempre es relevante, ya que en nuestra era de virtualización y consolidación de recursos, un fallo en el sistema de almacenamiento puede provocar no solo un incidente menor, sino paradas prolongadas de los servicios. Por lo tanto, los sistemas de almacenamiento modernos cuentan con numerosos componentes redundantes (incluso controladores). Pero, ¿es suficiente esta protección?
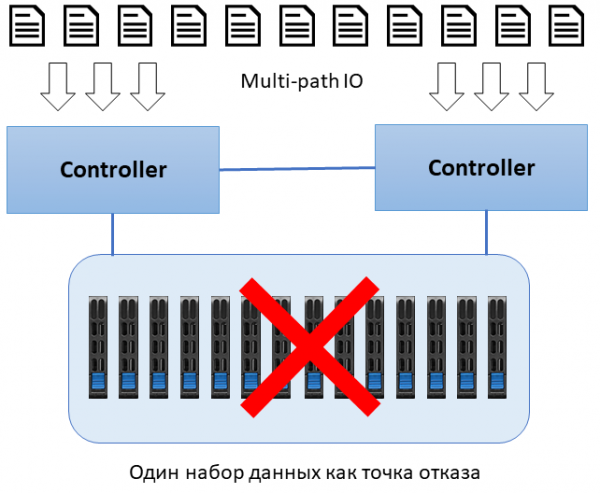
Todos los proveedores, al enumerar las características de sus sistemas de almacenamiento, mencionan obligatoriamente la alta disponibilidad de sus soluciones, añadiendo siempre el término "sin un único punto de fallo". Echemos un vistazo más detallado a un sistema de almacenamiento típico. Para evitar paradas durante el mantenimiento, los sistemas de almacenamiento duplican las fuentes de alimentación, los módulos de refrigeración, los puertos de entrada/salida, los dispositivos de almacenamiento (nos referimos a RAID) y, por supuesto, los controladores. Si observamos detenidamente esta arquitectura, podemos identificar, al menos, dos puntos potenciales de fallo que se omiten con discreción:
- La existencia de un único backplane
- La existencia de una copia de datos única
El backplane es un dispositivo técnicamente complejo que debe someterse a pruebas rigurosas durante su fabricación. Por eso, es bastante raro que falle completamente. Sin embargo, incluso en caso de fallos parciales, como un slot de almacenamiento que no funciona, será necesaria su sustitución con la interrupción total del sistema de almacenamiento.
Crear múltiples copias de datos también, a primera vista, no parece ser un problema. Por ejemplo, la funcionalidad de Clonación en un sistema de almacenamiento, que permite actualizar periódicamente una copia completa de los datos, es bastante común. Sin embargo, en caso de problemas con el mismo backplane, la copia también será inaccesible, al igual que el original.
Una salida bastante obvia para superar estas desventajas es la replicación a otro sistema de almacenamiento. Si ignoramos el inevitable aumento del costo del hardware (suponemos que las personas que eligen esta solución son razonables y aceptan este hecho de antemano), aún quedarán posibles gastos para organizar la replicación en forma de licencias, software y hardware adicionales. Y lo más importante, será necesario garantizar de alguna manera la consistencia de los datos replicados. Es decir, construir un virtualizador de almacenamiento o vSAN, lo que también requiere recursos tanto financieros como de tiempo.
Al crear sus propios sistemas de alta disponibilidad, se estableció el objetivo de deshacerse de las desventajas mencionadas anteriormente. Así surgió la interpretación de la tecnología Shared Nothing, que en una traducción libre significa “sin el uso de dispositivos compartidos”.
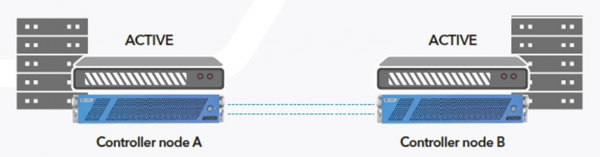
Concepto La arquitectura consiste en usar dos nodos independientes (controladores), cada uno de los cuales tiene su propio conjunto de datos. La replicación sincrónica se realiza entre los nodos a través de la interfaz InfiniBand de 56G de manera completamente transparente para el software que funciona sobre el sistema de almacenamiento. Como resultado, no se requiere el uso de virtualizadores de almacenamiento, agentes de software, etc.
La solución de dos nodos de AccelStor puede realizarse en dos modelos:
- — basada en servidores Twin en un chasis de 2U, si se requieren rendimiento moderado y capacidad de hasta 22TB;
- — basada en servidores independientes de 2U, si se requiere alto rendimiento y mayor capacidad (hasta 57TB).
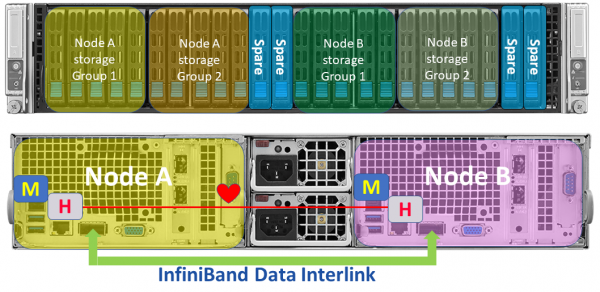
Modelo H510 basado en servidor Twin
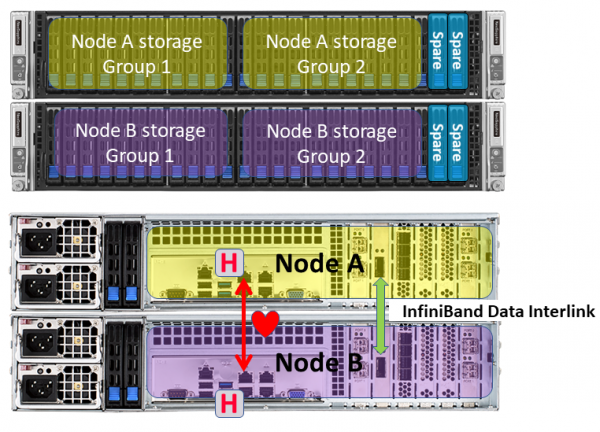
Modelo H710 basado en servidores independientes
El uso de diferentes factores de forma se debe a la necesidad de un número diverso de SSD para lograr el volumen y el rendimiento requeridos. Además, la plataforma Twin es más económica y permite ofrecer soluciones más asequibles, aunque con alguna 'desventaja' condicional en forma de un único backplane. Todo lo demás, incluidos los principios de funcionamiento, es completamente idéntico en ambos modelos.
El conjunto de datos en cada nodo tiene dos grupos , más 2 reservas en caliente. Cada grupo puede soportar la falla de un SSD. Todas las solicitudes de escritura que recibe el nodo se procesan de acuerdo con FlexiRemap rearranges into sequential chains with 4KB blocks, which are then written to the SSD in the mode that is most comfortable for them (sequential write). Moreover, the host receives confirmation of the write only after the physical placement of the data on the SSD, i.e., without caching in RAM. As a result, impressive performance is achieved, up to 600K IOPS for writing and 1M+ IOPS for reading (H710 model).
As previously mentioned, the synchronization of data sets occurs in real-time through the 56G InfiniBand interface, which has high bandwidth and low latency. To maximize the efficiency of the communication channel when transmitting small packets. Since there is only one communication channel, a dedicated 1GbE link is used for additional heartbeat checking. Only heartbeat information is transmitted through it, so there are no stringent speed requirements.
In case of increasing system capacity (up to 400+ TB) due to they are also connected in pairs to ensure the concept of 'no single point of failure'.
For additional data protection (besides the fact that AccelStor already has two copies), a special algorithm is used in case any SSD fails. If an SSD fails, the node will start rebuilding data onto one of the hot spare drives. The FlexiRemap group, which is in a degraded state, will switch to read-only mode. This is done to eliminate interferences between write operations and rebuilding on the spare drive, which ultimately speeds up the recovery process and reduces the time the system is potentially vulnerable. Upon completion of the rebuild, the node returns to normal read-write operation.
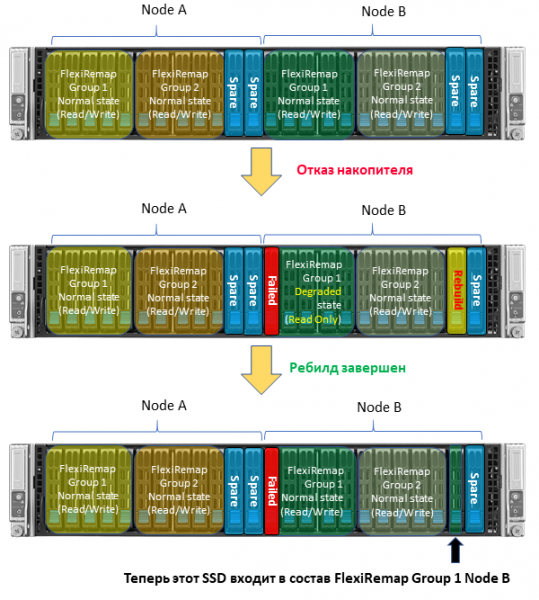
Of course, as with other systems, overall performance decreases during the rebuild (since one of the FlexiRemap groups is not writing). However, the recovery process occurs as quickly as possible, which favorably distinguishes AccelStor systems from solutions by other vendors.
Another useful feature of the Nothing Shared architecture technology is the operation of nodes in a so-called true active-active mode. Unlike the 'classic' architecture, where a specific volume/pool is owned by only one controller while the second simply performs input/output operations, in systems cada nodo trabaja con su propio conjunto de datos y no transfiere solicitudes a su "vecino". Como resultado, se mejora el rendimiento general del sistema gracias al procesamiento paralelo de las solicitudes de entrada/salida por parte de los nodos y el acceso a los dispositivos de almacenamiento. Además, prácticamente no existe el concepto de failover, ya que no es necesario transferir el control de los volúmenes a otro nodo en caso de fallo.
Si comparamos la tecnología Nothing Shared de la arquitectura con la duplicación completa de sistemas de almacenamiento, a primera vista, podría parecer que es un poco menos flexible que una implementación completa de recuperación ante desastres. Esto es especialmente relevante para la organización de la conexión entre los sistemas de almacenamiento. En el modelo H710, es posible separar los nodos a una distancia de hasta 100 m utilizando costosos cables ópticos activos InfiniBand. Pero incluso al comparar con la implementación convencional de replicación síncrona de otros proveedores a través de Fibre Channel, incluso a mayores distancias, la solución de AccelStor resultará más barata y más sencilla de instalar/operar, ya que no es necesario instalar virtualizadores de sistemas de almacenamiento o integrar con el software (lo cual no siempre es posible). Además, no olvidemos que las soluciones de AccelStor son matrices All Flash con un rendimiento superior al de los sistemas de almacenamiento "clásicos" solo con SSD.
Con la tecnología Nothing Shared de AccelStor, es posible alcanzar una disponibilidad del sistema de almacenamiento del 99.9999% a un costo razonable. Junto con la alta fiabilidad de la solución, que incluye dos copias de datos, y un rendimiento impresionante gracias a los algoritmos patentados, las soluciones de son excelentes candidatas para posiciones clave en la construcción de un centro de datos moderno.
Fuente: habr.com
