

Un número considerable de aplicaciones Enterprise y sistemas de virtualización tienen sus propios mecanismos para construir soluciones de alta disponibilidad. En particular, Oracle RAC (Oracle Real Application Cluster) es un clúster formado por dos o más servidores de bases de datos Oracle que trabajan conjuntamente para equilibrar la carga y garantizar la alta disponibilidad a nivel de servidor/aplicación. Para operar en este modo, se necesita un almacenamiento compartido, que generalmente asume la función de un sistema de almacenamiento (СХД).
Como ya hemos discutido en uno de nuestros , el sistema de almacenamiento (СХД), a pesar de contar con componentes duplicados (incluyendo los controladores), aún tiene puntos de falla, principalmente en forma de un único conjunto de datos. Por lo tanto, para construir una solución Oracle con requisitos de fiabilidad más estrictos, el esquema "N servidores – un СХД" necesita ser complejo.
Primero, por supuesto, debemos determinar cuáles son los riesgos de los que intentamos protegernos. En este artículo, no abordaremos la protección contra amenazas como "un meteorito ha caído". Así que la construcción de una solución de recuperación ante desastres geográficamente dispersa seguirá siendo el tema de uno de los próximos artículos. Aquí consideraremos la llamada solución de recuperación ante desastres Cross-Rack, donde la protección se construye a nivel de racks de servidores. Los racks pueden estar en una misma sala o en diferentes, pero normalmente dentro de un mismo edificio.
Estos racks deben contener todo el conjunto necesario de hardware y software que permita el funcionamiento de las bases de datos Oracle independientemente del estado del "vecino". En otras palabras, al utilizar una solución de recuperación ante desastres Cross-Rack, eliminamos los riesgos en caso de falla:
- Servidores de aplicaciones Oracle
- Sistemas de almacenamiento
- Sistemas de conmutación
- Fallo total de todo el equipo en el rack:
- Fallo de alimentación
- Fallo del sistema de refrigeración
- Factores externos (humanos, naturales, etc.)
La duplicación de servidores Oracle implica el propio principio de funcionamiento de Oracle RAC y se realiza a través de la aplicación. La duplicación de los medios de conmutación tampoco representa un problema. Sin embargo, la duplicación del sistema de almacenamiento no es tan simple.
La opción más sencilla es replicar datos desde el almacenamiento principal a uno de respaldo. Puede ser sincrónica o asincrónica, dependiendo de las capacidades del almacenamiento. Con la replicación asincrónica, surge de inmediato la cuestión de asegurar la consistencia de los datos con respecto a Oracle. Pero incluso si hay una integración programática con la aplicación, en cualquier caso, ante una falla en el almacenamiento principal, se requerirá la intervención manual de los administradores para cambiar el clúster al almacenamiento de respaldo.
Una opción más complicada son los «virtualizadores» de software y/o hardware de almacenamiento que evitan problemas de consistencia y la intervención manual. Sin embargo, la complejidad de implementación y la posterior administración, así como el costo considerable de estas soluciones, ahuyentan a muchos.
Justamente para escenarios como la recuperación ante desastres Cross-Rack, la solución AccelStor NeoSapphire™ All Flash es ideal. utilizando una arquitectura Shared-Nothing. Este modelo es un sistema de almacenamiento de dos nodos que emplea su propia tecnología FlexiRemap® para trabajar con unidades flash. Gracias a NeoSapphire™ H710 puede proporcionar hasta 600K IOPS@4K escritura aleatoria y 1M+ IOPS@4K lectura aleatoria, lo cual no se puede lograr con los sistemas de almacenamiento basados en RAID clásicos.
Pero la principal característica de NeoSapphire™ H710 es que ambas nodos están ejecutadas en gabinetes separados, cada uno con su propia copia de datos. La sincronización de nodos se realiza a través de una interfaz externa InfiniBand. Gracias a esta arquitectura, se pueden separar los nodos en diferentes ubicaciones a una distancia de hasta 100 m, proporcionando así la solución de recuperación ante desastres Cross-Rack. Ambos nodos funcionan completamente en modo sincrónico. Desde el punto de vista de los hosts, H710 se presenta como un almacenamiento de dos controladores normal. Por lo tanto, no es necesario realizar configuraciones adicionales complicadas ni opciones de software y hardware.
Si comparamos todas las soluciones descritas anteriormente para la recuperación ante desastres Cross-Rack, la opción de AccelStor se destaca notablemente entre las demás:
AccelStor NeoSapphire™ Arquitectura Shared Nothing
Virtualizador de almacenamiento de software o hardware
Solución basada en replicación
Disponibilidad
Fallo del servidor
Sin tiempo de inactividad
Sin tiempo de inactividad
Sin tiempo de inactividad
Fallo del conmutador
Sin tiempo de inactividad
Sin tiempo de inactividad
Sin tiempo de inactividad
Fallo del sistema de almacenamiento
Sin tiempo de inactividad
Sin tiempo de inactividad
Tiempo de inactividad
Fallo de todo el armario
Sin tiempo de inactividad
Sin tiempo de inactividad
Tiempo de inactividad
Costo y complejidad
Costo de la solución
Bajo*
Alta
Alta
Complejidad de implementación
Bajo
Alta
Alta
*AccelStor NeoSapphire™ es un sistema de almacenamiento All Flash que, por definición, no es “barato”, especialmente dado su doble capacidad. Sin embargo, al comparar el costo final de una solución basada en él con las de otros proveedores, se puede considerar que su costo es bajo.
La topología de conexión de los servidores de aplicaciones y nodos del sistema All Flash será la siguiente:
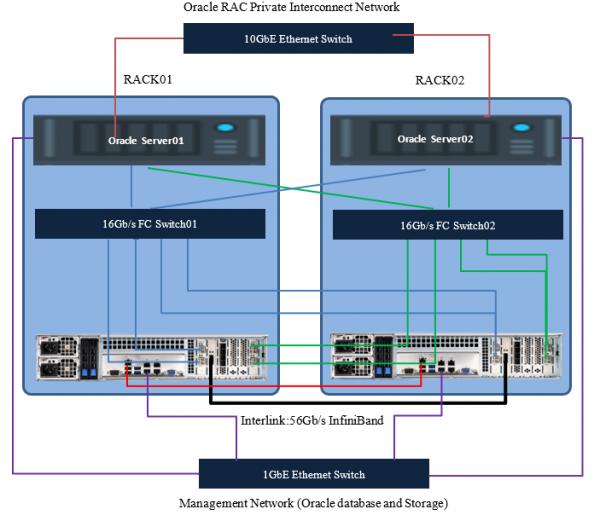
Al planificar la topología, también se recomienda encarecidamente realizar una duplicación de los switches de gestión y del interconexión de los servidores.
A partir de aquí y en adelante, se hablará de la conexión a través de Fibre Channel. En caso de utilizar iSCSI, será lo mismo, con la salvedad de los tipos de switches utilizados y algo de configuración diferente del sistema.
Trabajo de preparación en el sistema
Equipo y software utilizados
Especificaciones de servidores y switches
Componentes
Descripción
Servidores de Oracle Database 11g
Dos
Sistema operativo del servidor
Oracle Linux
Versión de la base de datos de Oracle
11g (RAC)
Procesadores por servidor
Dos CPU Intel® Xeon® de 16 núcleos E5-2667 v2 a 3.30GHz
Memoria física por servidor
128GB
Red FC
FC de 16Gb/s con multipathing
FC HBA
Emulex Lpe-16002B
Puertos públicos dedicados 1GbE para gestión del clúster
Adaptador Ethernet RJ45 de Intel
Switch FC de 16Gb/s
Brocade 6505
Puertos privados dedicados 10GbE para sincronización de datos
Intel X520
Especificación del sistema de almacenamiento AccelStor NeoSapphhire™ All Flash
Componentes
Descripción
Sistema de almacenamiento
Modelo de alta disponibilidad NeoSapphire™: H710
Versión de imagen
4.0.1
Número total de unidades
48
Tamaño de unidad
1.92TB
Tipo de unidad
SSD
Puertos objetivo FC
16 x 16Gb ports (8 por nodo)
Puertos de gestión
El cable Ethernet 1GbE que conecta a los hosts a través de un switch Ethernet
Puerto de latido
El cable Ethernet 1GbE que conecta entre dos nodos de almacenamiento
Puerto de sincronización de datos
Cable InfiniBand de 56Gb/s
Antes de comenzar a utilizar el sistema, es necesario inicializarlo. Por defecto, las direcciones de gestión de ambos nodos son las mismas (192.168.1.1). Se deben conectar uno por uno y asignar nuevas (ya diferentes) direcciones de gestión y configurar la sincronización de tiempo, tras lo cual los puertos de gestión se pueden conectar a una única red. Luego, se procede a unir los nodos en un par HA mediante la asignación de subredes para las conexiones Interlink.
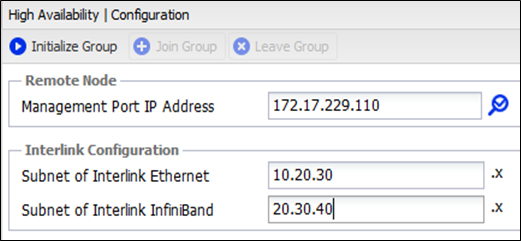
Una vez completada la inicialización, se puede gestionar el sistema desde cualquier nodo.
A continuación, se crean los volúmenes necesarios y se publican para los servidores de aplicaciones.
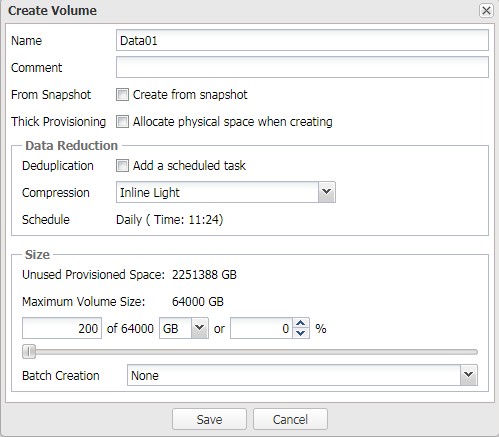
Se recomienda encarecidamente crear varios volúmenes para Oracle ASM, ya que esto aumentará el número de objetivos para los servidores, lo que a su vez mejorará el rendimiento general (más sobre las colas en otra sección) ).
Configuración de prueba
Nombre del volumen de almacenamiento
Tamaño del volumen
Data01
200GB
Data02
200GB
Data03
200GB
Data04
200GB
Data05
200GB
Data06
200GB
Data07
200GB
Data08
200GB
Data09
200GB
Data10
200GB
Grid01
1GB
Grid02
1GB
Grid03
1GB
Grid04
1GB
Grid05
1GB
Grid06
1GB
Redo01
100GB
Redo02
100GB
Redo03
100GB
Redo04
100GB
Redo05
100GB
Redo06
100GB
Redo07
100GB
Redo08
100GB
Redo09
100GB
Redo10
100GB
Algunas explicaciones sobre los modos de operación de la matriz y los procesos que ocurren en situaciones anormales.
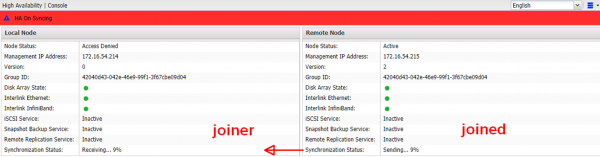
Cada nodo tiene un parámetro de "número de versión" en su conjunto de datos. Después de la inicialización primaria, es el mismo y vale 1. Si por alguna razón el número de versión es diferente, siempre se sincronizan los datos de la versión superior a la inferior, tras lo cual el número de la inferior se ajusta, es decir, eso significa que las copias son idénticas. Las razones por las que las versiones pueden ser diferentes son:
- Reinicio planificado de uno de los nodos.
- Fallo en uno de los nodos debido a un apagón repentino (poder, sobrecalentamiento, etc.).
- Interrupción de la conexión InfiniBand sin posibilidad de sincronización.
- Fallo en uno de los nodos debido a daños en los datos. Aquí será necesario crear un nuevo grupo HA y realizar una sincronización completa del conjunto de datos.
En cualquier caso, el nodo que permanece en línea incrementa su número de versión en uno, para que después de restaurar la conexión pueda sincronizar su conjunto de datos.
Si hay una interrupción en la conexión por el enlace Ethernet, Heartbeat se cambia temporalmente a InfiniBand y regresa en 10 segundos cuando se restaura.
Configuración de hosts.
Para garantizar la tolerancia a fallos y aumentar el rendimiento, es necesario habilitar el soporte MPIO para la matriz. Para ello, hay que agregar líneas al archivo /etc/multipath.conf y luego reiniciar el servicio multipath.
Texto ocultodevices {
device {
vendor "AStor"
path_grouping_policy "group_by_prio"
path_selector "queue-length 0"
path_checker "tur"
features "0"
hardware_handler "0"
prio "const"
failback immediate
fast_io_fail_tmo 5
dev_loss_tmo 60
user_friendly_names yes
detect_prio yes
rr_min_io_rq 1
no_path_retry 0
}
}
A continuación, para que ASM trabaje con MPIO a través de ASMLib, es necesario modificar el archivo /etc/sysconfig/oracleasm y luego ejecutar /etc/init.d/oracleasm scandisks.
Texto oculto
# ORACLEASM_SCANORDER: Matching patterns to order disk scanning
ORACLEASM_SCANORDER="dm"
# ORACLEASM_SCANEXCLUDE: Matching patterns to exclude disks from scan
ORACLEASM_SCANEXCLUDE="sd"
Nota
Si no se desea utilizar ASMLib, se pueden utilizar reglas UDEV, que son la base para ASMLib.
A partir de la versión 12.1.0.2, la opción de Oracle Database está disponible para instalar como parte del software ASMFD.
Es importante asegurarse de que los discos creados para Oracle ASM estén alineados con respecto al tamaño del bloque con el que trabaja físicamente la matriz (4K). De lo contrario, pueden surgir problemas de rendimiento. Por lo tanto, es necesario crear volúmenes con los parámetros adecuados:
parted /dev/mapper/device-name mklabel gpt mkpart primary 2048s 100% align-check optimal 1
Distribución de bases de datos en los volúmenes creados para nuestra configuración de prueba
Nombre del volumen de almacenamiento
Tamaño del volumen
Mapeo de LUNs de volumen
Detalles del dispositivo de volumen ASM
Tamaño de unidad de asignación
Data01
200GB
Mapear todos los volúmenes de almacenamiento a todos los puertos de datos del sistema de almacenamiento
Redundancia: Normal
Nombre: DGDATA
Propósito: Archivos de datos
4MB
Data02
200GB
Data03
200GB
Data04
200GB
Data05
200GB
Data06
200GB
Data07
200GB
Data08
200GB
Data09
200GB
Data10
200GB
Grid01
1GB
Redundancia: Normal
Nombre: DGGRID1
Propósito: Grid: CRS y votación
4MB
Grid02
1GB
Grid03
1GB
Grid04
1GB
Redundancia: Normal
Nombre: DGGRID2
Propósito: Grid: CRS y votación
4MB
Grid05
1GB
Grid06
1GB
Redo01
100GB
Redundancia: Normal
Nombre: DGREDO1
Propósito: Registro de reenvío del hilo 1
4MB
Redo02
100GB
Redo03
100GB
Redo04
100GB
Redo05
100GB
Redo06
100GB
Redundancia: Normal
Nombre: DGREDO2
Propósito: Registro de reenvío del hilo 2
4MB
Redo07
100GB
Redo08
100GB
Redo09
100GB
Redo10
100GB
Configuraciones de la base de datos
- Tamaño de bloque = 8K
- Espacio de intercambio = 16GB
- Deshabilitar AMM (Gestión automática de memoria)
- Deshabilitar Transparent Huge Pages
Otras configuraciones
# vi /etc/sysctl.conf
✓ fs.aio-max-nr = 1048576
✓ fs.file-max = 6815744
✓ kernel.shmmax 103079215104
✓ kernel.shmall 31457280
✓ kernel.shmmn 4096
✓ kernel.sem = 250 32000 100 128
✓ net.ipv4.ip_local_port_range = 9000 65500
✓ net.core.rmem_default = 262144
✓ net.core.rmem_max = 4194304
✓ net.core.wmem_default = 262144
✓ net.core.wmem_max = 1048586
✓ vm.swappiness=10
✓ vm.min_free_kbytes=524288 # no establecer esto si estás usando Linux x86
✓ vm.vfs_cache_pressure=200
✓ vm.nr_hugepages = 57000
# vi /etc/security/limits.conf
✓ grid soft nproc 2047
✓ grid hard nproc 16384
✓ grid soft nofile 1024
✓ grid hard nofile 65536
✓ grid soft stack 10240
✓ grid hard stack 32768
✓ oracle soft nproc 2047
✓ oracle hard nproc 16384
✓ oracle soft nofile 1024
✓ oracle hard nofile 65536
✓ oracle soft stack 10240
✓ oracle hard stack 32768
✓ soft memlock 120795954
✓ hard memlock 120795954
sqlplus “/as sysdba”
alter system set processes=2000 scope=spfile;
alter system set open_cursors=2000 scope=spfile;
alter system set session_cached_cursors=300 scope=spfile;
alter system set db_files=8192 scope=spfile;
Prueba de resiliencia
Para la demostración se utilizó HammerDB para emular la carga OLTP. Configuración de HammerDB:
Número de almacenes
256
Transacciones totales por usuario
1000000000000
Usuarios virtuales
256
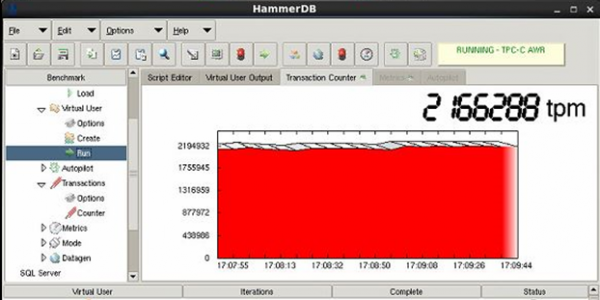
Como resultado se obtuvo un indicador de 2.1M TPM, lo que está lejos del límite de rendimiento del arreglo , pero es el "techo" para la configuración de hardware actual de los servidores (principalmente debido a los procesadores) y su cantidad. El objetivo de esta prueba sigue siendo demostrar la resiliencia de la solución en general, no alcanzar máximos de rendimiento. Así que simplemente partiremos de este número.
Prueba de falla de uno de los nodos
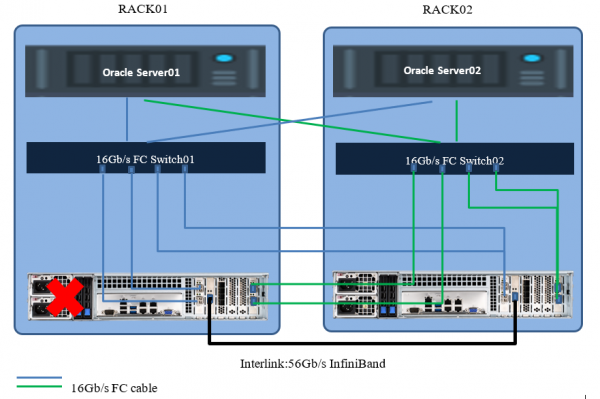
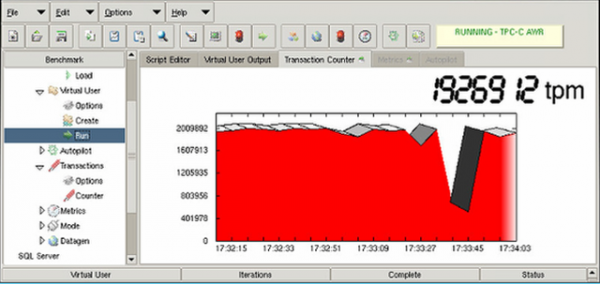
Los hosts perdieron parte de las rutas al almacenamiento, continuando trabajando a través de las restantes con el segundo nodo. El rendimiento cayó por unos segundos debido a la reconfiguración de rutas, y luego volvió a los niveles normales. No hubo interrupciones en el servicio.
Prueba de falla del armario con todo el equipo
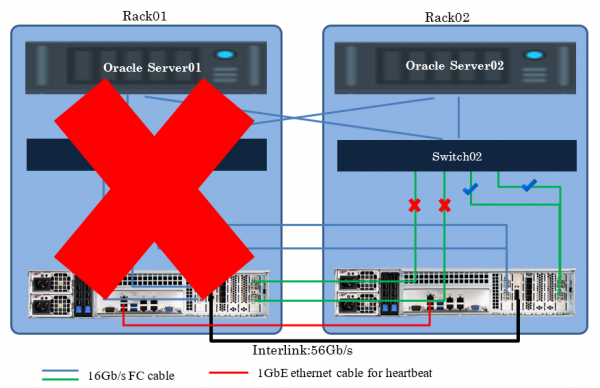
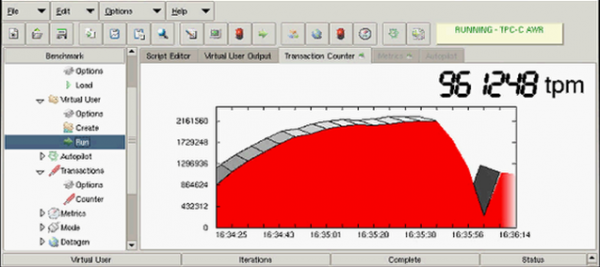
En este caso, el rendimiento también cayó por unos segundos debido a la reconfiguración de rutas, y luego volvió a la mitad del valor inicial. El resultado se redujo a la mitad de lo original debido a la exclusión de un servidor de aplicaciones. No hubo interrupciones en el servicio.
Si tiene necesidades de implementar una solución de recuperación ante desastres Cross-Rack con alta disponibilidad para Oracle a un costo razonable y con un esfuerzo mínimo de implementación/administración, la colaboración entre Oracle RAC y la arquitectura será una de las mejores opciones. En lugar de Oracle RAC, se puede utilizar cualquier otro software que contemple la agrupación, así como las mismas bases de datos o sistemas de virtualización, por ejemplo. El principio de construcción de la solución seguirá siendo el mismo. Y la métrica final será un valor cero para RTO y RPO.
Fuente: habr.com
