

Si utilizamos una base de datos de series temporales (timeseries db, ) como almacenamiento principal para un sitio de estadísticas, en lugar de resolver el problema, podríamos enfrentar muchos dolores de cabeza. Estoy trabajando en un proyecto que utiliza esta base, y a veces InfluxDB, de la que hablaremos, ha presentado sorpresas inesperadas.
Descargo de responsabilidad: los problemas mencionados se refieren a la versión InfluxDB 1.7.4.
¿Por qué series temporales?
El proyecto consiste en rastrear transacciones en diversas cadenas de bloques y mostrar estadísticas. En concreto, observamos la emisión y quema de stablecoins (). Con base en estas transacciones, se deben construir gráficos y mostrar tablas resumidas.
Al analizar las transacciones, surgió la idea: utilizar la base de datos de series temporales InfluxDB como almacenamiento principal. Las transacciones son puntos en el tiempo y se ajustan bien al modelo de series temporales.
Además, las funciones de agregación parecían muy convenientes: son ideales para procesar gráficos de períodos largos. El usuario necesita un gráfico de un año, pero en la base hay un conjunto de datos con un intervalo de cinco minutos. Enviarle los cien mil puntos es absurdo: además del largo procesamiento, no caben en la pantalla. Se puede escribir una implementación propia para aumentar el marco temporal o utilizar las funciones de agregación integradas en Influx. Con ellas se pueden agrupar los datos por días y enviar los 365 puntos necesarios.
Me desconcertaba un poco que normalmente estas bases se utilizan para recopilar métricas. Monitoreo de servidores, dispositivos IoT, todo lo que genera millones de puntos como: [ — ]. Pero si la base funciona bien con un gran flujo de datos, ¿por qué un volumen pequeño debería causar problemas? Con este pensamiento decidimos utilizar InfluxDB.
¿Qué más es conveniente en InfluxDB?
Además de las mencionadas funciones de agregación, hay otra cosa maravillosa — consultas continuas (). Este es un programador integrado en la base de datos que puede procesar datos programadamente. Por ejemplo, se puede agrupar todos los registros del día cada 24 horas, calcular el promedio y registrar un nuevo punto en otra tabla sin tener que escribir código propio.
También hay políticas de retención () — configuración para la eliminación de datos después de un período determinado. Es útil cuando, por ejemplo, se necesita almacenar la carga en la CPU durante una semana con mediciones cada segundo, mientras que a lo largo de un par de meses esa precisión no es necesaria. En tal situación, se podría hacer lo siguiente:
- crear una consulta continua para agregar datos en otra tabla;
- para la primera tabla, definir una política de eliminación de métricas que sean más antiguas que esa semana.
Y Influx se encargará de reducir automáticamente el tamaño de los datos y eliminar lo innecesario.
Sobre los datos almacenados
No se almacenan muchos datos: alrededor de 70,000 transacciones y un millón de puntos con información de mercado. La adición de nuevos registros es de no más de 3,000 puntos al día. También hay métricas del sitio, pero hay pocos datos y, según la política de retención, se almacenan por no más de un mes.
Problemas
Durante el desarrollo y posterior prueba del servicio, surgieron problemas cada vez más críticos al operar InfluxDB.
1. Eliminación de datos
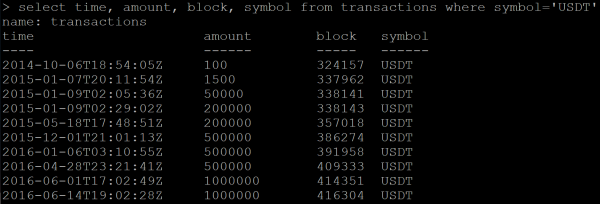
Hay una serie de datos con transacciones:
SELECT time, amount, block, symbol FROM transactions WHERE symbol='USDT'Resultado:
Envio el comando para eliminar datos:
DELETE FROM transactions WHERE symbol='USDT'Luego, realizo una consulta para obtener los datos que ya han sido eliminados. Y Influx, en lugar de una respuesta vacía, devuelve parte de los datos que deberían haber sido eliminados.
Intento eliminar la tabla completa:
DROP MEASUREMENT transactionsVerifico la eliminación de la tabla:
SHOW MEASUREMENTSNo veo la tabla en la lista, pero una nueva consulta de datos aún devuelve el mismo conjunto de transacciones.
El problema solo me ocurrió una vez, ya que el caso de eliminación es un incidente aislado. Pero este comportamiento de la base de datos claramente no se ajusta a un funcionamiento 'correcto'. Más tarde encontré una publicación abierta en github de casi un año sobre este tema.
Como resultado, ayudó la eliminación y posterior recuperación de toda la base.
2. Números de punto flotante
Los cálculos matemáticos al utilizar funciones integradas en InfluxDB dan errores de precisión. No es que esto sea algo inusual, pero es desagradable.
En mi caso, los datos tienen un componente financiero y me gustaría procesarlos con alta precisión. Debido a esto, tengo planes de renunciar a las consultas continuas.
3. Las consultas continuas no se pueden adaptar a diferentes zonas horarias
El servicio cuenta con una tabla de estadísticas diarias sobre transacciones. Para cada día, es necesario agrupar todas las transacciones de ese día. Sin embargo, cada usuario comenzará su día a diferentes horas, lo que significa que el conjunto de transacciones será distinto. En UTC hay de desplazamiento, para las cuales es necesario agregar los datos.
En InfluxDB, al agrupar por tiempo, se puede especificar un desplazamiento adicional, por ejemplo, para la hora de Moscú (UTC+3):
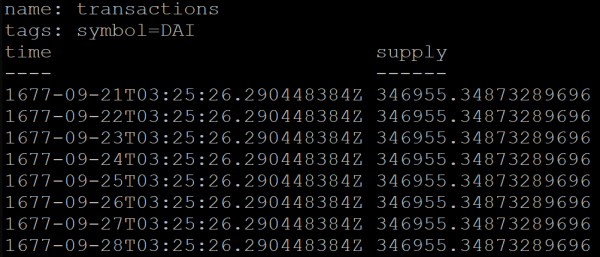
SELECT MEAN("supply") FROM transactions GROUP BY symbol, time(1d, 3h) fill(previous)Pero el resultado de la consulta será incorrecto. Por alguna razón, los datos agrupados por días comenzarán en 1677 (InfluxDB oficialmente soporta periodos de tiempo desde ese año):
Para sortear este problema, temporalmente trasladamos el servicio a UTC+0.
4. Rendimiento
En internet hay muchas comparaciones de benchmarks entre InfluxDB y otros DB. En un primer vistazo, parecían material de marketing, pero ahora creo que hay una parte de verdad en ellos.
Les contaré mi caso.
El servicio ofrece un método API que devuelve estadísticas de las últimas 24 horas. En los cálculos, el método consulta la base tres veces con estas consultas:
SELECT * FROM coins_info WHERE time <= NOW() GROUP BY symbol ORDER BY time DESC LIMIT 1SELECT * FROM dominance_info ORDER BY time DESC LIMIT 1SELECT * FROM transactions WHERE time >= NOW() - 24h ORDER BY time DESCExplicación:
- En la primera consulta, obtenemos los últimos puntos para cada moneda con datos del mercado. En mi caso, ocho puntos para ocho monedas.
- La segunda consulta obtiene el último punto más reciente.
- La tercera solicita una lista de transacciones de las últimas 24 horas, que pueden ser varios cientos.
Aclaro que en InfluxDB se construye automáticamente un índice por etiquetas y por tiempo, que acelera las consultas. En la primera consulta symbol — es una etiqueta.
Realicé una prueba de stress para este método API. Para 25 RPS, el servidor mostró una carga completa en seis CPU:
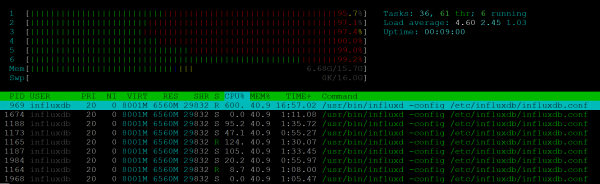
Mientras que el proceso NodeJs no generaba ninguna carga.
La velocidad de ejecución se degradó rápidamente a partir de 7-10 RPS: si un cliente podía recibir respuesta en 200 ms, diez clientes debían esperar un segundo. 25 RPS es la frontera en la que la estabilidad se vio afectada, los clientes recibían errores 500.
Con tal rendimiento, utilizar Influx en nuestro proyecto es imposible. Más aún: en un proyecto donde se debe mostrar el monitoreo a muchos clientes, pueden surgir problemas similares y el servidor de métricas se verá sobrecargado.
Salida
La conclusión más importante de la experiencia obtenida es que no se debe incorporar una tecnología desconocida en un proyecto sin un análisis adecuado. Un simple rastreo de tickets abiertos en GitHub podría haber proporcionado la información necesaria para no elegir InfluxDB como el almacén principal de datos.
InfluxDB parecía adecuada para las necesidades de mi proyecto, pero como demostró la práctica, esta base de datos no satisface las demandas y tiene muchos fallos.
En el repositorio del proyecto ya se puede encontrar la versión 2.0.0-beta, solo queda esperar que en la segunda versión haya mejoras significativas. Mientras tanto, iré a estudiar la documentación de TimescaleDB.
Fuente: habr.com
