

Ingeniero - en traducción del latín - inspirado.
El ingeniero puede hacerlo todo. (c) R.Diesel.
Epígrafes.
O la historia de por qué un administrador de bases de datos debe recordar su pasado como programador.
Prólogo
Todos los nombres han sido cambiados. Las coincidencias son casuales. El material representa exclusivamente la opinión personal del autor.
Descargo de responsabilidad: en el ciclo de artículos planeado no habrá una descripción detallada y precisa de las tablas y scripts utilizados. Los materiales no podrán ser utilizados de inmediato 'tal cual'.
Primero, debido al gran volumen de material,
y, en segundo lugar, debido a la adaptación con la base de producción del cliente real.
Por lo tanto, los artículos presentarán solo ideas y descripciones de manera muy general.
Quizás en el futuro el sistema crecerá hasta el nivel de subirlo a GitHub, o tal vez no. El tiempo lo dirá.
El comienzo de la historia - '».
Qué se ha logrado como resultado, en las líneas más generales - '»
¿Por qué me sirve todo esto?
Bueno, primero, para no olvidarlo, recordando en la jubilación esos gloriosos días.
En segundo lugar, para sistematizar lo escrito. Porque a veces yo mismo empiezo a confundir y olvidar partes individuales.
Y lo más importante: quizás a alguien le sirva y ayude a no reinventar la rueda y no tropezar con las mismas piedras. En otras palabras, mejorar su karma (no el de Habr). Porque lo más valioso en este mundo son las ideas. Lo principal es encontrar una idea. Y llevar una idea a la realidad es solo una cuestión técnica.
Así que, comencemos, poco a poco...
Planteamiento del problema.
Se tiene:
Base de datos PostgreSQL (10.5), de tipo de carga mixta (OLTP+DSS), de carga media-baja, ubicada en la nube de AWS.
El monitoreo de la base de datos está ausente, el monitoreo de la infraestructura está representado por las herramientas estándar de AWS en configuración mínima.
Requisitos:
Monitorear el rendimiento y estado de la base de datos, encontrar y tener información inicial para optimizar consultas pesadas a BDs.
Preámbulo breve o análisis de opciones de solución
Para empezar, intentemos desglosar las opciones de solución del problema desde el punto de vista del análisis comparativo de beneficios y desventajas para el ingeniero, mientras que los beneficios y pérdidas de la gerencia que se ocupen aquellos a quienes les corresponde según el organigrama.
Opción 1 - 'Trabajando por demanda'
Dejamos todo como está. Si al cliente no le gusta algo en el funcionamiento, rendimiento de la base de datos o de la aplicación, notificará a los ingenieros DBA por correo electrónico o creando un incidente en el sistema de tickets.
El ingeniero, al recibir la notificación, se encargará del problema, propondrá una solución o pospondrá el problema, esperando que todo se solucione por sí solo, ya que pronto se olvidará.
Galletas y buñuelos, contusiones y bultos.Galletas y buñuelos:
1. No hay que hacer nada innecesario.
2. Siempre hay una oportunidad de desentenderse y evadir responsabilidades.
3. Una gran cantidad de tiempo que se puede gastar a nuestro antojo.
Contusiones y bultos:
1. Tarde o temprano, el cliente se preguntará sobre la esencia de la existencia y la justicia universal en este mundo, y una vez más se hará la pregunta: ¿por qué les estoy pagando mi dinero? La consecuencia siempre es la misma: solo hay que esperar a que el cliente se aburra y se despida. Y la fuente se agotará. Es triste.
2. El desarrollo del ingeniero es nulo.
3. Dificultades en la planificación del trabajo y la carga de trabajo.
Opción 2 - "Bailamos con tambores, vendemos y calzamos."
Punto 1-¿Para qué necesitamos un sistema de monitoreo? Vamos a recibir todo mediante solicitudes. Haremos un montón de solicitudes al diccionario de datos y a vistas dinámicas, activaremos varios contadores, resumiremos todo en tablas, y de vez en cuando analizaremos listas y tablas. Como resultado, tendremos gráficos y tablas bonitos, o no tan bonitos. Lo importante es que sean muchos, muchos.
Punto 2-Generamos actividad, iniciamos el análisis de todo esto.
Punto 3-Preparamos un documento, llamamos a este documento, simplemente - "cómo debemos organizar la base de datos."
Punto 4-El cliente, al ver toda esta maravilla de gráficos y números, permanece en una ingenua confianza infantil - ahora todo funcionará, pronto. Y fácilmente y sin dolor se desprende de sus recursos financieros. La gerencia también está segura - nuestros ingenieros están trabajando mucho. La carga está al máximo.
Punto 5-Repetir regularmente el Punto 1.
Galletas y buñuelos, contusiones y bultos.Galletas y buñuelos:
1. La vida de los gerentes y los ingenieros es simple, predecible y está llena de actividad. Todo zumbando, todos ocupados.
2. La vida del cliente tampoco es mala - siempre está seguro de que solo necesita esperar un poco y todo se resolverá. No se resuelve, bueno, qué le vamos a hacer, este mundo es injusto, en la próxima vida le tocará.
Contusiones y bultos:
1. Tarde o temprano, aparecerá un proveedor más ágil de servicios similares que hará lo mismo, pero un poco más barato. Y si el resultado es el mismo, ¿por qué pagar más? Esto nuevamente llevará a la desaparición de la fuente de ingresos.
2. Es aburrido. Como lo es cualquier actividad poco significativa.
3. Al igual que en la opción anterior, no hay desarrollo. Pero para el ingeniero, hay una desventaja en que, a diferencia de la primera opción, aquí se necesita generar constantemente la base de datos de información. Y eso consume tiempo. Tiempo que podría gastarse en algo más beneficioso para uno mismo. Porque si no te cuidas, a nadie más le importa.
Opción 3: No es necesario reinventar la rueda, hay que comprarla y usarla.
Los ingenieros de otras empresas no comen pizza con cerveza sin razón (ah, buenos tiempos en San Petersburgo en los 90). Vamos a utilizar sistemas de monitoreo que ya están diseñados, ajustados y en funcionamiento, y que, en general, aportan beneficios (bueno, al menos a sus creadores).
Galletas y buñuelos, contusiones y bultos.Galletas y buñuelos:
1. No pierdas tiempo en inventar lo que ya ha sido creado. Tómalo y úsalo.
2. Los sistemas de monitoreo no son desarrollados por tontos y, por supuesto, son útiles.
3. Los sistemas de monitoreo operativos suelen proporcionar información útil y filtrada.
Contusiones y bultos:
1. En este caso, el ingeniero no es ingeniero, sino simplemente un usuario de un producto ajeno. O un usuario.
2. Hay que convencer al cliente de la necesidad de comprar algo en lo que, en general, no quiere involucrarse, ni debería; y el presupuesto para el año ya está aprobado y no cambiará. Luego, hay que asignar recursos, ajustarlos a un sistema específico. Es decir, primero hay que pagar, pagar y volver a pagar. Y el cliente es tacaño. Eso es la norma de la vida.
¿Qué hacer, Chernyshevski? Tu pregunta es muy apropiada. (c)
En este caso concreto y dadas las circunstancias, se puede actuar un poco diferente — ¿Y si hacemos nuestro propio sistema de monitoreo?
Bueno, no un sistema en el verdadero sentido de la palabra, esto es demasiado fuerte y presuntuoso, pero al menos aliviar un poco la tarea y recopilar más información para resolver incidentes de rendimiento. Para no encontrarse en la situación de 've allá, no sé dónde, encuentra eso, no sé qué'.
¿Cuáles son las ventajas y desventajas de esta opción?
Pros:
1. Es interesante. Al menos es más interesante que los constantes 'shrink datafile, alter tablespace, etc.'.
2. Estas son nuevas habilidades y un nuevo desarrollo. Que en el futuro, tarde o temprano, dará las recompensas y beneficios merecidos.
Desventajas:
1. Tendremos que trabajar. Trabajar mucho.
2. Tendremos que explicar regularmente el significado y las perspectivas de toda la actividad.
3. Tendremos que sacrificar algo, ya que el único recurso disponible para el ingeniero — el tiempo — está limitado por el universo.
4. Lo más aterrador y desagradable — como resultado, podría salir algo como "Ni ratón, ni rana, sino una criatura desconocida."
Quién no arriesga, no bebe champán.
Así que — comienza lo más interesante.
La idea general — de manera esquemática
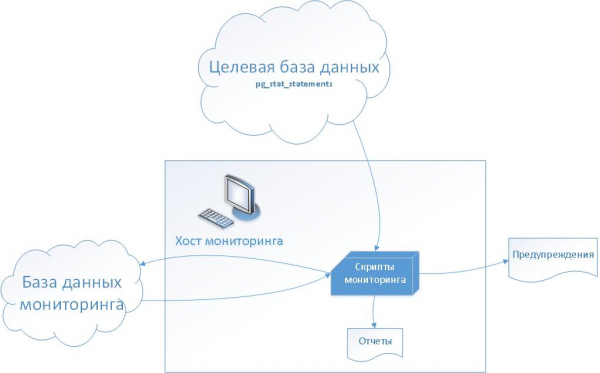
(La ilustración fue tomada de un artículo «»)
Explicación:
- En la base de datos objetivo se instala la extensión estándar de PostgreSQL — "pg_stat_statements".
- En la base de datos de monitoreo, creamos un conjunto de tablas de servicio para almacenar la historia de pg_stat_statements en la etapa inicial y para configurar métricas y monitoreo en el futuro.
- En el host de monitoreo, creamos un conjunto de scripts bash, incluyendo para la generación de incidentes en el sistema de tickets.
Tablas de servicio
Para comenzar, un diagrama ERD simplificado, ¿qué es lo que se obtuvo al final?
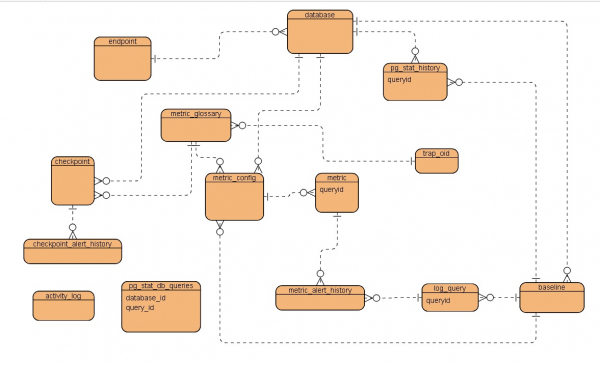
Descripción breve de las tablasendpoint — host, punto de conexión a la instancia
database — parámetros de la base de datos
pg_stat_history — tabla histórica para almacenar las instantáneas temporales de la vista pg_stat_statements de la base de datos objetivo
metric_glossary — glosario de métricas de rendimiento
metric_config — configuración de métricas individuales
metric — métrica específica para la consulta que se está monitoreando
metric_alert_history — historial de alertas de rendimiento
log_query — tabla de servicio para almacenar los registros analizados del archivo de log de PostgreSQL cargados desde AWS
baseline — parámetros de los períodos temporales utilizados como base
checkpoint — configuración de las métricas de verificación del estado de la base de datos
checkpoint_alert_history — historial de alertas de las métricas de verificación del estado de la base de datos
pg_stat_db_queries — tabla de servicio para consultas activas
activity_log — tabla de servicio para el registro de actividades
trap_oid — tabla de servicio para la configuración de trap
Etapa 1 — recopilamos información estadística sobre el rendimiento y obtenemos informes
La tabla sirve para almacenar la información estadística pg_stat_history
Estructura de la tabla pg_stat_history
                                          Tabla "public.pg_stat_history"
       Columna         |            Tipo             |                          Modificadores
---------------------+-----------------------------+-------------------------------------------
 id                  | entero                     | no nulo por defecto nextval('pg_stat_history_id_seq'::regclass)
 snapshot_timestamp  | timestamp sin zona horaria |
 database_id         | entero                     |
 dbid                | oid                         |
 userid              | oid                         |
 queryid             | bigint                      |
 query               | texto                       |
 calls               | bigint                      |
 total_time          | doble precisión             |
 min_time            | doble precisión             |
 max_time            | doble precisión             |
 mean_time           | doble precisión             |
 stddev_time         | doble precisión             |
 rows                | bigint                      |
 shared_blks_hit     | bigint                      |
 shared_blks_read    | bigint                      |
 shared_blks_dirtied | bigint                      |
 shared_blks_written | bigint                      |
 local_blks_hit      | bigint                      |
 local_blks_read     | bigint                      |
 local_blks_dirtied  | bigint                      |
 local_blks_written  | bigint                      |
 temp_blks_read      | bigint                      |
 temp_blks_written   | bigint                      |
 blk_read_time       | doble precisión             |
 blk_write_time      | doble precisión             |
 baseline_id         | entero                     |
Índices:
    "pg_stat_history_pkey" CLAVE PRIMARIA, btree (id)
    "database_idx" btree (database_id)
    "queryid_idx" btree (queryid)
    "snapshot_timestamp_idx" btree (snapshot_timestamp)
Restricciones de clave foránea:
    "database_id_fk" CLAVE FORÁNEA (database_id) REFERENCIAS database(id) AL ELIMINAR CASCADA
Como se puede ver, la tabla es solo datos acumulativos de la vista pg_stat_statements en la base de datos de destino.
El uso de esta tabla es muy sencillo
pg_stat_history representará la estadística acumulada de ejecución de consultas por cada hora. Al inicio de cada hora, después de llenar la tabla, la estadística pg_stat_statements se restablece usando pg_stat_statements_reset().
Nota: la estadística se recopila para consultas con un tiempo de ejecución superior a 1 segundo.
Llenado de la tabla pg_stat_history
--pg_stat_history.sql
CREATE OR REPLACE FUNCTION pg_stat_history( ) RETURNS boolean AS $$
DECLARE
  endpoint_rec record ;
  database_rec record ;
  pg_stat_snapshot record ;
  current_snapshot_timestamp timestamp without time zone;
BEGIN
  current_snapshot_timestamp = date_trunc('minute',now());

  FOR endpoint_rec IN SELECT * FROM endpoint
  LOOP
    FOR database_rec IN SELECT * FROM database WHERE endpoint_id = endpoint_rec.id
	  LOOP

		RAISE NOTICE 'SE ESTÁ CREANDO UN NUEVO GRUPO';

		--Conectarse a la base de datos objetivo
	    EXECUTE 'SELECT dblink_connect(''LINK1'',''host='||endpoint_rec.host||' dbname='||database_rec.name||' user=USER password=PASSWORD '')';

        RAISE NOTICE 'host % y dbname % ',endpoint_rec.host,database_rec.name;
		RAISE NOTICE 'Creando grupo de pg_stat_statements para la base de datos %',database_rec.name;

		SELECT
	      *
		INTO
		  pg_stat_snapshot
	    FROM dblink('LINK1',
	      'SELECT
	       dbid , SUM(calls),SUM(total_time),SUM(rows) ,SUM(shared_blks_hit) ,SUM(shared_blks_read) ,SUM(shared_blks_dirtied) ,SUM(shared_blks_written) ,
           SUM(local_blks_hit) , SUM(local_blks_read) , SUM(local_blks_dirtied) , SUM(local_blks_written) , SUM(temp_blks_read) , SUM(temp_blks_written) , SUM(blk_read_time) , SUM(blk_write_time)
	       FROM pg_stat_statements WHERE dbid=(SELECT oid from pg_database where datname=current_database() )
		   GROUP BY dbid
  	      '
	               )
	      AS t
	       ( dbid oid , calls bigint ,
  	         total_time double precision ,
	         rows bigint , shared_blks_hit bigint , shared_blks_read bigint ,shared_blks_dirtied bigint ,shared_blks_written	 bigint ,
             local_blks_hit	 bigint ,local_blks_read bigint , local_blks_dirtied bigint ,local_blks_written bigint ,
             temp_blks_read	 bigint ,temp_blks_written bigint ,
             blk_read_time double precision , blk_write_time double precision
	       );

		INSERT INTO pg_stat_history
          (
		    snapshot_timestamp  ,database_id  ,
			dbid , calls  ,total_time ,
            rows ,shared_blks_hit  ,shared_blks_read  ,shared_blks_dirtied  ,shared_blks_written ,local_blks_hit ,
            local_blks_read,local_blks_dirtied,local_blks_written,temp_blks_read,temp_blks_written,
            blk_read_time, blk_write_time
		  )
	    VALUES
	      (
	       current_snapshot_timestamp ,
		   database_rec.id ,
	       pg_stat_snapshot.dbid ,pg_stat_snapshot.calls,
	       pg_stat_snapshot.total_time,
	       pg_stat_snapshot.rows ,pg_stat_snapshot.shared_blks_hit ,pg_stat_snapshot.shared_blks_read ,pg_stat_snapshot.shared_blks_dirtied ,pg_stat_snapshot.shared_blks_written ,
           pg_stat_snapshot.local_blks_hit , pg_stat_snapshot.local_blks_read , pg_stat_snapshot.local_blks_dirtied , pg_stat_snapshot.local_blks_written ,
	       pg_stat_snapshot.temp_blks_read , pg_stat_snapshot.temp_blks_written , pg_stat_snapshot.blk_read_time , pg_stat_snapshot.blk_write_time
	      );

        RAISE NOTICE 'Creando grupo de pg_stat_statements para consultas con min_time mayor a 1000ms';

        FOR pg_stat_snapshot IN
          --Todas las consultas con max_time superior a 1000 ms
	      SELECT
	        *
	      FROM dblink('LINK1',
	        'SELECT
	         dbid , userid ,queryid,query,calls,total_time,min_time ,max_time,mean_time, stddev_time ,rows ,shared_blks_hit ,
			 shared_blks_read ,shared_blks_dirtied ,shared_blks_written ,
             local_blks_hit , local_blks_read , local_blks_dirtied ,
			 local_blks_written , temp_blks_read , temp_blks_written , blk_read_time ,
			 blk_write_time
	         FROM pg_stat_statements
			 WHERE dbid=(SELECT oid from pg_database where datname=current_database() AND min_time >= 1000 )
  	        '

	                  )
	        AS t
	         ( dbid oid , userid oid , queryid bigint ,query text , calls bigint ,
  	           total_time double precision ,min_time double precision	 ,max_time double precision	 , mean_time double precision	 ,  stddev_time double precision	 ,
	           rows bigint , shared_blks_hit bigint , shared_blks_read bigint ,shared_blks_dirtied bigint ,shared_blks_written	 bigint ,
               local_blks_hit	 bigint ,local_blks_read bigint , local_blks_dirtied bigint ,local_blks_written bigint ,
               temp_blks_read	 bigint ,temp_blks_written bigint ,
               blk_read_time double precision , blk_write_time double precision
	         )
	    LOOP
		  INSERT INTO pg_stat_history
          (
		    snapshot_timestamp  ,database_id  ,
			dbid ,userid  , queryid  , query  , calls  ,total_time ,min_time ,max_time ,mean_time ,stddev_time ,
            rows ,shared_blks_hit  ,shared_blks_read  ,shared_blks_dirtied  ,shared_blks_written ,local_blks_hit ,
            local_blks_read,local_blks_dirtied,local_blks_written,temp_blks_read,temp_blks_written,
            blk_read_time, blk_write_time
		  )
	      VALUES
	      (
	       current_snapshot_timestamp ,
		   database_rec.id ,
	       pg_stat_snapshot.dbid ,pg_stat_snapshot.userid ,pg_stat_snapshot.queryid,pg_stat_snapshot.query,pg_stat_snapshot.calls,
	       pg_stat_snapshot.total_time,pg_stat_snapshot.min_time ,pg_stat_snapshot.max_time,pg_stat_snapshot.mean_time, pg_stat_snapshot.stddev_time ,
	       pg_stat_snapshot.rows ,pg_stat_snapshot.shared_blks_hit ,pg_stat_snapshot.shared_blks_read ,pg_stat_snapshot.shared_blks_dirtied ,pg_stat_snapshot.shared_blks_written ,
           pg_stat_snapshot.local_blks_hit , pg_stat_snapshot.local_blks_read , pg_stat_snapshot.local_blks_dirtied , pg_stat_snapshot.local_blks_written ,
	       pg_stat_snapshot.temp_blks_read , pg_stat_snapshot.temp_blks_written , pg_stat_snapshot.blk_read_time , pg_stat_snapshot.blk_write_time
	      );

        END LOOP;

        PERFORM dblink_disconnect('LINK1');

	  END LOOP ;--FOR database_rec IN SELECT * FROM database WHERE endpoint_id = endpoint_rec.id

  END LOOP;

RETURN TRUE;
END
$$ LANGUAGE plpgsql;
Como resultado, después de un tiempo en la tabla pg_stat_history tendremos un conjunto de instantáneas del contenido de la tabla pg_stat_statements de la base de datos objetivo.
Generación de informes
Usando consultas simples, se pueden obtener informes bastante útiles e interesantes.
Datos agregados durante un período de tiempo específico
Consulta
SELECT
  database_id ,
  SUM(calls) AS calls ,SUM(total_time)  AS total_time ,
  SUM(rows) AS rows , SUM(shared_blks_hit)  AS shared_blks_hit,
  SUM(shared_blks_read) AS shared_blks_read ,
  SUM(shared_blks_dirtied) AS shared_blks_dirtied,
  SUM(shared_blks_written) AS shared_blks_written ,
  SUM(local_blks_hit) AS local_blks_hit ,
  SUM(local_blks_read) AS local_blks_read ,
  SUM(local_blks_dirtied) AS local_blks_dirtied ,
  SUM(local_blks_written)  AS local_blks_written,
  SUM(temp_blks_read) AS temp_blks_read,
  SUM(temp_blks_written) temp_blks_written ,
  SUM(blk_read_time) AS blk_read_time ,
  SUM(blk_write_time) AS blk_write_time
FROM
  pg_stat_history
WHERE
  queryid IS NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT
GROUP BY database_id ;
Tiempo de DB
to_char(interval ‘1 millisecond’ * pg_total_stat_history_rec.total_time, ‘HH24:MI:SS.MS’)
Tiempo de I/O
to_char(interval ‘1 millisecond’ * ( pg_total_stat_history_rec.blk_read_time + pg_total_stat_history_rec.blk_write_time ), ‘HH24:MI:SS.MS’)
TOP10 SQL por total_time
Consulta
SELECT
  queryid ,
  SUM(calls) AS calls ,
  SUM(total_time)  AS total_time
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id = DATABASE_ID AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT
GROUP BY queryid
ORDER BY 3 DESC
LIMIT 10
------------------------------------------------------------------------------------- | TOP10 SQL POR TIEMPO TOTAL DE EJECUCIÓN | #| queryid| calls| % de llamadas| tiempo_total (ms) | % dbtime +----+-----------+-----------+-----------+--------------------------------+---------- | 1| 821760255| 2| .00001|00:03:23.141( 203141.681 ms.)| 5.42 | 2| 4152624390| 2| .00001|00:03:13.929( 193929.215 ms.)| 5.17 | 3| 1484454471| 4| .00001|00:02:09.129( 129129.057 ms.)| 3.44 | 4| 655729273| 1| .00000|00:02:01.869( 121869.981 ms.)| 3.25 | 5| 2460318461| 1| .00000|00:01:33.113( 93113.835 ms.)| 2.48 | 6| 2194493487| 4| .00001|00:00:17.377( 17377.868 ms.)| .46 | 7| 1053044345| 1| .00000|00:00:06.156( 6156.352 ms.)| .16 | 8| 3644780286| 1| .00000|00:00:01.063( 1063.830 ms.)| .03
TOP10 SQL por tiempo total de I/O
Consulta
SELECT
  queryid ,
  SUM(calls) AS calls ,
  SUM(blk_read_time + blk_write_time)  AS io_time
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT
GROUP BY  queryid
ORDER BY 3 DESC
LIMIT 10
---------------------------------------------------------------------------------------- | TOP10 SQL POR TIEMPO TOTAL DE I/O | #| queryid| llamadas| % de llamadas| Tiempo I/O (ms)|% de tiempo de I/O de la base de datos +----+-----------+-----------+-----------+--------------------------------+------------- | 1| 4152624390| 2| .00001|00:08:31.616( 511616.592 ms.)| 31.06 | 2| 821760255| 2| .00001|00:08:27.099( 507099.036 ms.)| 30.78 | 3| 655729273| 1| .00000|00:05:02.209( 302209.137 ms.)| 18.35 | 4| 2460318461| 1| .00000|00:04:05.981( 245981.117 ms.)| 14.93 | 5| 1484454471| 4| .00001|00:00:39.144( 39144.221 ms.)| 2.38 | 6| 2194493487| 4| .00001|00:00:18.182( 18182.816 ms.)| 1.10 | 7| 1053044345| 1| .00000|00:00:16.611( 16611.722 ms.)| 1.01 | 8| 3644780286| 1| .00000|00:00:00.436( 436.205 ms.)| .03
TOP10 SQL por tiempo máximo de ejecución
Consulta
SELECT
  id AS snapshotid ,
  queryid ,
  snapshot_timestamp ,
  max_time
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT
ORDER BY 4 DESC
LIMIT 10
----------------------------------------------------------------------------------------- | TOP10 SQL POR TIEMPO MÁXIMO DE EJECUCIÓN | #| snapshot| snapshotID| queryid| max_time (ms) +----+------------------+-----------+-----------+---------------------------------------- | 1| 05.04.2019 01:03| 4169| 655729273| 00:02:01.869( 121869.981 ms.) | 2| 04.04.2019 17:00| 4153| 821760255| 00:01:41.570( 101570.841 ms.) | 3| 04.04.2019 16:00| 4146| 821760255| 00:01:41.570( 101570.841 ms.) | 4| 04.04.2019 16:00| 4144| 4152624390| 00:01:36.964( 96964.607 ms.) | 5| 04.04.2019 17:00| 4151| 4152624390| 00:01:36.964( 96964.607 ms.) | 6| 05.04.2019 10:00| 4188| 1484454471| 00:01:33.452( 93452.150 ms.) | 7| 04.04.2019 17:00| 4150| 2460318461| 00:01:33.113( 93113.835 ms.) | 8| 04.04.2019 15:00| 4140| 1484454471| 00:00:11.892( 11892.302 ms.) | 9| 04.04.2019 16:00| 4145| 1484454471| 00:00:11.892( 11892.302 ms.) | 10| 04.04.2019 17:00| 4152| 1484454471| 00:00:11.892( 11892.302 ms.)
TOP10 SQL por lectura/escritura en buffer compartido
Consulta
SELECT
  id AS snapshotid ,
  queryid ,
  snapshot_timestamp ,
  shared_blks_read ,
  shared_blks_written
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT AND
  ( shared_blks_read > 0 OR shared_blks_written > 0 )
ORDER BY 4 DESC  , 5 DESC
LIMIT 10
-------------------------------------------------------------------------------------------- | TOP10 SQL POR LECTURA/ESCRITURA DE BUFFER COMPARTIDO | #| instantánea| snapshotID| queryid| bloques compartidos leídos| bloques compartidos escritos +----+------------------+-----------+-----------+---------------------+--------------------- | 1| 04.04.2019 17:00| 4153| 821760255| 797308| 0 | 2| 04.04.2019 16:00| 4146| 821760255| 797308| 0 | 3| 05.04.2019 01:03| 4169| 655729273| 797158| 0 | 4| 04.04.2019 16:00| 4144| 4152624390| 756514| 0 | 5| 04.04.2019 17:00| 4151| 4152624390| 756514| 0 | 6| 04.04.2019 17:00| 4150| 2460318461| 734117| 0 | 7| 04.04.2019 17:00| 4155| 3644780286| 52973| 0 | 8| 05.04.2019 01:03| 4168| 1053044345| 52818| 0 | 9| 04.04.2019 15:00| 4141| 2194493487| 52813| 0 | 10| 04.04.2019 16:00| 4147| 2194493487| 52813| 0 --------------------------------------------------------------------------------------------
Histograma de distribución de consultas por el tiempo máximo de ejecución
Consultas
SELECT
  MIN(max_time) AS hist_min  ,
  MAX(max_time) AS hist_max ,
  (( MAX(max_time) - MIN(min_time) ) / hist_columns ) as hist_width
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT ;

SELECT
  SUM(calls) AS calls
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id =DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT AND
  ( max_time >= hist_current_min AND  max_time < hist_current_max ) ;
|-----------------------------------------------------------------------------------------------
| HISTOGRAMA DE MAX_TIME
| TOTAL DE LLAMADAS : 33851920
| TIEMPO MÍNIMO  : 00:00:01.063
| TIEMPO MÁXIMO  : 00:02:01.869
---------------------------------------------------------------------------------
|                      duración mínima|                      duración máxima|     llamadas
+----------------------------------+----------------------------------+----------
| 00:00:01.063(      1063.830 ms.) | 00:00:13.144(     13144.445 ms.) | 9
| 00:00:13.144(     13144.445 ms.) | 00:00:25.225(     25225.060 ms.) | 0
| 00:00:25.225(     25225.060 ms.) | 00:00:37.305(     37305.675 ms.) | 0
| 00:00:37.305(     37305.675 ms.) | 00:00:49.386(     49386.290 ms.) | 0
| 00:00:49.386(     49386.290 ms.) | 00:01:01.466(     61466.906 ms.) | 0
| 00:01:01.466(     61466.906 ms.) | 00:01:13.547(     73547.521 ms.) | 0
| 00:01:13.547(     73547.521 ms.) | 00:01:25.628(     85628.136 ms.) | 0
| 00:01:25.628(     85628.136 ms.) | 00:01:37.708(     97708.751 ms.) | 4
| 00:01:37.708(     97708.751 ms.) | 00:01:49.789(    109789.366 ms.) | 2
| 00:01:49.789(    109789.366 ms.) | 00:02:01.869(    121869.981 ms.) | 0
TOP10 Instantáneas por Consulta por Segundo
Consultas
--pg_qps.sql
--Calcular Consultas Por Segundo
CREATE OR REPLACE FUNCTION pg_qps( pg_stat_history_id integer ) RETURNS double precision AS $$
DECLARE
 pg_stat_history_rec record ;
 prev_pg_stat_history_id integer ;
 prev_pg_stat_history_rec record;
 total_seconds double precision ;
 result double precision;
BEGIN
  result = 0 ;

  SELECT *
  INTO pg_stat_history_rec
  FROM
    pg_stat_history
  WHERE id = pg_stat_history_id ;

  IF pg_stat_history_rec.snapshot_timestamp IS NULL
  THEN
    RAISE EXCEPTION 'ERROR - No se encontró pg_stat_history para id = %',pg_stat_history_id;
  END IF ;

 --RAISE NOTICE 'pg_stat_history_id = % , snapshot_timestamp = %', pg_stat_history_id ,
 pg_stat_history_rec.snapshot_timestamp ;

  SELECT
    MAX(id)
  INTO
    prev_pg_stat_history_id
  FROM
    pg_stat_history
  WHERE
    database_id = pg_stat_history_rec.database_id AND
	queryid IS NULL AND
	id  0
  THEN
    result = pg_stat_history_rec.calls / total_seconds ;
  ELSE
   result = 0 ;
  END IF;

 RETURN result ;
END
$$ LANGUAGE plpgsql;


SELECT
  id ,
  snapshot_timestamp ,
  calls ,
  total_time ,
  ( select pg_qps( id )) AS QPS ,
  blk_read_time ,
  blk_write_time
FROM
  pg_stat_history
WHERE
  queryid IS NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT AND
  ( select pg_qps( id )) IS NOT NULL
ORDER BY 5 DESC
LIMIT 10
|-----------------------------------------------------------------------------------------------
| TOP10 Instantáneas ordenadas por números de QueryPerSeconds
-----------------------------------------------------------------------------------------------------------------------------------------------
|    #|          instantánea| snapshotID|      llamadas|                      tiempo total db|        QPS|                          tiempo I/O| % tiempo I/O
+-----+------------------+-----------+-----------+----------------------------------+-----------+----------------------------------+-----------
|    1|  04.04.2019 20:04|       4161|    5758631|  00:06:30.513(    390513.926 ms.)|   1573.396|  00:00:01.470(      1470.110 ms.)|       .376
|    2|  04.04.2019 17:00|       4149|    3529197|  00:11:48.830(    708830.618 ms.)|    980.332|  00:12:47.834(    767834.052 ms.)|    108.324
|    3|  04.04.2019 16:00|       4143|    3525360|  00:10:13.492(    613492.351 ms.)|    979.267|  00:08:41.396(    521396.555 ms.)|     84.988
|    4|  04.04.2019 21:03|       4163|    2781536|  00:03:06.470(    186470.979 ms.)|    785.745|  00:00:00.249(       249.865 ms.)|       .134
|    5|  04.04.2019 19:03|       4159|    2890362|  00:03:16.784(    196784.755 ms.)|    776.979|  00:00:01.441(      1441.386 ms.)|       .732
|    6|  04.04.2019 14:00|       4137|    2397326|  00:04:43.033(    283033.854 ms.)|    665.924|  00:00:00.024(        24.505 ms.)|       .009
|    7|  04.04.2019 15:00|       4139|    2394416|  00:04:51.435(    291435.010 ms.)|    665.116|  00:00:12.025(     12025.895 ms.)|      4.126
|    8|  04.04.2019 13:00|       4135|    2373043|  00:04:26.791(    266791.988 ms.)|    659.179|  00:00:00.064(        64.261 ms.)|       .024
|    9|  05.04.2019 01:03|       4167|    4387191|  00:06:51.380(    411380.293 ms.)|    609.332|  00:05:18.847(    318847.407 ms.)|     77.507
|   10|  04.04.2019 18:01|       4157|    1145596|  00:01:19.217(     79217.372 ms.)|    313.004|  00:00:01.319(      1319.676 ms.)|      1.666
Registro de Ejecución Horaria con QueryPerSeconds y Tiempo I/O
Consulta
SELECT
  id ,
  snapshot_timestamp ,
  llamadas ,
  tiempo_total ,
  ( select pg_qps( id )) AS QPS ,
  blk_read_time ,
  blk_write_time
FROM
  pg_stat_history
WHERE
  queryid IS NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT
ORDER BY 2
|-----------------------------------------------------------------------------------------------
| HISTORIAL DE EJECUCIÓN POR HORA CON QueryPerSeconds y Tiempo de I/O
-----------------------------------------------------------------------------------------------------------------------------------------------
| HISTORIAL DE CONSULTAS POR SEGUNDO
|    #|          instantánea| snapshotID|      llamadas|                      tiempo total db|        QPS|                          tiempo de I/O| % de tiempo de I/O
+-----+------------------+-----------+-----------+----------------------------------+-----------+----------------------------------+-----------
|    1|  04.04.2019 11:00|       4131|       3747|  00:00:00.835(       835.374 ms.)|      1.041|  00:00:00.000(          .000 ms.)|       .000
|    2|  04.04.2019 12:00|       4133|    1002722|  00:01:52.419(    112419.376 ms.)|    278.534|  00:00:00.149(       149.105 ms.)|       .133
|    3|  04.04.2019 13:00|       4135|    2373043|  00:04:26.791(    266791.988 ms.)|    659.179|  00:00:00.064(        64.261 ms.)|       .024
|    4|  04.04.2019 14:00|       4137|    2397326|  00:04:43.033(    283033.854 ms.)|    665.924|  00:00:00.024(        24.505 ms.)|       .009
|    5|  04.04.2019 15:00|       4139|    2394416|  00:04:51.435(    291435.010 ms.)|    665.116|  00:00:12.025(     12025.895 ms.)|      4.126
|    6|  04.04.2019 16:00|       4143|    3525360|  00:10:13.492(    613492.351 ms.)|    979.267|  00:08:41.396(    521396.555 ms.)|     84.988
|    7|  04.04.2019 17:00|       4149|    3529197|  00:11:48.830(    708830.618 ms.)|    980.332|  00:12:47.834(    767834.052 ms.)|    108.324
|    8|  04.04.2019 18:01|       4157|    1145596|  00:01:19.217(     79217.372 ms.)|    313.004|  00:00:01.319(      1319.676 ms.)|      1.666
|    9|  04.04.2019 19:03|       4159|    2890362|  00:03:16.784(    196784.755 ms.)|    776.979|  00:00:01.441(      1441.386 ms.)|       .732
|   10|  04.04.2019 20:04|       4161|    5758631|  00:06:30.513(    390513.926 ms.)|   1573.396|  00:00:01.470(      1470.110 ms.)|       .376
|   11|  04.04.2019 21:03|       4163|    2781536|  00:03:06.470(    186470.979 ms.)|    785.745|  00:00:00.249(       249.865 ms.)|       .134
|   12|  04.04.2019 23:03|       4165|    1443155|  00:01:34.467(     94467.539 ms.)|    200.438|  00:00:00.015(        15.287 ms.)|       .016
|   13|  05.04.2019 01:03|       4167|    4387191|  00:06:51.380(    411380.293 ms.)|    609.332|  00:05:18.847(    318847.407 ms.)|     77.507
|   14|  05.04.2019 02:03|       4171|     189852|  00:00:10.989(     10989.899 ms.)|     52.737|  00:00:00.539(       539.110 ms.)|      4.906
|   15|  05.04.2019 03:01|       4173|       3627|  00:00:00.103(       103.000 ms.)|      1.042|  00:00:00.004(         4.131 ms.)|      4.010
|   16|  05.04.2019 04:00|       4175|       3627|  00:00:00.085(        85.235 ms.)|      1.025|  00:00:00.003(         3.811 ms.)|      4.471
|   17|  05.04.2019 05:00|       4177|       3747|  00:00:00.849(       849.454 ms.)|      1.041|  00:00:00.006(         6.124 ms.)|       .721
|   18|  05.04.2019 06:00|       4179|       3747|  00:00:00.849(       849.561 ms.)|      1.041|  00:00:00.000(          .051 ms.)|       .006
|   19|  05.04.2019 07:00|       4181|       3747|  00:00:00.839(       839.416 ms.)|      1.041|  00:00:00.000(          .062 ms.)|       .007
|   20|  05.04.2019 08:00|       4183|       3747|  00:00:00.846(       846.382 ms.)|      1.041|  00:00:00.000(          .007 ms.)|       .001
|   21|  05.04.2019 09:00|       4185|       3747|  00:00:00.855(       855.426 ms.)|      1.041|  00:00:00.000(          .065 ms.)|       .008
|   22|  05.04.2019 10:00|       4187|       3797|  00:01:40.150(    100150.165 ms.)|      1.055|  00:00:21.845(     21845.217 ms.)|     21.812
Texto de todas las selecciones SQL
Consulta
SELECCIONAR
  queryid ,
  query
DE
  pg_stat_history
DONDE
  queryid NO ES NULO Y
  database_id = DATABASE_ID Y
  snapshot_timestamp ENTRE BEGIN_TIMEPOINT Y END_TIMEPOINT
AGRUPAR POR queryid , query
Summary
Como se puede ver, con recursos bastante simples, se puede obtener mucha información útil sobre la carga y el estado de la base de datos.
Nota:Si registramos queryid en las consultas, obtendremos el historial de una consulta específica (por razones de ahorro de espacio, los informes para consultas individuales se omiten).
Así que, los datos estadísticos sobre el rendimiento de las consultas están disponibles y se están recopilando.
La primera etapa "recogida de datos estadísticos" ha concluido.
Ahora podemos pasar a la segunda etapa: "ajuste de métricas de rendimiento".
Pero esa es otra historia completamente diferente.
Continuará...
Fuente: habr.com
