

¡Hola, Habr!
Recordamos que, después del libro sobre hemos publicado una obra igualmente interesante sobre la biblioteca .
Mientras la comunidad aún explora los límites de las capacidades de esta poderosa herramienta. Recientemente se publicó un artículo con el que queremos familiarizarles. En su propia experiencia, el autor narra cómo convertir Kafka Streams en un almacén de datos distribuido. ¡Disfruten la lectura!
La biblioteca Apache se utiliza en todo el mundo en empresas para el procesamiento de flujos distribuidos sobre Apache Kafka. Uno de los aspectos infravalorados de este marco es que permite almacenar un estado local, generado a partir del procesamiento de flujos.
En este artículo, contaré cómo nuestra empresa logró aprovechar esta posibilidad de manera rentable en el desarrollo de un producto de seguridad para aplicaciones en la nube. Con la ayuda de Kafka Streams, creamos microservicios con estado compartido, cada uno de los cuales sirve como una fuente confiable y altamente disponible de información sobre el estado de los objetos en el sistema. Para nosotros, esto representa un avance tanto en términos de confiabilidad como en la facilidad de mantenimiento.
Si te interesa un enfoque alternativo que permita utilizar una única base de datos central para mantener el estado formal de tus objetos, sigue leyendo, será interesante...
Por qué consideramos que llegó el momento de cambiar nuestros enfoques sobre la gestión del estado compartido
Necesitábamos mantener el estado de varios objetos, basándonos en informes de agentes (por ejemplo: ¿el sitio fue atacado?). Antes de cambiar a Kafka Streams, a menudo dependíamos de una única base de datos central (+ API de servicio) para gestionar el estado. Este enfoque tiene sus desventajas: en el mantenimiento de la consistencia y sincronización se convierte en un verdadero desafío. La base de datos puede convertirse en un cuello de botella, o verse en y sufrir impredecibilidad.
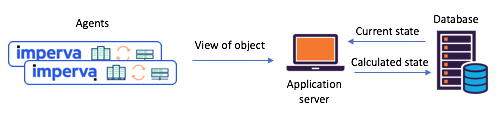
Ilustración 1: un escenario típico de separación de estado que se experimentó antes de la transición a
Kafka y Kafka Streams: los agentes informan sus perspectivas a través de una API, el estado actualizado se calcula a través de una base de datos central
Conozcan Kafka Streams: ahora es fácil crear microservicios con estado compartido
Hace aproximadamente un año, decidimos revisar a fondo nuestros escenarios de trabajo con estado compartido para abordar ciertos problemas. Inmediatamente decidimos probar Kafka Streams, dado lo escalable, altamente disponible y tolerante a fallos que es, y su rico conjunto de funcionalidades de flujo (transformaciones, incluidas, con estado). Justo lo que necesitábamos, sin mencionar cuán madura y confiable se ha vuelto la sistema de mensajería en Kafka.
Cada uno de los microservicios con estado que creamos se construyó sobre una instancia de Kafka Streams con una topología bastante simple. Consistía en 1) una fuente, 2) un procesador con almacenamiento persistente de claves y valores, 3) un sumidero:
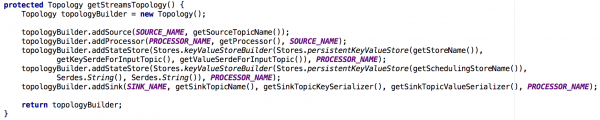
Ilustración 2: la topología por defecto de nuestras instancias de flujo para microservicios con estado. Tenga en cuenta: aquí también hay un almacenamiento que contiene metadatos sobre la planificación.
Con este nuevo enfoque, los agentes generan mensajes que se envían al tópico de origen, y los consumidores — digamos, el servicio de notificaciones por correo — reciben el estado compartido calculado a través del sumidero (tópico de salida).
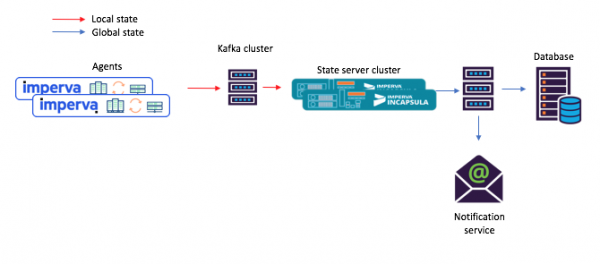
Ilustración 3: un nuevo ejemplo de flujo de tareas para un escenario con microservicios compartidos: 1) el agente genera un mensaje que llega al tópico de origen de Kafka; 2) el microservicio con estado compartido (que utiliza Kafka Streams) lo procesa y escribe el estado calculado en el tópico final de Kafka; después, 3) los consumidores reciben el nuevo estado.
¡Hey, y este almacenamiento integrado de claves y valores es realmente muy útil!
Como se mencionó anteriormente, nuestra topología con estado compartido incluye un almacenamiento de claves y valores. Encontramos varias formas de utilizarlo, y dos de ellas se describen a continuación.
Opción #1: uso del almacenamiento de claves y valores durante los cálculos.
Nuestro primer almacén de claves y valores contenía datos auxiliares que necesitábamos para los cálculos. Por ejemplo, en algunos casos, el estado compartido se determinó por el principio de "mayoría de votos". En el almacén podíamos mantener todos los últimos informes de los agentes sobre el estado de un determinado objeto. Luego, al recibir un nuevo informe de uno u otro agente, podíamos guardarlo, extraer del almacén los informes de todos los demás agentes sobre el mismo objeto y repetir el cálculo.
A continuación, en la ilustración 4 se muestra cómo abrimos el acceso al almacén de claves y valores al método procesador, de modo que luego se pudiera procesar un nuevo mensaje.
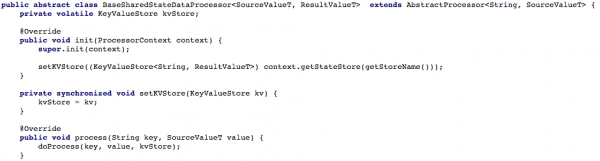
Ilustración 4: abrimos el acceso al almacén de claves y valores para el método procesador (después de esto, en cada escenario que trabaje con estado compartido, es necesario implementar el método doProcess)
Opción #2: crear una API CRUD sobre Kafka Streams
Al establecer nuestro flujo básico de tareas, comenzamos a intentar escribir una API RESTful CRUD para nuestros microservicios con estado compartido. Queríamos poder extraer el estado de algunos o todos los objetos, así como establecer o eliminar el estado de un objeto (lo cual es útil para mantener la parte del servidor).
Para admitir todas las API Get State, cada vez que necesitábamos recalcular el estado durante el procesamiento, lo almacenábamos temporalmente en un almacén de claves y valores incorporado. En tal caso, es bastante sencillo implementar dicha API utilizando una única instancia de Kafka Streams, como se muestra en el listado siguiente:
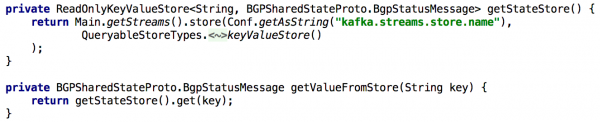
Ilustración 5: utilización del almacén de claves y valores incorporado para obtener el estado precalculado de un objeto
Actualizar el estado de un objeto a través de la API también es fácil de implementar. En principio, solo es necesario crear un productor de Kafka y, con él, hacer una escritura que contenga el nuevo estado. Esto garantiza que todos los mensajes generados a través de la API se procesen exactamente de la misma manera que los que provienen de otros productores (por ejemplo, agentes).
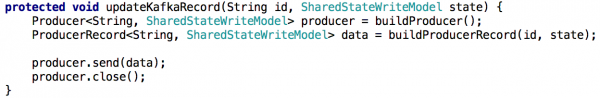
Ilustración 6: se puede establecer el estado de un objeto mediante un productor de Kafka
Un pequeño inconveniente: Kafka tiene muchas particiones
A continuación, queríamos distribuir la carga relacionada con el procesamiento y mejorar la disponibilidad, proporcionando un clúster de microservicios con un estado compartido para cada escenario. La configuración fue muy sencilla: después de configurar todas las instancias para que trabajaran con el mismo ID de aplicación (y los mismos servidores de arranque inicial), prácticamente todo lo demás se hacía de forma automática. También determinamos que cada tópico de origen constaría de varias particiones, para que a cada instancia se le pudiera asignar un subconjunto de estas particiones.
También cabe mencionar que aquí es habitual hacer una copia de seguridad del almacenamiento de estados, para que, en caso de recuperación de fallos, esta copia se pueda mover a otra instancia. Para cada almacenamiento de estados en Kafka Streams se crea un tópico replicable con un registro de cambios (donde se rastrean las actualizaciones locales). Así, Kafka siempre respalda el almacenamiento de estados. Por lo tanto, si una instancia de Kafka Streams falla, el almacenamiento de estados puede ser restaurado rápidamente en otra instancia, a la que se trasladarán las particiones correspondientes. Nuestros tests mostraron que esto se realiza en cuestión de segundos, incluso si el almacenamiento contiene millones de registros.
Al pasar de un microservicio con estado compartido a un clúster de microservicios, la implementación del Get State API se vuelve menos trivial. En la nueva situación, el almacenamiento de estados de cada microservicio contiene solo una parte del panorama general (los objetos cuyos claves se asignan a una partición específica). Era necesario determinar en qué instancia se encontraba el estado del objeto que necesitábamos, y lo hacíamos basándonos en los metadatos de los flujos, como se muestra a continuación:
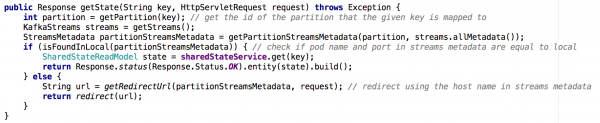
Ilustración 7: mediante metadatos de flujos, determinamos de qué instancia solicitar el estado del objeto requerido; este enfoque se aplicó con el GET ALL API.
Conclusiones Principales
Los almacenes de estados en Kafka Streams pueden servir de facto como una base de datos distribuida,
- constantemente replicada en Kafka.
- Sobre este sistema, es fácil construir un CRUD API.
- El procesamiento de múltiples particiones es un poco más complicado.
- También es posible agregar uno o varios almacenes de estado a la topología de flujo para almacenar datos auxiliares. Esta opción se puede utilizar para:
- Almacenamiento a largo plazo de datos necesarios para cálculos en el procesamiento de flujos
- Almacenamiento a largo plazo de datos que pueden ser útiles en la siguiente inicialización de la instancia de flujo
- muchas otras cosas…
Gracias a estas y otras ventajas, Kafka Streams es ideal para soportar el estado global en un sistema distribuido como el nuestro. Kafka Streams ha demostrado ser muy confiable en producción (desde su implementación prácticamente no hemos perdido mensajes), y estamos seguros de que sus capacidades no se limitan a esto.
Fuente: habr.com
