

O un poco de tetrislología aplicada.
Lo nuevo es lo bien olvidado antiguo.
Epígrafes.
Planteamiento del problema
Es necesario cargar periódicamente el archivo de registro actual de PostgreSQL desde la nube de AWS en un host local de Linux. No en tiempo real, pero, digamos, con un pequeño retraso.
El período para cargar la actualización del archivo de registro es de 5 minutos.
El archivo de registro en AWS se rota cada hora.
Herramientas utilizadas
Para cargar el archivo de registro en el host, se utiliza un script bash que llama a la API de AWS "».
Parámetros:
- ---db-instance-identifier: El nombre de la instancia en AWS;
- ---log-file-name: el nombre del archivo de registro actual generado
- ---max-item: La cantidad total de elementos devueltos en la salida del comando.Tamaño de la porción del archivo descargado.
- ---starting-token: Token de la porción inicial
En este caso concreto, la tarea de cargar los registros surgió durante el trabajo sobre
Y simplemente, una tarea interesante para entrenar y diversificar el tiempo de trabajo.
Supongo que la tarea, dada su cotidianidad, ya ha sido resuelta. Pero una rápida búsqueda en Google no dio soluciones, y no había muchas ganas de buscar a fondo. En cualquier caso, es un buen ejercicio.
Formalización de la tarea
El archivo de registro final consiste en múltiples líneas de longitud variable. Gráficamente, el archivo de registro se puede representar más o menos así:
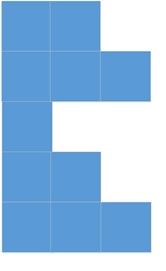
¿Algo ya te suena? ¿Qué tiene que ver el «tetris»? Aquí está la conexión.
Si representamos gráficamente las posibles opciones que surgen al cargar otro archivo (por simplicidad, en este caso, digamos que las líneas tienen una longitud), obtenemos figuras estándar de tetris:
1) El archivo se ha cargado completamente y es final. El tamaño de la porción es mayor que el tamaño del archivo final:
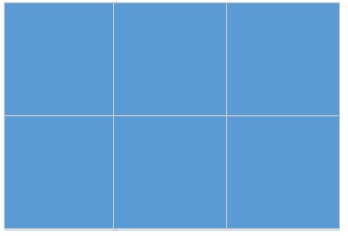
2) El archivo tiene continuidad. El tamaño de la porción es menor que el tamaño del archivo final:
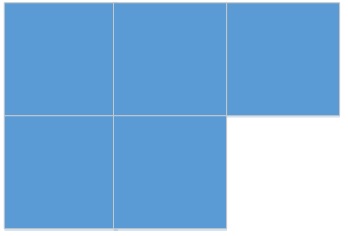
3) El archivo es continuación del archivo anterior y tiene continuidad. El tamaño de la porción es menor que el resto del archivo final:
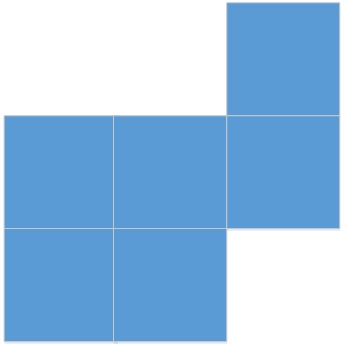
4) El archivo es continuación del archivo anterior y es final. El tamaño de la porción es mayor que el resto del archivo final:
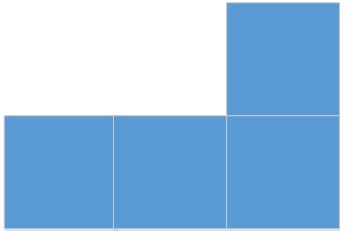
La tarea es formar un rectángulo o jugar al tetris en un nuevo nivel.
Problemas que surgen al resolver la tarea
1) Unir una línea de 2 porciones
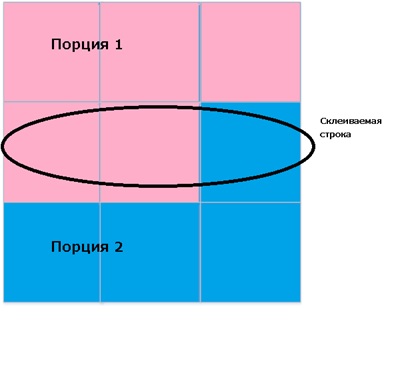
En general, no surgieron problemas especiales. Tarea estándar del curso introductorio de programación.
Tamaño óptimo de la porción
Esto es un poco más interesante.
Desafortunadamente, no es posible utilizar un desplazamiento después de la etiqueta de la primera porción:
Como ya sabes, la opción —starting-token se utiliza para especificar dónde comenzar la paginación. Esta opción toma valores de tipo String, lo que significa que si intentas agregar un valor de desplazamiento antes de la cadena del Token Siguiente, la opción no se considerará como un desplazamiento.
Y por lo tanto, hay que leer en fragmentos.
Si se lee en grandes porciones, la cantidad de lecturas será mínima, pero el volumen será máximo.
Si se lee en pequeñas porciones, entonces al contrario, la cantidad de lecturas será máxima, pero el volumen será mínimo.
Por lo tanto, para reducir el tráfico y por la estética de la solución, se tuvo que idear una especie de solución, que, desafortunadamente, se parece un poco a un parche.
Para ilustrar, consideremos el proceso de carga de un archivo de registro en dos versiones muy simplificadas. La cantidad de lecturas en ambos casos depende del tamaño de la porción.
1) Cargamos en pequeñas porciones:
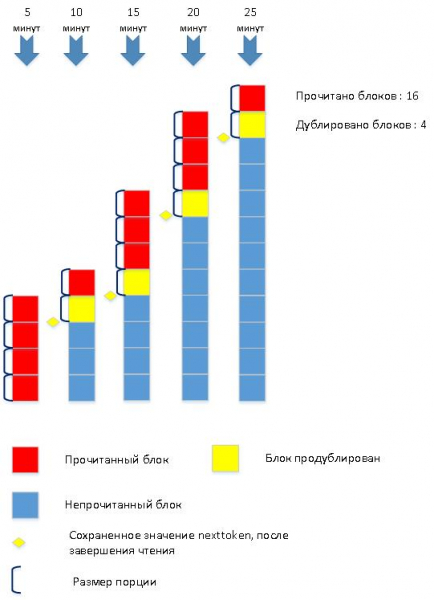
2) Cargamos en grandes porciones:
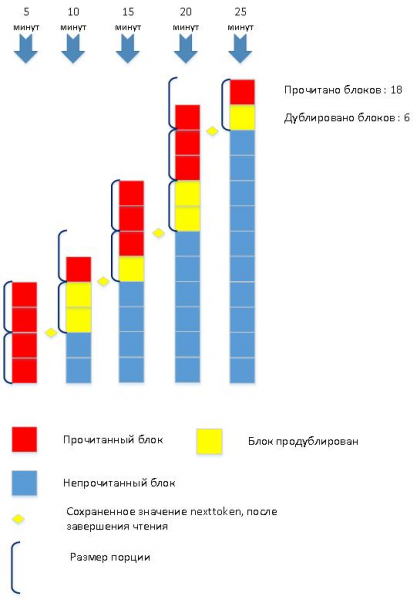
Como suele ser, la solución óptima es un término medio..
El tamaño de la porción es mínimo, pero en el proceso de lectura, se puede aumentar el tamaño para reducir el número de lecturas.
Cabe señalar, que el problema de encontrar el tamaño óptimo de la porción leída aún no se ha resuelto completamente y requiere un análisis más profundo. Tal vez, más adelante.
Descripción general de la implementación
Tablas de servicio utilizadas
CREATE TABLE endpoint
(
id SERIAL ,
host text
);

TABLE database
(
id SERIAL ,
…
last_aws_log_time text ,
last_aws_nexttoken text ,
aws_max_item_size integer
);
last_aws_log_time — marca de tiempo del último archivo de registro cargado en formato YYYY-MM-DD-HH24.
last_aws_nexttoken — etiqueta de texto de la última porción cargada.
aws_max_item_size- el tamaño inicial de la porción determinado empíricamente.
Texto completo del script
download_aws_piece.sh
#!/bin/bash
#########################################################
# download_aws_piece.sh
# downloan piece of log from AWS
# version HABR
 let min_item_size=1024
 let max_item_size=1048576
 let growth_factor=3
 let growth_counter=1
 let growth_counter_max=3

 echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:''STARTED'

 AWS_LOG_TIME=$1
 echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:AWS_LOG_TIME='$AWS_LOG_TIME

 database_id=$2
 echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:database_id='$database_id
 RESULT_FILE=$3

 endpoint=`psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE_DATABASE -A -t -c "select e.host from endpoint e join database d on e.id = d.endpoint_id where d.id = $database_id "`
 echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:endpoint='$endpoint

 db_instance=`echo $endpoint | awk -F"." '{print toupper($1)}'`

 echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:db_instance='$db_instance

 LOG_FILE=$RESULT_FILE'.tmp_log'
 TMP_FILE=$LOG_FILE'.tmp'
 TMP_MIDDLE=$LOG_FILE'.tmp_mid'
 TMP_MIDDLE2=$LOG_FILE'.tmp_mid2'

 current_aws_log_time=`psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -A -t -c "select last_aws_log_time from database where id = $database_id "`

 echo $(date +%Y%m%d%H%M)':      download_aws_piece.sh:current_aws_log_time='$current_aws_log_time

  if [[ $current_aws_log_time != $AWS_LOG_TIME  ]];
  then
    is_new_log='1'
	if ! psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -v ON_ERROR_STOP=1 -A -t -q -c "update database set last_aws_log_time = '$AWS_LOG_TIME' where id = $database_id "
	then
	  echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: FATAL_ERROR - update database set last_aws_log_time .'
	  exit 1
	fi
  else
    is_new_log='0'
  fi

  echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:is_new_log='$is_new_log

  let last_aws_max_item_size=`psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -A -t -c "select aws_max_item_size from database where id = $database_id "`
  echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: last_aws_max_item_size='$last_aws_max_item_size

  let count=1
  if [[ $is_new_log == '1' ]];
  then
	echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: START DOWNLOADING OF NEW AWS LOG'
	if ! aws rds download-db-log-file-portion
		--max-items $last_aws_max_item_size
		--region REGION
		--db-instance-identifier  $db_instance
		--log-file-name error/postgresql.log.$AWS_LOG_TIME > $LOG_FILE
	then
		echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: FATAL_ERROR - Could not get log from AWS .'
		exit 2
	fi
  else
    next_token=`psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -v ON_ERROR_STOP=1 -A -t -c "select last_aws_nexttoken from database where id = $database_id "`

	if [[ $next_token == '' ]];
	then
	  next_token='0'
	fi

	echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: CONTINUE DOWNLOADING OF AWS LOG'
	if ! aws rds download-db-log-file-portion
	    --max-items $last_aws_max_item_size
		--starting-token $next_token
		--region REGION
		--db-instance-identifier  $db_instance
		--log-file-name error/postgresql.log.$AWS_LOG_TIME > $LOG_FILE
	then
		echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: FATAL_ERROR - Could not get log from AWS .'
		exit 3
	fi

	line_count=`cat  $LOG_FILE | wc -l`
	let lines=$line_count-1

	tail -$lines $LOG_FILE > $TMP_MIDDLE
	mv -f $TMP_MIDDLE $LOG_FILE
  fi

  next_token_str=`cat $LOG_FILE | grep NEXTTOKEN`
  next_token=`echo $next_token_str | awk -F" " '{ print $2}' `

  grep -v NEXTTOKEN $LOG_FILE  > $TMP_FILE

  if [[ $next_token == '' ]];
  then
	  cp $TMP_FILE $RESULT_FILE

	  echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:  NEXTTOKEN NOT FOUND - FINISH '
	  rm $LOG_FILE
	  rm $TMP_FILE
	  rm $TMP_MIDDLE
          rm $TMP_MIDDLE2
	  exit 0
  else
	psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -v ON_ERROR_STOP=1 -A -t -q -c "update database set last_aws_nexttoken = '$next_token' where id = $database_id "
  fi

  first_str=`tail -1 $TMP_FILE`

  line_count=`cat  $TMP_FILE | wc -l`
  let lines=$line_count-1

  head -$lines $TMP_FILE  > $RESULT_FILE

###############################################
# MAIN CIRCLE
  let count=2
  while [[ $next_token != '' ]];
  do
    echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: count='$count

	echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: START DOWNLOADING OF AWS LOG'
	if ! aws rds download-db-log-file-portion
             --max-items $last_aws_max_item_size
             --starting-token $next_token
             --region REGION
             --db-instance-identifier  $db_instance
             --log-file-name error/postgresql.log.$AWS_LOG_TIME > $LOG_FILE
	then
		echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: FATAL_ERROR - Could not get log from AWS .'
		exit 4
	fi

	next_token_str=`cat $LOG_FILE | grep NEXTTOKEN`
	next_token=`echo $next_token_str | awk -F" " '{ print $2}' `

	TMP_FILE=$LOG_FILE'.tmp'
	grep -v NEXTTOKEN $LOG_FILE  > $TMP_FILE

	last_str=`head -1 $TMP_FILE`

    if [[ $next_token == '' ]];
	then
	  concat_str=$first_str$last_str

	  echo $concat_str >> $RESULT_FILE

	  line_count=`cat  $TMP_FILE | wc -l`
	  let lines=$line_count-1

	  tail -$lines $TMP_FILE >> $RESULT_FILE

	  echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:  NEXTTOKEN NOT FOUND - FINISH '
	  rm $LOG_FILE
	  rm $TMP_FILE
	  rm $TMP_MIDDLE
          rm $TMP_MIDDLE2
	  exit 0
	fi

    if [[ $next_token != '' ]];
	then
		let growth_counter=$growth_counter+1
		if [[ $growth_counter -gt $growth_counter_max ]];
		then
			let last_aws_max_item_size=$last_aws_max_item_size*$growth_factor
			let growth_counter=1
		fi

		if [[ $last_aws_max_item_size -gt $max_item_size ]];
		then
			let last_aws_max_item_size=$max_item_size
		fi

	  psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -A -t -q -c "update database set last_aws_nexttoken = '$next_token' where id = $database_id "

	  concat_str=$first_str$last_str

	  echo $concat_str >> $RESULT_FILE

	  line_count=`cat  $TMP_FILE | wc -l`
	  let lines=$line_count-1

	  #############################
	  #Get middle of file
	  head -$lines $TMP_FILE > $TMP_MIDDLE

	  line_count=`cat  $TMP_MIDDLE | wc -l`
	  let lines=$line_count-1
	  tail -$lines $TMP_MIDDLE > $TMP_MIDDLE2

	  cat $TMP_MIDDLE2 >> $RESULT_FILE

	  first_str=`tail -1 $TMP_FILE`
	fi

    let count=$count+1

  done
#
#################################################################

exit 0
Fragmentos del script con algunas explicaciones:
Parámetros de entrada del script:
- Marca de tiempo del nombre del archivo de registro en formato YYYY-MM-DD-HH24: AWS_LOG_TIME=$1
- ID de la base de datos: database_id=$2
- Nombre del archivo de registro recopilado: RESULT_FILE=$3
Obtener la marca de tiempo del último archivo de registro cargado:
current_aws_log_time=`psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -A -t -c "select last_aws_log_time from database where id = $database_id "`Si la marca de tiempo del último archivo de registro cargado no coincide con el parámetro de entrada, se cargará un nuevo archivo de registro:
si [[ $current_aws_log_time != $AWS_LOG_TIME  ]];
  entonces
    is_new_log='1'
	if ! psql -h ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -v ON_ERROR_STOP=1 -A -t -c "update database set last_aws_log_time = '$AWS_LOG_TIME' where id = $database_id "
	then
	  echo '***download_aws_piece.sh -ERROR_FATAL - update database set last_aws_log_time .'
	  exit 1
	fi
  else
    is_new_log='0'
  fi
Obtenemos el valor de la etiqueta nexttoken del archivo cargado:
  next_token_str=`cat $LOG_FILE | grep NEXTTOKEN`
  next_token=`echo $next_token_str | awk -F" " '{ print $2}' `
El signo de finalización de la carga es el valor vacío de nexttoken.
En el ciclo contamos porciones del archivo, a la vez encadenando líneas y aumentando el tamaño de la porción:
Ciclo principal
# MAIN CIRCLE
  let count=2
  while [[ $next_token != '' ]];
  do
    echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: count='$count

	echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: START DOWNLOADING OF AWS LOG'
	if ! aws rds download-db-log-file-portion
     --max-items $last_aws_max_item_size
	 --starting-token $next_token
     --region REGION
     --db-instance-identifier  $db_instance
     --log-file-name error/postgresql.log.$AWS_LOG_TIME > $LOG_FILE
	then
		echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: FATAL_ERROR - Could not get log from AWS .'
		exit 4
	fi

	next_token_str=`cat $LOG_FILE | grep NEXTTOKEN`
	next_token=`echo $next_token_str | awk -F" " '{ print $2}' `

	TMP_FILE=$LOG_FILE'.tmp'
	grep -v NEXTTOKEN $LOG_FILE  > $TMP_FILE

	last_str=`head -1 $TMP_FILE`

    if [[ $next_token == '' ]];
	then
	  concat_str=$first_str$last_str

	  echo $concat_str >> $RESULT_FILE

	  line_count=`cat  $TMP_FILE | wc -l`
	  let lines=$line_count-1

	  tail -$lines $TMP_FILE >> $RESULT_FILE

	  echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:  NEXTTOKEN NOT FOUND - FINISH '
	  rm $LOG_FILE
	  rm $TMP_FILE
	  rm $TMP_MIDDLE
         rm $TMP_MIDDLE2
	  exit 0
	fi

    if [[ $next_token != '' ]];
	then
		let growth_counter=$growth_counter+1
		if [[ $growth_counter -gt $growth_counter_max ]];
		then
			let last_aws_max_item_size=$last_aws_max_item_size*$growth_factor
			let growth_counter=1
		fi

		if [[ $last_aws_max_item_size -gt $max_item_size ]];
		then
			let last_aws_max_item_size=$max_item_size
		fi

	  psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -A -t -q -c "update database set last_aws_nexttoken = '$next_token' where id = $database_id "

	  concat_str=$first_str$last_str

	  echo $concat_str >> $RESULT_FILE

	  line_count=`cat  $TMP_FILE | wc -l`
	  let lines=$line_count-1

	  #############################
	  #Get middle of file
	  head -$lines $TMP_FILE > $TMP_MIDDLE

	  line_count=`cat  $TMP_MIDDLE | wc -l`
	  let lines=$line_count-1
	  tail -$lines $TMP_MIDDLE > $TMP_MIDDLE2

	  cat $TMP_MIDDLE2 >> $RESULT_FILE

	  first_str=`tail -1 $TMP_FILE`
	fi

    let count=$count+1

  done
¿Y ahora qué?
Por lo tanto, la primera tarea intermedia — 'cargar el archivo de registro desde la nube' está resuelta. ¿Qué hacer con el registro cargado?
Primero es necesario analizar el archivo de registro y extraer las propias consultas de él.
La tarea no es muy complicada. Un sencillo script bash puede manejarla sin problemas.
upload_log_query.sh
#!/bin/bash
#########################################################
# upload_log_query.sh
# Upload table table from dowloaded aws file
# version HABR
###########################################################
echo 'TIMESTAMP:'$(date +%c)' Upload log_query table '
source_file=$1
echo 'source_file='$source_file
database_id=$2
echo 'database_id='$database_id

beginer=' '
first_line='1'
let "line_count=0"
sql_line=' '
sql_flag=' '
space=' '
cat $source_file | while read line
do
  line="$space$line"

  if [[ $first_line == "1" ]]; then
    beginer=`echo $line | awk -F" " '{ print $1}' `
    first_line='0'
  fi

  current_beginer=`echo $line | awk -F" " '{ print $1}' `

  if [[ $current_beginer == $beginer ]]; then
    if [[ $sql_flag == '1' ]]; then
     sql_flag='0'
     log_date=`echo $sql_line | awk -F" " '{ print $1}' `
     log_time=`echo $sql_line | awk -F" " '{ print $2}' `
     duration=`echo $sql_line | awk -F" " '{ print $5}' `

     #replace ' to ''
     sql_modline=`echo "$sql_line" | sed 's/'''/''''''/g'`
     sql_line=' '

	 ################
	 #PROCESSING OF THE SQL-SELECT IS HERE
     if ! psql -h ENDPOINT.rds.amazonaws.com -U USER -d DATABASE -v ON_ERROR_STOP=1 -A -t -c "select log_query('$ip_port',$database_id , '$log_date' , '$log_time' , '$duration' , '$sql_modline' )"
     then
        echo 'FATAL_ERROR - log_query '
        exit 1
     fi
	 ################

    fi #if [[ $sql_flag == '1' ]]; then

    let "line_count=line_count+1"

    check=`echo $line | awk -F" " '{ print $8}' `
    check_sql=${check^^}

    #echo 'check_sql='$check_sql

    if [[ $check_sql == 'SELECT' ]]; then
     sql_flag='1'
     sql_line="$sql_line$line"
	 ip_port=`echo $sql_line | awk -F":" '{ print $4}' `
    fi
  else

    if [[ $sql_flag == '1' ]]; then
      sql_line="$sql_line$line"
    fi

  fi #if [[ $current_beginer == $beginer ]]; then

done
Ahora, con la consulta extraída del archivo de registro, se puede trabajar.
Y se abren varias posibilidades útiles.
Las consultas analizadas deben almacenarse en algún lugar. Para ello se utiliza una tabla de servicio log_query
CREATE TABLE log_query
(
   id SERIAL ,
   queryid bigint ,
   query_md5hash text not null ,
   database_id integer not null ,
   timepoint timestamp without time zone not null,
   duration double precision not null ,
   query text not null ,
   explained_plan text[],
   plan_md5hash text  ,
   explained_plan_wo_costs text[],
   plan_hash_value text  ,
   baseline_id integer ,
   ip text ,
   port text
);
ALTER TABLE log_query ADD PRIMARY KEY (id);
ALTER TABLE log_query ADD CONSTRAINT queryid_timepoint_unique_key UNIQUE (queryid, timepoint );
ALTER TABLE log_query ADD CONSTRAINT query_md5hash_timepoint_unique_key UNIQUE (query_md5hash, timepoint );

CREATE INDEX log_query_timepoint_idx ON log_query (timepoint);
CREATE INDEX log_query_queryid_idx ON log_query (queryid);
ALTER TABLE log_query ADD CONSTRAINT database_id_fk FOREIGN KEY (database_id) REFERENCES database (id) ON DELETE CASCADE ;
El procesamiento de la consulta analizada se realiza en plpgsql la función 'log_query».
log_query.sql
--log_query.sql
--versión HABR
CREATE OR REPLACE FUNCTION log_query( ip_port text ,log_database_id integer , log_date text , log_time text , duration text , sql_line text   ) RETURNS boolean AS $$
DECLARE
  result boolean ;
  log_timepoint timestamp without time zone ;
  log_duration double precision ;
  pos integer ;
  log_query text ;
  activity_string text ;
  log_md5hash text ;
  log_explain_plan text[] ;

  log_planhash text ;
  log_plan_wo_costs text[] ;

  database_rec record ;

  pg_stat_query text ;
  test_log_query text ;
  log_query_rec record;
  found_flag boolean;

  pg_stat_history_rec record ;
  port_start integer ;
  port_end integer ;
  client_ip text ;
  client_port text ;
  log_queryid bigint ;
  log_query_text text ;
  pg_stat_query_text text ;
BEGIN
  result = TRUE ;

  RAISE NOTICE '***log_query';

  port_start = position('(' in ip_port);
  port_end = position(')' in ip_port);
  client_ip = substring( ip_port from 1 for port_start-1 );
  client_port = substring( ip_port from port_start+1 for port_end-port_start-1 );

  SELECT e.host , d.name , d.owner_pwd
  INTO database_rec
  FROM database d JOIN endpoint e ON e.id = d.endpoint_id
  WHERE d.id = log_database_id ;

  log_timepoint = to_timestamp(log_date||' '||log_time,'YYYY-MM-DD HH24-MI-SS');
  log_duration = duration:: double precision;


  pos = position ('SELECT' in UPPER(sql_line) );
  log_query = substring( sql_line from pos for LENGTH(sql_line));
  log_query = regexp_replace(log_query,' +',' ','g');
  log_query = regexp_replace(log_query,';+','','g');
  log_query = trim(trailing ' ' from log_query);


  log_md5hash = md5( log_query::text );

  --Explicar plan de ejecución--
  EXECUTE 'SELECT dblink_connect(''LINK1'',''host='||database_rec.host||' dbname='||database_rec.name||' user=DATABASE password='||database_rec.owner_pwd||' '')';

  log_explain_plan = ARRAY ( SELECT * FROM dblink('LINK1', 'EXPLAIN '||log_query ) AS t (plan text) );
  log_plan_wo_costs = ARRAY ( SELECT * FROM dblink('LINK1', 'EXPLAIN ( COSTS FALSE ) '||log_query ) AS t (plan text) );

  PERFORM dblink_disconnect('LINK1');
  --------------------------
  BEGIN
	INSERT INTO log_query
	(
		query_md5hash ,
		database_id ,
		timepoint ,
		duration ,
		query ,
		explained_plan ,
		plan_md5hash ,
		explained_plan_wo_costs ,
		plan_hash_value ,
		ip ,
		port
	)
	VALUES
	(
		log_md5hash ,
		log_database_id ,
		log_timepoint ,
		log_duration ,
		log_query ,
		log_explain_plan ,
		md5(log_explain_plan::text) ,
		log_plan_wo_costs ,
		md5(log_plan_wo_costs::text),
		client_ip ,
		client_port
	);
	activity_string = 	'Nueva consulta registrada '||
						' database_id = '|| log_database_id ||
						' query_md5hash='||log_md5hash||
						' , timepoint = '||to_char(log_timepoint,'YYYYMMDD HH24:MI:SS');

	RAISE NOTICE '%',activity_string;

	PERFORM pg_log( log_database_id , 'log_query' , activity_string);

	EXCEPTION
	  WHEN unique_violation THEN
		RAISE NOTICE '*** unique_violation *** la consulta ya ha sido registrada';
	END;

	SELECT 	queryid
	INTO   	log_queryid
	FROM 	log_query
	WHERE 	query_md5hash = log_md5hash AND
			timepoint = log_timepoint;

	IF log_queryid IS NOT NULL
	THEN
	  RAISE NOTICE 'log_query con query_md5hash = % y timepoint = % ya tiene un QUERYID = %',log_md5hash,log_timepoint , log_queryid ;
	  RETURN result;
	END IF;

	------------------------------------------------
	RAISE NOTICE 'Actualizar queryid';

	SELECT *
	INTO log_query_rec
	FROM log_query
	WHERE query_md5hash = log_md5hash AND timepoint = log_timepoint ;

	log_query_rec.query=regexp_replace(log_query_rec.query,';+','','g');

	FOR pg_stat_history_rec IN
	 SELECT
         queryid ,
	  query
	 FROM
         pg_stat_db_queries
     WHERE
      database_id = log_database_id AND
       queryid is not null
	LOOP
	  pg_stat_query = pg_stat_history_rec.query ;
	  pg_stat_query=regexp_replace(pg_stat_query,'n+',' ','g');
	  pg_stat_query=regexp_replace(pg_stat_query,'t+',' ','g');
	  pg_stat_query=regexp_replace(pg_stat_query,' +',' ','g');
	  pg_stat_query=regexp_replace(pg_stat_query,'$.','%','g');

	  log_query_text = trim(trailing ' ' from log_query_rec.query);
	  pg_stat_query_text = pg_stat_query;


	  --SELECT log_query_rec.query like pg_stat_query INTO found_flag ;
	  IF (log_query_text LIKE pg_stat_query_text) THEN
		found_flag = TRUE ;
	  ELSE
		found_flag = FALSE ;
	  END IF;


	  IF found_flag THEN

		UPDATE log_query SET queryid = pg_stat_history_rec.queryid WHERE query_md5hash = log_md5hash AND timepoint = log_timepoint ;
		activity_string = 	' updated queryid = '||pg_stat_history_rec.queryid||
		                    ' para log_query con id = '||log_query_rec.id
		   				    ;
	    RAISE NOTICE '%',activity_string;
		EXIT ;
	  END IF ;

	END LOOP ;

  RETURN result ;
END
$$ LANGUAGE plpgsql;
Se utiliza una tabla de servicio en el procesamiento pg_stat_db_queries, que contiene una instantánea de las consultas actuales de la tabla pg_stat_history (El uso de la tabla se describe aquí — )
TABLE pg_stat_db_queries
(
   database_id integer,
   queryid bigint ,
   query text ,
   max_time double precision
);
TABLE pg_stat_history
(
…
database_id integer ,
…
queryid bigint ,
…
max_time double precision	 ,
…
);
La función permite llevar a cabo una serie de capacidades útiles para el procesamiento de consultas del archivo de logs. En particular:
Oportunidad #1 — Historial de ejecución de consultas
Es muy útil para comenzar a resolver un incidente de rendimiento. Primero, revisar el historial — ¿cuándo comenzó la desaceleración?
Luego, de manera clásica, buscar causas externas. Tal vez simplemente la carga de la base de datos aumentó drásticamente y una consulta específica no tiene nada que ver.
Añadir un nuevo registro a la tabla log_query
  port_start = position('(' in ip_port);
  port_end = position(')' in ip_port);
  client_ip = substring( ip_port from 1 for port_start-1 );
  client_port = substring( ip_port from port_start+1 for port_end-port_start-1 );

  SELECT e.host , d.name , d.owner_pwd
  INTO database_rec
  FROM database d JOIN endpoint e ON e.id = d.endpoint_id
  WHERE d.id = log_database_id ;

  log_timepoint = to_timestamp(log_date||' '||log_time,'YYYY-MM-DD HH24-MI-SS');
  log_duration = to_number(duration,'99999999999999999999D9999999999');


  pos = position ('SELECT' in UPPER(sql_line) );
  log_query = substring( sql_line from pos for LENGTH(sql_line));
  log_query = regexp_replace(log_query,' +',' ','g');
  log_query = regexp_replace(log_query,';+','','g');
  log_query = trim(trailing ' ' from log_query);

  RAISE NOTICE 'log_query=%',log_query ;

  log_md5hash = md5( log_query::text );

  --Explain execution plan--
  EXECUTE 'SELECT dblink_connect(''LINK1'',''host='||database_rec.host||' dbname='||database_rec.name||' user=DATABASE password='||database_rec.owner_pwd||' '')';

  log_explain_plan = ARRAY ( SELECT * FROM dblink('LINK1', 'EXPLAIN '||log_query ) AS t (plan text) );
  log_plan_wo_costs = ARRAY ( SELECT * FROM dblink('LINK1', 'EXPLAIN ( COSTS FALSE ) '||log_query ) AS t (plan text) );

  PERFORM dblink_disconnect('LINK1');
  --------------------------
  BEGIN
	INSERT INTO log_query
	(
		query_md5hash ,
		database_id ,
		timepoint ,
		duration ,
		query ,
		explained_plan ,
		plan_md5hash ,
		explained_plan_wo_costs ,
		plan_hash_value ,
		ip ,
		port
	)
	VALUES
	(
		log_md5hash ,
		log_database_id ,
		log_timepoint ,
		log_duration ,
		log_query ,
		log_explain_plan ,
		md5(log_explain_plan::text) ,
		log_plan_wo_costs ,
		md5(log_plan_wo_costs::text),
		client_ip ,
		client_port
	);
Oportunidad #2 — Almacenar planes de ejecución de consultas
En este punto puede surgir una objeción-aclaración-comentario: «Pero ya existe autoexplain». Hay que considerar que de poco sirve, si el plan de ejecución se almacena en el mismo archivo de logs y para conservarlo para un análisis posterior, tendrá que parsear el archivo de logs.
Yo necesitaba:
en primer lugar: almacenar el plan de ejecución en la tabla de servicio de la base de datos de monitoreo;
En segundo lugar: tener la capacidad de comparar los planes de ejecución entre sí, para ver de inmediato que el plan de ejecución de la consulta ha cambiado.
Se dispone de una consulta con parámetros de ejecución específicos. Obtener y guardar su plan de ejecución usando EXPLAIN es una tarea elemental.
Además, usando la expresión EXPLAIN (COSTS FALSE), se puede obtener un esqueleto del plan que se utilizará para obtener el valor hash del plan, lo que ayudará en la posterior análisis de la historia de cambios del plan de ejecución.
Obtener la plantilla del plan de ejecución
  --Explicar el plan de ejecución--
  EXECUTE 'SELECT dblink_connect(''LINK1'',''host='||database_rec.host||' dbname='||database_rec.name||' user=DATABASE password='||database_rec.owner_pwd||' '')';

  log_explain_plan = ARRAY ( SELECT * FROM dblink('LINK1', 'EXPLAIN '||log_query ) AS t (plan text) );
  log_plan_wo_costs = ARRAY ( SELECT * FROM dblink('LINK1', 'EXPLAIN ( COSTS FALSE ) '||log_query ) AS t (plan text) );

  PERFORM dblink_disconnect('LINK1');
Opción Nº 3 — Uso del registro de consultas para el monitoreo
Dado que las métricas de rendimiento no están configuradas sobre el texto de la consulta, sino sobre su ID, es necesario vincular las consultas del archivo de registro con aquellas para las que se han configurado métricas de rendimiento.
Al menos para tener el tiempo exacto de ocurrencia del incidente de rendimiento.
Así, ante la ocurrencia de un incidente de rendimiento para el ID de la consulta, habrá un enlace a la consulta específica con valores de parámetros concretos y el tiempo exacto de ejecución y duración de la consulta. Obtener dicha información utilizando solo la vista pg_stat_statements — no se puede.
Encontrar el queryid de la consulta y actualizar el registro en la tabla log_query
SELECT *
	INTO log_query_rec
	FROM log_query
	WHERE query_md5hash = log_md5hash AND timepoint = log_timepoint ;

	log_query_rec.query=regexp_replace(log_query_rec.query,';+','','g');

	FOR pg_stat_history_rec IN
	 SELECT
      queryid ,
	  query
	 FROM
       pg_stat_db_queries
     WHERE
	   database_id = log_database_id AND
       queryid is not null
	LOOP
	  pg_stat_query = pg_stat_history_rec.query ;
	  pg_stat_query=regexp_replace(pg_stat_query,'n+',' ','g');
	  pg_stat_query=regexp_replace(pg_stat_query,'t+',' ','g');
	  pg_stat_query=regexp_replace(pg_stat_query,' +',' ','g');
	  pg_stat_query=regexp_replace(pg_stat_query,'$.','%','g');

	  log_query_text = trim(trailing ' ' from log_query_rec.query);
	  pg_stat_query_text = pg_stat_query;

	  --SELECT log_query_rec.query like pg_stat_query INTO found_flag ;
	  IF (log_query_text LIKE pg_stat_query_text) THEN
		found_flag = TRUE ;
	  ELSE
		found_flag = FALSE ;
	  END IF;


	  IF found_flag THEN

		UPDATE log_query SET queryid = pg_stat_history_rec.queryid WHERE query_md5hash = log_md5hash AND timepoint = log_timepoint ;
		activity_string = 	' updated queryid = '||pg_stat_history_rec.queryid||
		                    ' for log_query with id = '||log_query_rec.id
		   				    ;

	    RAISE NOTICE '%',activity_string;
		EXIT ;
	  END IF ;

	END LOOP ;
Póscrito
La metodología descrita finalmente encontró su aplicación en , permitiendo tener más información para el análisis al resolver incidentes de rendimiento de consultas que surgen.
Aunque, por supuesto, desde mi punto de vista personal y autoral, aún será necesario trabajar más en el algoritmo de selección y ajuste del tamaño de la porción cargada. La tarea aún no se ha resuelto en el caso general. Probablemente, será interesante.
Pero esa es otra historia completamente diferente …
Fuente: habr.com
