

En el proceso de transición de una aplicación monolítica a una arquitectura de microservicios, nos enfrentamos a nuevos problemas.
En una aplicación monolítica, generalmente es suficiente con determinar en qué parte del sistema ocurrió el error. Lo más probable es que el problema esté en el código del propio monolito o en la base de datos. Pero cuando comenzamos a buscar un problema en una arquitectura de microservicios, ya no es tan obvio. Necesitamos encontrar todo el camino que ha seguido la solicitud de principio a fin, despejándolo entre cientos de microservicios. Además, muchos de ellos tienen sus propios almacenes, donde pueden surgir tanto errores lógicos como problemas de rendimiento y disponibilidad.
Busqué durante mucho tiempo una herramienta que me ayudara a enfrentar tales problemas (escribí sobre esto en Хабр: , ), pero al final hice mi propia solución de código abierto. En el artículo, hablo sobre las ventajas del enfoque de service mesh y comparto una nueva herramienta para su implementación.
El tracing distribuido es una solución común al problema de la búsqueda de errores en sistemas distribuidos. Pero, ¿qué sucede si en el sistema aún no se ha implementado este enfoque para recolectar información sobre las interacciones de red, o, peor aún, en parte del sistema ya funciona correctamente y en otra no, porque no se ha agregado a los servicios antiguos? Para determinar la causa raíz exacta del problema, es necesario tener una imagen completa de lo que está sucediendo en el sistema. Es especialmente importante entender qué microservicios participan en los caminos críticos para el negocio.
Aquí es donde nos puede ayudar el enfoque de service mesh, que se encargará de toda la maquinaria para recolectar información de red a un nivel más bajo que el de los propios servicios. Este enfoque nos permite interceptar todo el tráfico y analizarlo en tiempo real. Además, las aplicaciones no necesitan saber nada al respecto.
Enfoque de service mesh
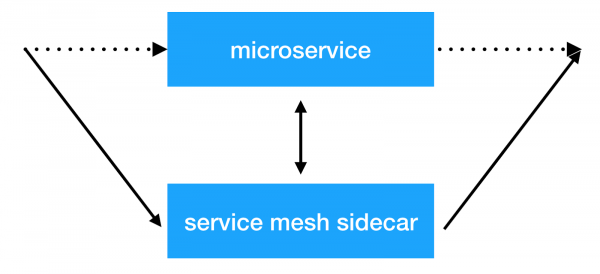
La idea principal del enfoque de service mesh es añadir una capa de infraestructura adicional sobre la red, que nos permitirá realizar cualquier acción relacionada con la interacción entre servicios. La mayoría de las implementaciones funcionan de la siguiente manera: a cada microservicio se le añade un contenedor sidecar adicional con un proxy transparente, a través del cual se redirige todo el tráfico entrante y saliente del servicio. Y es justo en este punto donde podemos hacer balanceo del cliente, aplicar políticas de seguridad, introducir restricciones en la cantidad de solicitudes y recopilar información importante sobre la interacción de los servicios en producción.
Soluciones
Ya existen varias implementaciones de este enfoque: y . Proporcionan muchas funcionalidades listas para usar. Pero al mismo tiempo, esto conlleva un gran overhead de recursos. Y cuanto mayor es el clúster en el que opera tal sistema, más recursos se requieren para mantener la nueva infraestructura. En Avito, operamos clústeres de Kubernetes en los que hay miles de instancias de servicios (y su número sigue creciendo rápidamente). En la implementación actual, Istio consume ~300 Mb de memoria RAM por cada instancia de servicio. Debido a la gran cantidad de funcionalidades, el balanceo transparente también afecta al tiempo total de respuesta de los servicios (incluso hasta 10 ms).
Al final, analizamos cuáles eran exactamente las funcionalidades que necesitábamos en este momento, y decidimos que lo principal, por lo que comenzamos a implementar este tipo de soluciones, era la capacidad de recopilar información de tracing de todo el sistema de manera transparente. También queríamos tener control sobre la interacción de los servicios y realizar diversas manipulaciones con los encabezados que se transmiten entre ellos.
Finalmente, llegamos a nuestra solución: .
Netramesh
— es una solución de service mesh ligera con la posibilidad de escalado infinito independientemente de la cantidad de servicios en el sistema.
Los principales objetivos de la nueva solución eran un bajo overhead de recursos y un alto rendimiento. De las funcionalidades principales, queríamos desde el principio poder enviar de manera transparente los spans de tracing a nuestro sistema Jaeger.
Hoy en día, la mayoría de las soluciones en la nube se implementan en Golang. Y, por supuesto, hay razones para ello. Es conveniente y bastante simple escribir aplicaciones de red en Golang que funcionen de manera asíncrona con entrada/salida y se escalen según sea necesario en núcleos. Y, lo que también es muy importante, el rendimiento es suficiente para abordar esta tarea. Por eso también elegimos Golang.
Rendimiento
Nos hemos enfocado en lograr un rendimiento óptimo. Para una solución que se despliega junto a cada instancia del servicio, es necesario un bajo consumo de memoria y tiempo de CPU. Y, por supuesto, la latencia de respuesta debe ser igualmente baja.
Veamos qué resultados hemos obtenido.
RAM
Netramesh consume ~10Mb sin tráfico y hasta 50Mb con una carga máxima de 10000 RPS en una instancia.
El proxy Istio envoy siempre consume ~300Mb en nuestros clústeres con miles de instancias. Esto impide escalarlo a todo el clúster.
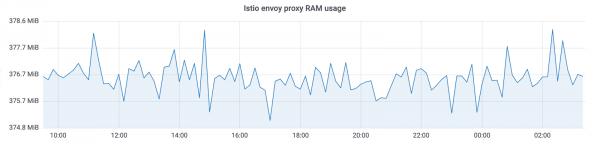
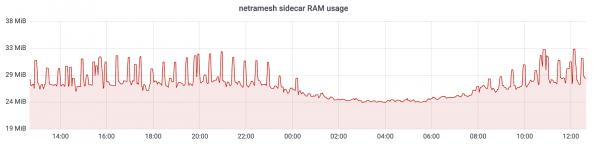
Con Netramesh hemos logrado reducir el consumo de memoria en ~10 veces.
CPU
El uso de CPU es relativamente constante bajo carga. Depende del número de solicitudes por unidad de tiempo al sidecar. Los valores a 3000 solicitudes por segundo en el pico son:
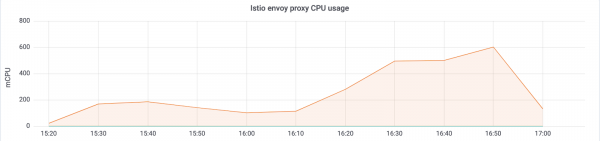
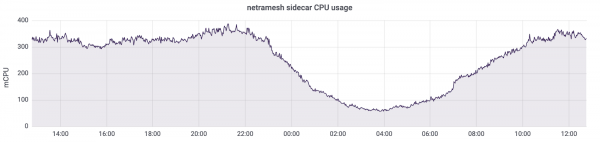
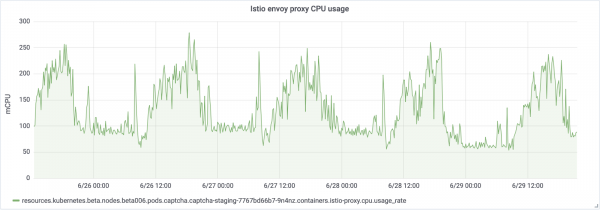
Hay otro aspecto importante: Netramesh es una solución sin plano de control y no consume tiempo de CPU sin carga. Con Istio, los sidecars siempre actualizan los endpoints de los servicios. Como resultado, podemos ver esta situación sin carga:
Utilizamos HTTP/1 para la interacción entre servicios. El aumento en el tiempo de respuesta de Istio al proxy a través de envoy fue de hasta 5-10ms, lo cual es bastante para servicios que están listos para responder en un milisegundo. Con Netramesh, este tiempo se ha reducido a 0.5-2ms.
Escalabilidad
La pequeña cantidad de recursos que consume cada proxy permite que se ubique cerca de cada servicio. Netramesh fue intencionalmente diseñado sin un componente de plano de control para mantener la ligereza de cada sidecar. A menudo, en soluciones de service mesh, el plano de control distribuye información de descubrimiento de servicios a cada sidecar. Esto viene acompañado de información sobre timeouts y configuraciones de balanceo. Todo esto permite hacer muchas cosas útiles, pero, desafortunadamente, inflado el tamaño de los sidecars.
Descubrimiento de servicios

Netramesh no añade mecanismos adicionales para el descubrimiento de servicios. Todo el tráfico se proxinea de manera transparente a través del sidecar de netra.
Netramesh admite el protocolo de aplicación HTTP/1. Para su definición, se utiliza una lista de puertos configurable. Normalmente hay varios puertos en el sistema a través de los cuales se realiza la interacción HTTP. Por ejemplo, para la interacción entre servicios y solicitudes externas, utilizamos los puertos 80, 8890, 8080. En este caso, se pueden definir mediante una variable de entorno. NETRA_HTTP_PORTS.
Si utilizas Kubernetes como orquestador y su mecanismo Service para la interacción entre servicios dentro del clúster, el mecanismo sigue siendo el mismo. Primero, el microservicio obtiene la dirección IP del servicio a través de kube-dns y establece una nueva conexión con ella. Esta conexión se establece primero con el netra-sidecar local, y todos los paquetes TCP llegan inicialmente a netra. Luego, netra-sidecar establece la conexión con el destino original. El NAT en la IP del pod en el nodo sigue siendo el mismo que sin netra.
Trazado distribuido y propagación de contexto
Netramesh proporciona la funcionalidad necesaria para enviar spans de trazado sobre la interacción HTTP. Netra-sidecar analiza el protocolo HTTP, mide las latencias de las solicitudes y extrae la información necesaria de los encabezados HTTP. Al final, obtenemos todos los trazos en un único sistema Jaeger. Para una configuración más detallada, también se pueden utilizar las variables de entorno que proporciona la biblioteca oficial. .
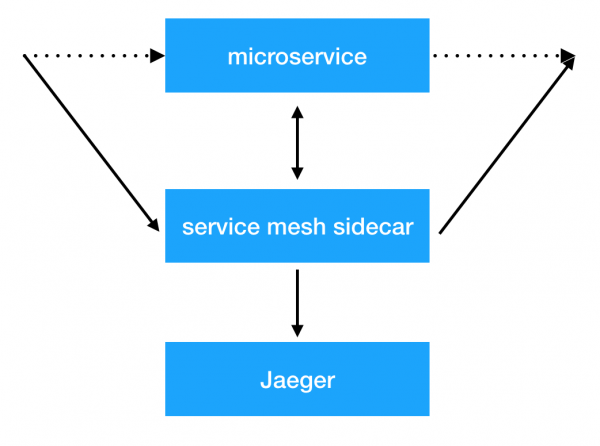
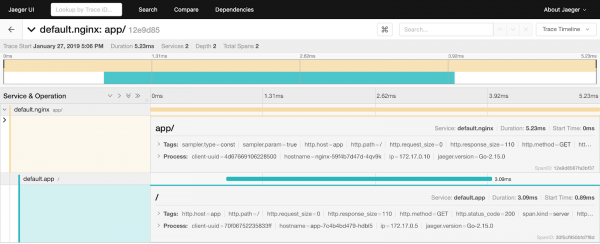
Pero hay un problema. Mientras los servicios no generen y propaguen un encabezado uber especial, no veremos los spans de trazado conectados en el sistema. Y eso es lo que necesitamos para buscar rápidamente la raíz de los problemas. Aquí Netramesh vuelve a tener la solución. Los proxies leen los encabezados HTTP y, si no contienen el uber trace id, lo generan. Netramesh también almacena información sobre las solicitudes entrantes y salientes en el sidecar y las empareja enriqueciendo las solicitudes salientes con los encabezados necesarios. Todo lo que los servicios deben hacer es propagar solo un encabezado. X-Request-Id, que se puede configurar mediante una variable de entorno. NETRA_HTTP_REQUEST_ID_HEADER_NAME. Para gestionar el tamaño del contexto en Netramesh, se pueden definir las siguientes variables de entorno: NETRA_TRACING_CONTEXT_EXPIRATION_MILLISECONDS (el tiempo durante el cual se almacenará el contexto) y NETRA_TRACING_CONTEXT_CLEANUP_INTERVAL (la frecuencia de limpieza del contexto).
También es posible combinar varias rutas en su sistema mediante la marcación con un marcador de sesión especial. Netra permite establecer HTTP_HEADER_TAG_MAP para convertir las cabeceras HTTP en etiquetas de tracing span correspondientes. Esto puede ser especialmente útil para pruebas. Después de pasar la prueba funcional, se puede ver qué parte del sistema fue afectada, filtrando por la clave de sesión correspondiente.
Determinación de la fuente de la solicitud
Para determinar de dónde proviene la solicitud, se puede utilizar la funcionalidad de adición automática de cabecera con la fuente. Con la variable de entorno NETRA_HTTP_X_SOURCE_HEADER_NAME se puede establecer el nombre de la cabecera que se fijará automáticamente. Con NETRA_HTTP_X_SOURCE_VALUE se puede establecer el valor en el que se fijará la cabecera X-Source para todas las solicitudes salientes.
Esto permite la difusión unificada de esta valiosa cabecera en toda la red. Luego, se puede utilizar en servicios y agregar a los registros y métricas.
Enrutamiento de tráfico y aspectos internos de Netramesh
Netramesh consta de dos componentes principales. El primero, netra-init, establece reglas de red para la interceptación de tráfico. Utiliza para interceptar todo o parte del tráfico hacia un sidecar, que es el segundo componente principal de Netramesh. Se pueden configurar qué puertos interceptar para las sesiones TCP entrantes y salientes: INBOUND_INTERCEPT_PORTS, OUTBOUND_INTERCEPT_PORTS.
Además, la herramienta tiene una funcionalidad interesante: el enrutamiento probabilístico. Si se utiliza Netramesh exclusivamente para la recopilación de tracing span, se pueden ahorrar recursos en un entorno de producción y habilitar el enrutamiento probabilístico mediante las variables NETRA_INBOUND_PROBABILITY y NETRA_OUTBOUND_PROBABILITY (de 0 a 1). El valor predeterminado es 1 (se intercepta todo el tráfico).
Después de interceptar con éxito, el sidecar de netra acepta una nueva conexión y utiliza SO_ORIGINAL_DST la opción de socket para obtener el destino original. Luego, Netra abre una nueva conexión con la dirección IP original y establece comunicación TCP bidireccional entre las partes, escuchando todo el tráfico que pasa. Si el puerto se define como HTTP, Netra intenta analizarlo y rastrearlo. Si el análisis HTTP no tiene éxito, Netra hace un fallback a TCP y proxy de manera transparente los bytes.
Construcción del grafo de dependencias
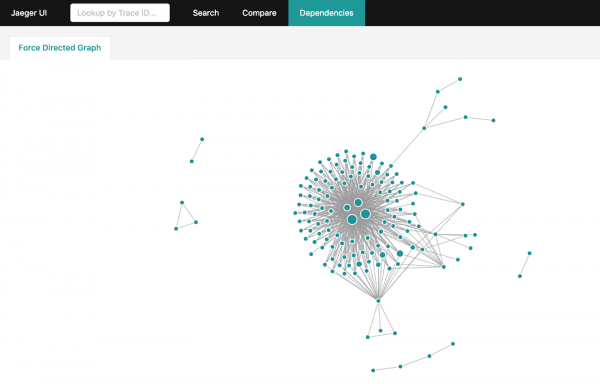
Después de obtener una gran cantidad de información de tracing en Jaeger, es deseable obtener un grafo completo de interacciones en el sistema. Pero si su sistema está muy cargado y se acumulan miles de millones de spans de tracing en un día, agregarlos se convierte en una tarea bastante complicada. Hay un método oficial para hacerlo: . Sin embargo, tomará horas construir el grafo completo y obligará a descargar de Jaeger todo el conjunto de datos de las últimas 24 horas.
Si utiliza Elasticsearch para almacenar los spans de tracing, puede aprovechar una , que construirá un grafo similar en minutos, utilizando las características y capacidades de Elasticsearch.
Cómo utilizar Netramesh
Netra se puede agregar fácilmente a cualquier servicio que opere bajo cualquier orquestador. Puede ver un ejemplo .
En este momento, Netra no tiene la capacidad de implementar automáticamente sidecar en los servicios, pero hay planes para su implementación.
Futuro de Netramesh
El objetivo principal es lograr un mínimo costo de recursos y un alto rendimiento, proporcionando funcionalidades clave para observabilidad y control de la interacción entre servicios.
En el futuro, Netramesh tendrá soporte para otros protocolos de nivel de aplicación además de HTTP. En un futuro cercano, habrá una funcionalidad de enrutamiento L7.
Utilice Netramesh si enfrenta problemas similares y envíenos sus preguntas y sugerencias.
Fuente: habr.com
