

Lo que me inspiró a escribir este artículo fue la gran cantidad de materiales sobre análisis estático que cada vez más a menudo caen en mis manos. En primer lugar, esta es , que se promociona activamente en Habr mediante reseñas de errores que su herramienta ha encontrado en proyectos de código abierto. Recientemente, PVS-studio implementó , y, por supuesto, los desarrolladores de IntelliJ IDEA, cuyo analizador integrado es, hoy en día, probablemente el más avanzado para Java, .
Al leer tales reseñas, se tiene la sensación de que se habla de un elixir mágico: presiona un botón y ahí está, una lista de defectos ante tus ojos. Parece que a medida que los analizadores mejoran, se encontrarán cada vez más errores automáticamente, y los productos escaneados por estos robots se volverán cada vez mejores, sin ningún esfuerzo de nuestra parte.
Pero no existen elixires mágicos. Me gustaría hablar sobre lo que normalmente no se menciona en publicaciones como "esto es lo que puede encontrar nuestro robot": lo que los analizadores nunca podrán hacer, cuál es su verdadero papel y lugar en el proceso de entrega de software, y cómo implementarlos correctamente.
Rattrapante (fuente: ).
)
Lo que los analizadores estáticos nunca podrán hacer
¿Qué es, desde un punto de vista práctico, el análisis de código fuente? Proporcionamos ciertos fuentes como entrada, y en poco tiempo (mucho más corto que ejecutar pruebas) obtenemos cierta información sobre nuestro sistema. La limitación fundamental y matemáticamente insuperable es que solo podemos obtener, de esta manera, una clase bastante restringida de información. el problema de la parada , que establece que para cualquier propiedad no trivial de funciones computables, la determinación de si un programa arbitrario calcula una función con dicha propiedad es una tarea algorítmicamente irreducible. Por ejemplo, es imposible escribir un analizador que, dado cualquier código fuente, determine si el programa analizado es una implementación de un algoritmo que, digamos, calcula el cuadrado de un número entero.
Por lo tanto, la funcionalidad de los analizadores estáticos tiene limitaciones insuperables. Un analizador estático nunca podrá en todos los casos determinar cosas como, por ejemplo, la aparición de un "null pointer exception" en lenguajes que permiten el valor null, o en todos los casos determinar la aparición de "attribute not found" en lenguajes con tipado dinámico. Todo lo que puede hacer el analizador estático más avanzado es señalar casos particulares, cuyo número entre todos los posibles problemas con su código fuente es, sin exagerar, una gota en el océano.
El análisis estático no es la búsqueda de errores.
De lo anterior se deduce la conclusión: el análisis estático no es un medio para reducir la cantidad de defectos en el programa. Me atrevería a afirmar que, al aplicarlo por primera vez a su proyecto, encontrará en el código lugares 'interesantes', pero, lo más probable, no encontrará defectos que afecten la calidad de funcionamiento de su programa.
Los ejemplos de defectos encontrados automáticamente por analistas son impresionantes, pero no hay que olvidar que estos ejemplos se encuentran mediante el escaneo de un gran conjunto de bases de código grandes. De la misma manera, los hackers que tienen la capacidad de probar varias contraseñas sencillas en numerosas cuentas, eventualmente encontrarán las cuentas que tienen una contraseña sencilla.
¿Significa esto que el análisis estático no debe aplicarse? ¡Por supuesto que no! Y exactamente por la misma razón por la cual se debe verificar cada nueva contraseña para ver si se encuentra en la lista de 'contraseñas sencillas'.
El análisis estático es más que la búsqueda de errores.
De hecho, las tareas que se pueden resolver prácticamente mediante el análisis son mucho más amplias. En general, el análisis estático consiste en cualquier verificación del código fuente que se realice antes de su ejecución. Aquí hay algunas cosas que se pueden hacer:
- La verificación del estilo de codificación en un sentido amplio. Esto incluye tanto la verificación del formato como la búsqueda del uso de paréntesis vacíos/redundantes, la configuración de umbrales para métricas como el número de líneas/ complejidad ciclomática del método, etc.: todo lo que podría dificultar la legibilidad y mantenibilidad del código. En Java, una herramienta de este tipo es Checkstyle; en Python, es flake8. Programas de este tipo suelen denominarse «linters».
- No solo se puede analizar el código ejecutable. Los archivos de recursos, como JSON, YAML, XML y .properties, pueden (¡y deben!) ser verificados automáticamente por su validez. ¿No es mejor detectar que, debido a comillas desiguales, se ha alterado la estructura de JSON en una etapa temprana de verificación automática de Pull Request que durante la ejecución de pruebas o en tiempo de ejecución? Existen herramientas adecuadas: por ejemplo, , .
- La compilación (o el análisis sintáctico para lenguajes de programación dinámicos) también es una forma de análisis estático. Generalmente, los compiladores son capaces de emitir advertencias que indican problemas con la calidad del código fuente y no deben ser ignoradas.
- A veces, la compilación no se limita solo a compilar código ejecutable. Por ejemplo, si usted tiene documentación en formato , al convertirla a HTML/PDF, el procesador AsciiDoctor () puede emitir advertencias, por ejemplo, sobre enlaces internos rotos. Y esta es una razón válida para no aceptar un Pull Request con cambios en la documentación.
- La verificación de la ortografía también es una forma de análisis estático. La utilidad puede verificar la ortografía no solo en la documentación, sino también en el código fuente de programas (comentarios y literales) en diferentes lenguajes de programación, incluidos C/C++, Java y Python. ¡Un error de ortografía en la interfaz de usuario o en la documentación también es un defecto!
- Las pruebas de configuración (para más información, consulte y las presentaciones), aunque se llevan a cabo en un entorno de ejecución de pruebas unitarias como pytest, de hecho también son una forma de análisis estático, ya que no ejecutan el código fuente durante su ejecución.
Como podemos ver, la búsqueda de errores en esta lista ocupa un lugar menos importante, mientras que todo lo demás está disponible mediante el uso de herramientas open source gratuitas.
¿Cuáles de estos tipos de análisis estático deberían aplicarse en su proyecto? Por supuesto, todos, ¡cuanto más, mejor! Lo principal es implementarlos correctamente, de lo que hablaremos a continuación.
El canal de suministro como un filtro de múltiples etapas y el análisis estático como su primera cascada.
La metáfora clásica de la integración continua es el pipeline, por el cual fluyen los cambios: desde la modificación del código fuente hasta la entrega en producción. La secuencia estándar de etapas de este canal se ve así:
- análisis estático
- compilación
- pruebas unitarias
- pruebas de integración
- pruebas de UI
- revisión manual
Los cambios rechazados en la etapa N del canal no se transfieren a la etapa N+1.
¿Por qué así y no de otra manera? En la parte del canal que se ocupa de las pruebas, los evaluadores aprenden sobre la bien conocida pirámide de pruebas.
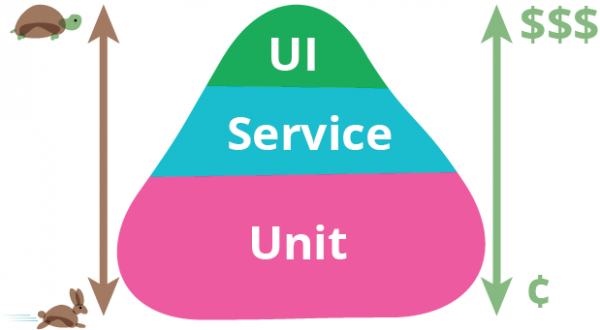
Pirámide de pruebas. Fuente: Martin Fowler.
En la parte inferior de esta pirámide se encuentran las pruebas que son más fáciles de escribir, que se ejecutan más rápido y tienen menos probabilidad de falsos positivos. Por ello, deberían ser más numerosas, cubrir más código y ejecutarse primero. En la parte superior de la pirámide, la situación es la opuesta, por lo que el número de pruebas de integración y de UI debe reducirse al mínimo necesario. La persona en esta cadena es el recurso más caro, lento e ineficaz, por lo que se encuentra al final y desempeña su trabajo solo si las etapas anteriores no detectaron defectos. Sin embargo, el canal también se construye según los mismos principios en las partes no directamente relacionadas con las pruebas.
Quisiera proponer una analogía en forma de un sistema de filtración de agua de múltiples etapas. En la entrada se introduce agua sucia (cambios con defectos), mientras que en la salida debemos obtener agua limpia, de la cual se han eliminado todas las impurezas indeseadas.
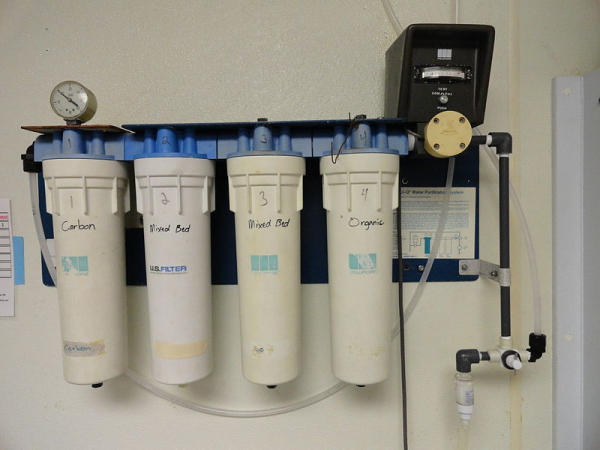
Filtro de múltiples etapas. Fuente:
Como es conocido, los filtros de limpieza se diseñan de tal manera que cada cascada sucesiva puede filtrar fracciones de contaminantes cada vez más pequeñas. Al mismo tiempo, las cascadas de limpieza más gruesa tienen mayor capacidad de paso y menor costo. En nuestra analogía, esto significa que las puertas de calidad de entrada tienen un mayor rendimiento, requieren menos esfuerzo para activarse y son más fáciles de manejar en sí mismas, y es en ese orden que están dispuestas. El papel del análisis estático, que, como ahora entendemos, solo puede detectar los defectos más groseros, es comparable al de una rejilla
El análisis estático en sí mismo no mejora la calidad del producto final, como la rejilla no convierte el agua en potable. Sin embargo, en conjunto con otros elementos de la línea de producción, su importancia es evidente. Aunque en un filtro de múltiples cascadas las cascadas de salida potencialmente pueden captar lo mismo que las de entrada, es claro a qué consecuencias conducirá el intentar depender únicamente de las cascadas de filtrado fino, sin los cascadas de entrada.
El objetivo de la rejilla es liberar las cascadas posteriores de la carga de capturar defectos muy groseros. Por ejemplo, al menos, la persona que realiza la revisión del código no debería distraerse con el código mal formateado o infringir las normas de codificación establecidas (como paréntesis extras o niveles de anidamiento excesivos). Los errores como NPE deben ser detectados por pruebas modulares, pero si antes de la prueba el analizador nos señala que el error debe ocurrir inevitablemente, esto acelerará significativamente su corrección.
Supongo que ahora está claro por qué el análisis estático no mejora la calidad del producto si se aplica de manera episódica, y debe aplicarse de forma continua para filtrar cambios con defectos groseros. La cuestión de si el uso de un analizador estático mejorará la calidad de su producto es aproximadamente equivalente a preguntar '¿mejorará la potabilidad del agua tomada de una fuente sucia si se pasa por un colador?'
Implementación en un proyecto legado
Pregunta práctica importante: ¿cómo implementar el análisis estático en el proceso de integración continua como "quality gate"? En el caso de las pruebas automáticas, todo es obvio: hay un conjunto de pruebas, y la falla de cualquiera de ellas es suficiente para considerar que la compilación no ha pasado el quality gate. Intentar establecer un gate de la misma manera basado en los resultados del análisis estático falla: en el código legado hay demasiadas advertencias de análisis, no se quiere ignorarlas por completo, pero tampoco se puede detener la entrega del producto solo porque hay advertencias del analizador.
Cuando se aplica por primera vez, en cualquier proyecto el analizador emite una gran cantidad de advertencias, la gran mayoría de las cuales no están relacionadas con el funcionamiento correcto del producto. No es posible corregir todas estas observaciones de inmediato, y muchas de ellas no son necesarias. Al fin y al cabo, ¡sabemos que nuestro producto en general funciona, incluso antes de implementar el análisis estático!
Como resultado, muchos se limitan a usar el análisis estático de forma esporádica, o lo utilizan solo en modo informativo, cuando simplemente se presenta un informe del analizador al compilar. Esto es equivalente a no hacer ningún análisis, porque si ya tenemos múltiples advertencias, la aparición de otra (sin importar cuán grave sea) al cambiar el código pasa desapercibida.
Se conocen las siguientes maneras de introducir quality gates:
- Establecer un límite en la cantidad total de advertencias o en la cantidad de advertencias divididas por el número de líneas de código. Esto funciona mal, ya que tal gate permite libremente cambios con nuevos defectos hasta que se supere su límite.
- La fijación, en un momento determinado, de todas las viejas advertencias en el código como ignoradas, y la negativa a compilar al surgir nuevas advertencias. Esta funcionalidad la proporciona PVS-studio y algunos recursos en línea, como Codacy. No he trabajado con PVS-studio, pero en cuanto a mi experiencia con Codacy, su principal problema es que definir qué es un error "viejo" y cuál es un "nuevo" es un algoritmo bastante complicado y que no siempre funciona correctamente, especialmente si los archivos se cambian o renombrados radicalmente. Recuerdo que Codacy podía omitir nuevas advertencias en un pull request y, al mismo tiempo, no permitir el merge de ese pull request debido a advertencias que no estaban relacionadas con los cambios en el código de dicho PR.
- En mi opinión, la solución más eficaz es la descrita en el libro «método de palanca» («ratcheting»). La idea principal es que la propiedad de cada lanzamiento es el número de advertencias de análisis estático, y solo se permiten cambios que no aumenten el número total de advertencias.
Palanca
Funciona de la siguiente manera:
- En la etapa inicial se registra en los metadatos del lanzamiento el número de advertencias en el código encontradas por los analizadores. Así, al compilar la rama principal, se registra en su gestor de repositorios no solo "lanzamiento 7.0.2", sino "lanzamiento 7.0.2, que contiene 100500 advertencias de Checkstyle". Si utiliza un gestor de repositorios avanzado (como Artifactory), es fácil conservar tales metadatos sobre su lanzamiento.
- Ahora cada pull request al compilar compara el número de advertencias que se generan con el número que existe en el lanzamiento actual. Si el PR aumenta este número, el código no pasa la puerta de calidad del análisis estático. Si el número de advertencias disminuye o no cambia, entonces pasa.
- En el siguiente lanzamiento, el número recalculado de advertencias se registrará nuevamente en los metadatos del lanzamiento.
Así, poco a poco, pero de forma constante (como en el funcionamiento de un ratchet), el número de advertencias tenderá a cero. Por supuesto, el sistema puede ser engañado al ingresar una nueva advertencia, pero corrigiendo la de otro. Esto es normal, ya que a largo plazo da resultado: las advertencias se corrigen, por lo general, no de una en una, sino en grupo de un tipo determinado, y todas las advertencias fácilmente corregibles se eliminan bastante rápido.
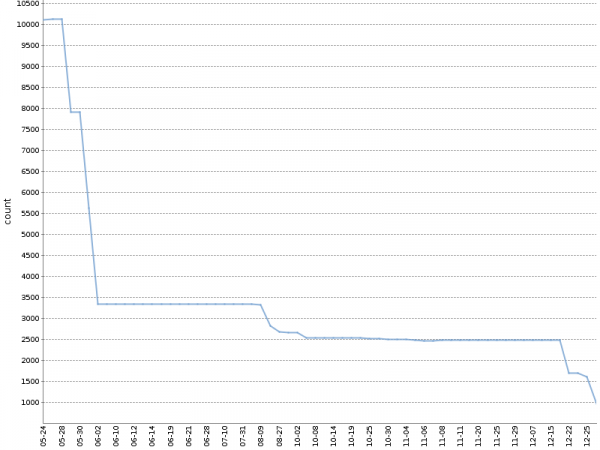
En este gráfico se muestra el número total de advertencias de Checkstyle durante seis meses de funcionamiento de tal "ratchet" en . El número de advertencias se ha reducido en un orden de magnitud, y esto ha ocurrido de forma natural, paralelamente al desarrollo del producto.
Aplico una versión modificada de este método, contabilizando por separado las advertencias desglosadas por módulos del proyecto y herramientas de análisis; el archivo YAML con metadatos de la compilación que se genera tiene un aspecto aproximadamente como el siguiente:
celesta-sql:
  checkstyle: 434
  spotbugs: 45
celesta-core:
  checkstyle: 206
  spotbugs: 13
celesta-maven-plugin:
  checkstyle: 19
  spotbugs: 0
celesta-unit:
  checkstyle: 0
  spotbugs: 0
En cualquier sistema CI avanzado, un "ratchet" se puede implementar para cualquier herramienta de análisis estático, sin depender de complementos y herramientas externas. Cada uno de los analizadores genera su informe en un formato de texto simple o XML, que es fácil de analizar. Solo queda escribir la lógica necesaria en el script CI. Puedes ver cómo se implementa esto en nuestros proyectos de código abierto basados en Jenkins y Artifactory. o . Ambos ejemplos dependen de la biblioteca : el método countWarnings() cuenta normalmente las etiquetas xml en los archivos generados por Checkstyle y Spotbugs, y compareWarningMaps() implementa el ratchet mismo, lanzando un error en caso de que el número de advertencias en alguna de las categorías aumente.
Una interesante implementación de un «ratchet» es posible para el análisis de la ortografía de comentarios, literales de texto y documentación utilizando aspell. Como se sabe, al verificar la ortografía, no todas las palabras desconocidas para el diccionario estándar son incorrectas, pueden ser añadidas al diccionario personalizado. Si se hace del diccionario personalizado parte del código fuente del proyecto, entonces se puede formular un quality gate de ortografía de la siguiente manera: ejecutar aspell con el diccionario estándar y el personalizado. encontrar ningún error de ortografía.
Sobre la importancia de fijar la versión del analizador
En conclusión, es necesario señalar lo siguiente: independientemente de cómo implementes el análisis en tu canal de entrega, la versión del analizador debe ser fijada. Si se permite que el analizador se actualice automáticamente, al ensamblar el próximo pull request pueden «emergir» nuevos defectos, que no están relacionados con el cambio de código, sino que se vinculan al hecho de que el nuevo analizador simplemente puede encontrar más defectos, lo que interrumpirá tu proceso de aceptación de pull requests. El upgrade del analizador debe ser una acción consciente. Sin embargo, la fijación rigurosa de la versión de cada componente de la construcción es, en general, un requisito necesario y un tema para una conversación separada.
Conclusiones
- El análisis estático no encontrará bugs ni mejorará la calidad de tu producto como resultado de una sola aplicación. El efecto positivo en la calidad solo se obtiene mediante su uso constante en el proceso de entrega.
- La búsqueda de bugs no es en absoluto la tarea principal del análisis; la abrumadora mayoría de las funciones útiles están disponibles en herramientas opensource.
- Implementa quality gates basados en los resultados del análisis estático en la primera etapa del canal de entrega, utilizando un «ratchet» para el código legado.
Enlaces
- presentación sobre diferentes métodos de análisis de código (¡no solo estático!)
Fuente: habr.com
