

RabbitMQ es un broker de mensajes escrito en Erlang que permite organizar un clúster tolerante a fallos con replicación completa de datos en varios nodos, donde cada nodo puede manejar solicitudes de lectura y escritura. Habiendo utilizado múltiples clústeres de Kubernetes en producción, soportamos una gran cantidad de instalaciones de RabbitMQ y hemos enfrentado la necesidad de migrar datos de un clúster a otro sin tiempo de inactividad.
Esta operación fue necesaria para nosotros en al menos dos casos:
- Transferir datos de un clúster de RabbitMQ que no está en Kubernetes a un nuevo clúster que ya está "kubernetizado" (es decir, funcionando en pods de K8s).
- Migrar RabbitMQ dentro de Kubernetes de un namespace a otro (por ejemplo, si los contornos están delimitados por espacios de nombres, para trasladar infraestructura de un contorno a otro).
La receta propuesta en este artículo está orientada a situaciones (pero no se limita a ellas) en las que hay un antiguo clúster de RabbitMQ (por ejemplo, de 3 nodos), que está ya en K8s o en algunos servidores antiguos. Está asociado a una aplicación que se ubica en Kubernetes (ya sea allí o en perspectiva):
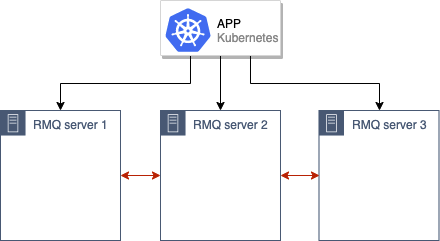
… y se nos presenta la tarea de migrarlo a un nuevo entorno de producción en Kubernetes.
Primero se describirá el enfoque general para la migración, y luego se detallarán los aspectos técnicos de su implementación.
Algoritmo de migración
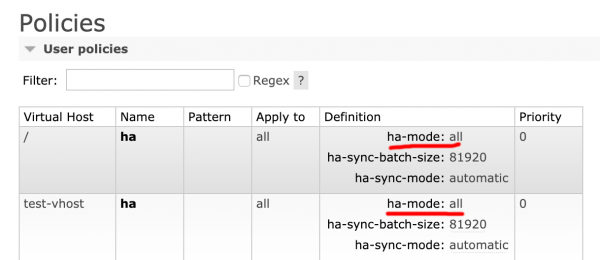
El primer paso preliminar antes de cualquier acción es verificar que la antigua instalación de RabbitMQ tiene activado el modo de alta disponibilidad (). La razón es evidente: no queremos perder ningún dato. Para llevar a cabo esta verificación, se puede acceder al panel de administración de RabbitMQ y en la pestaña Admin → Policies asegurarse de que está configurado el valor ha-mode: all:
El siguiente paso es levantar un nuevo clúster de RabbitMQ en pods de Kubernetes (en nuestro caso, por ejemplo, compuesto por 3 nodos, pero puede ser cualquier otro número).
Después de esto, combinamos el antiguo y el nuevo clúster de RabbitMQ, obteniendo un único clúster (de 6 nodos):
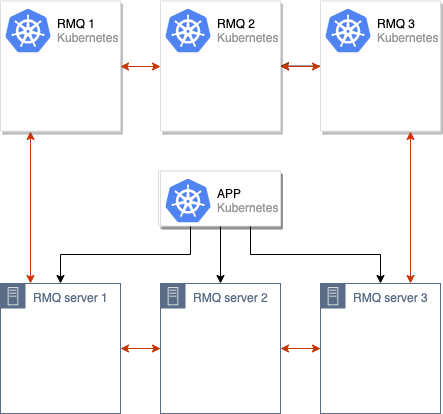
Se inicia el proceso de sincronización de datos entre el antiguo y el nuevo clúster de RabbitMQ. Después de que todos los datos se sincronicen entre todos los nodos del clúster, podemos cambiar la aplicación para usar el nuevo clúster:
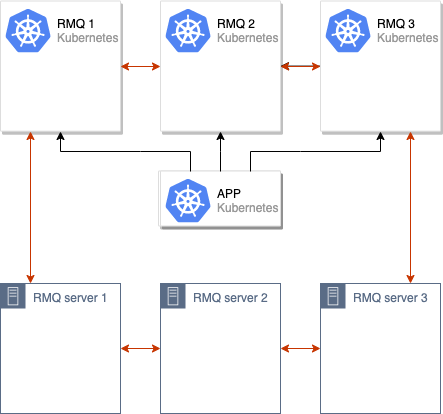
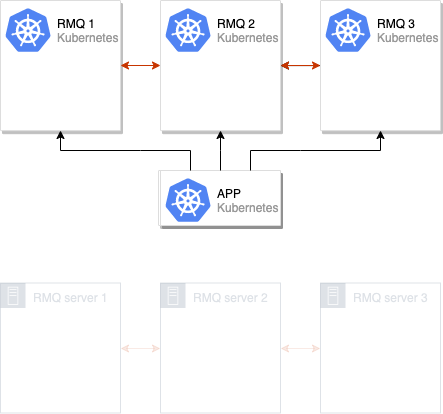
Después de estas operaciones, es suficiente desconectar los antiguos nodos del clúster de RabbitMQ y se puede considerar finalizada la migración:
Hemos utilizado este esquema en producción en varias ocasiones. Sin embargo, para nuestra propia comodidad, lo implementamos en el marco de un sistema especializado que distribuye configuraciones estándar de RMQ en múltiples clústeres de Kubernetes. (para aquellos a quienes les interese: se trata de , del cual ya hemos ). A continuación se presentarán instrucciones específicas que cada uno puede aplicar en sus instalaciones para probar la solución propuesta en acción.
Probando en la práctica
Requisitos
Los requisitos son muy sencillos:
- Clúster de Kubernetes (también sirve minikube);
- Un clúster RabbitMQ (que puede estar desplegado en bare metal o configurado como un clúster estándar en Kubernetes utilizando el Helm chart oficial).
Para el ejemplo a continuación, desplegué RMQ en Kubernetes y lo llamé rmq-old.
Preparación del entorno
1. Descargamos el Helm chart y lo editamos un poco:
helm fetch --untar stable/rabbitmq-ha Por comodidad, establecemos una contraseña, ErlangCookie y creamos una política ha-all, para que por defecto las colas se sincronicen entre todos los nodos del clúster RMQ:
rabbitmqPassword: guest
rabbitmqErlangCookie: mae9joopaol7aiVu3eechei2waiGa2we
definitions:
policies: |-
  {
    "name": "ha-all",
    "pattern": ".*",
    "vhost": "\/",
    "definition": {
      "ha-mode": "all",
      "ha-sync-mode": "automatic",
      "ha-sync-batch-size": 81920
    }
  }
2. Instalamos el chart:
helm install . --name rmq-old --namespace rmq-old3. Entramos en la interfaz de administración de RabbitMQ, creamos una nueva cola y añadimos algunos mensajes. Los necesitaremos para asegurarnos, después de la migración, de que todos los datos se han preservado y no hemos perdido nada:

El entorno de prueba está listo: tenemos un RabbitMQ "antiguo" con datos que deben ser transferidos.
Migración del clúster RabbitMQ
1. Primero, desplegaremos un nuevo RabbitMQ en otra un espacio de nombres con las mismas ErlangCookie y contraseña para el usuario. Para ello, realizaremos las operaciones descritas anteriormente, modificando el comando final para la instalación de RMQ de la siguiente manera:
helm install . --name rmq-new --namespace rmq-new2. Ahora es necesario unir el nuevo clúster con el antiguo. Para ello, accedemos a cada uno de los pod nuevo RabbitMQ y ejecutamos los comandos:
export OLD_RMQ=rabbit@rmq-old-rabbitmq-ha-0.rmq-old-rabbitmq-ha-discovery.rmq-old.svc.cluster.local &&
  rabbitmqctl stop_app &&
  rabbitmqctl join_cluster $OLD_RMQ &&
  rabbitmqctl start_app
En la variable OLD_RMQ es la dirección de uno de los nodos del antiguo clúster RMQ.
Estos comandos detendrán el nodo actual nuevo del clúster RMQ, lo unirán al clúster antiguo y lo reiniciarán.
3. El clúster RMQ de 6 nodos está listo:
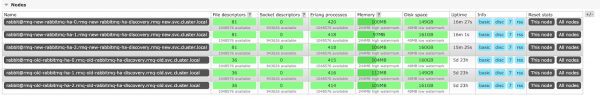
Hay que esperar a que los mensajes se sincronicen entre todos los nodos. No es difícil adivinar que el tiempo de sincronización de mensajes depende de la capacidad del hardware en el que se despliega el clúster y de la cantidad de mensajes. En el escenario descrito, hay solo 10, por lo que los datos se sincronizaron instantáneamente, pero con una cantidad significativamente mayor de mensajes, la sincronización puede llevar horas.
Así que, el estado de sincronización:

Aquí +5 significa que los mensajes ya están aún en 5 nodos (además del que se indica en el campo Nodo). Así, la sincronización fue exitosa.
4. Solo queda cambiar en la aplicación la dirección de RMQ al nuevo clúster (las acciones específicas aquí dependen de la pila tecnológica que estés usando y de otras especificidades de la aplicación), después de lo cual puedes despedirte del antiguo.
Para la última operación (es decir, ya después de cambiando la aplicación al nuevo clúster) accedemos a cada nodo del antiguo del clúster y ejecutamos los comandos:
rabbitmqctl stop_app
rabbitmqctl reset
El clúster "ha olvidado" acerca de los antiguos nodos: se puede eliminar el viejo RMQ, completando así la migración.
Nota: Si utilizas RMQ con certificados, entonces no hay cambios fundamentales: el proceso de migración se llevará a cabo exactamente de la misma manera.
Conclusiones
El esquema descrito se adapta prácticamente a todos los casos en que necesitamos trasladar RabbitMQ o simplemente mudarnos a un nuevo clúster.
En nuestro caso, solo tuvimos dificultades una vez, cuando RMQ fue accedido desde múltiples lugares, y no tuvimos la oportunidad de cambiar la dirección de RMQ a la nueva en todos los lugares. En ese caso, lanzamos un nuevo RMQ en el mismo espacio de nombres con las mismas etiquetas, para que se incluyera en los servicios y Ingress ya existentes, y al iniciar el pod, manipulamos las etiquetas manualmente, eliminándolas al principio para que las solicitudes no llegaran al RMQ vacío, y volviéndolas a añadir después de la sincronización de mensajes.
Aplicamos la misma estrategia al actualizar RabbitMQ a una nueva versión con una configuración modificada: todo funcionó a la perfección.
P.D.
Como continuación lógica de este material, estamos preparando artículos sobre MongoDB (migración de un servidor físico a Kubernetes) y MySQL (cómo preparamos esta base de datos dentro de Kubernetes). Se publicarán en los próximos meses.
P.P.D.
También puedes leer en nuestro blog:
- «»;
- «».
Fuente: habr.com
