

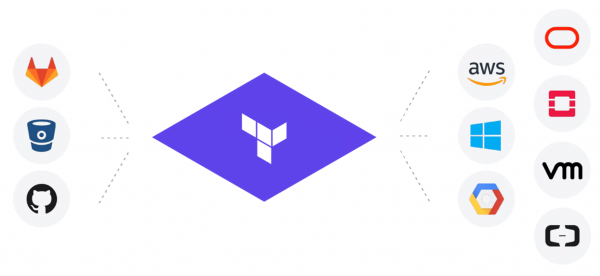
Me gustaría hablar sobre una nueva herramienta CLI que he desarrollado para resolver un viejo problema.
Problema
Terraform se ha convertido en un estándar en la comunidad DevOps/Cloud/IT desde hace tiempo. Es una herramienta muy conveniente y útil para gestionar infraestructura como código. Hay muchas ventajas en Terraform, así como muchos baches y peros.
Con Terraform es muy fácil crear cosas nuevas y luego gestionarlas, modificarlas o eliminarlas. Pero, ¿qué hacer con aquellos que tienen una gran infraestructura en la nube que no fue creada a través de Terraform? Reescribir y recrear toda la nube resulta costoso y poco seguro.
He enfrentado este problema en dos trabajos, el ejemplo más simple es querer que todo esté en Git en forma de archivos Terraform, y tienes más de 250 buckets, escribirlos a mano para Terraform resulta excesivo.
Hay desde 2014 existe un issue en Terraform que fue cerrado en 2016 con la esperanza de que se implementara la opción de importación.
En general, todo es como se muestra en la imagen, pero de derecha a izquierda.
Advertencia: El autor no vive en Rusia desde hace medio vida y escribe poco en ruso. Cuidado con los errores ortográficos.
Soluciones
1. Hay soluciones antiguas y ya existentes para AWS . Cuando intenté obtener mis más de 250 buckets a través de él, me di cuenta de que estaba lleno de problemas. AWS ha introducido muchas nuevas opciones desde entonces, y terraforming no las conoce, además, usa ruby. . Después de dos noches, envié para añadir más funcionalidades y entendí que este enfoque no era adecuado en absoluto.
Cómo funciona terraforming: toma datos del SDK de AWS y genera tf y tfstate a través de un template.
Aquí hay 3 problemas:
1. Siempre habrá retrasos en las actualizaciones
2. Los archivos tf a veces están dañados
3. tfstate se genera por separado de tf y no siempre coinciden
En general, es complicado obtener un resultado donde `terraform plan` indique que no hay cambios
2. `terraform import` — es un comando incorporado en terraform. ¿Cómo funciona?
Escribes un archivo TF vacío con el nombre y tipo de recurso, luego ejecutas `terraform import` y pasas el ID del recurso. Terraform se comunica con el proveedor, obtiene los datos y crea el archivo tfstate.
Aquí hay 3 problemas:
1. Solo obtenemos el archivo tfstate, mientras que el tf está vacío y hay que escribirlo a mano o convertirlo desde el tfstate.
2. Solo puede trabajar con un recurso a la vez y no soporta todos los recursos. ¿Y qué debo hacer de nuevo con más de 250 buckets?
3. Hay que conocer el ID de los recursos, es decir, hay que envolverlo en un código que obtenga la lista de recursos.
En general, el resultado es parcial y no escala bien.
Mis decisiones
Requisitos:
1. Capacidad para crear archivos tf y tfstate a partir de recursos. Por ejemplo, descargar todos los buckets / grupos de seguridad / balanceadores de carga y que 'terraform plan' devuelva que no hay cambios
2. Necesito 2 nubes GCP + AWS
3. Una solución global que sea fácil de actualizar cada vez y que no requiera dedicar 3 días de trabajo a cada recurso
4. Hacerlo de código abierto — es un problema que todos tienen
Lenguaje Go — por eso lo amo, y hay una biblioteca para crear archivos HCL que se utiliza en terraform + mucho código en terraform que puede ser útil
Ruta
Primer intento
Comencé con una opción simple. Acceder a la nube a través de SDK para obtener el recurso necesario y convertirlo en campos para terraform. El intento fracasó de inmediato con el grupo de seguridad porque no me gustó pasar 1.5 días convirtiendo solo el grupo de seguridad (hay muchos recursos). Es largo y luego los campos pueden cambiar / añadirse
Segundo intento
Basado en la idea descrita . Simplemente tomar y convertir tfstate a tf. Todos los datos están ahí y los campos son los mismos. ¿Cómo obtener un tfstate completo para muchos recursos? Aquí la ayuda vino del comando 'terraform refresh'. Terraform toma todos los recursos en tfstate y, por ID, extrae los datos de ellos y los escribe en tfstate. Es decir, crear un tfstate vacío solo con los nombres y ID, ejecutar 'terraform refresh' y obtenemos tfstate completo. ¡Hurra!
Ahora nos ocuparemos de la escritura recursiva de un convertidor para tfstate a tf. Para aquellos que nunca han leído tfstate, esto es JSON, pero especial.
Aquí está su parte importante attributes
 "attributes": {
                            "id": "default/backend-logging-load-deployment",
                            "metadata.#": "1",
                            "metadata.0.annotations.%": "0",
                            "metadata.0.generate_name": "",
                            "metadata.0.generation": "24",
                            "metadata.0.labels.%": "1",
                            "metadata.0.labels.app": "backend-logging",
                            "metadata.0.name": "backend-logging-load-deployment",
                            "metadata.0.namespace": "default",
                            "metadata.0.resource_version": "109317427",
                            "metadata.0.self_link": "/apis/apps/v1/namespaces/default/deployments/backend-logging-load-deployment",
                            "metadata.0.uid": "300ecda1-4138-11e9-9d5d-42010a8400b5",
                            "spec.#": "1",
                            "spec.0.min_ready_seconds": "0",
                            "spec.0.paused": "false",
                            "spec.0.progress_deadline_seconds": "600",
                            "spec.0.replicas": "1",
                            "spec.0.revision_history_limit": "10",
                            "spec.0.selector.#": "1",
Aquí hay:
1. id — cadena
2. metadata — array de tamaño 1 y contiene un objeto con los campos que se describen a continuación
3. spec — hash de tamaño 1 y contiene key,value
En resumen, es un formato divertido, todo puede ser en profundidad también a varios niveles.
                   "spec.#": "1",
                            "spec.0.min_ready_seconds": "0",
                            "spec.0.paused": "false",
                            "spec.0.progress_deadline_seconds": "600",
                            "spec.0.replicas": "1",
                            "spec.0.revision_history_limit": "10",
                            "spec.0.selector.#": "1",
                            "spec.0.selector.0.match_expressions.#": "0",
                            "spec.0.selector.0.match_labels.%": "1",
                            "spec.0.selector.0.match_labels.app": "backend-logging-load",
                            "spec.0.strategy.#": "0",
                            "spec.0.template.#": "1",
                            "spec.0.template.0.metadata.#": "1",
                            "spec.0.template.0.metadata.0.annotations.%": "0",
                            "spec.0.template.0.metadata.0.generate_name": "",
                            "spec.0.template.0.metadata.0.generation": "0",
                            "spec.0.template.0.metadata.0.labels.%": "1",
                            "spec.0.template.0.metadata.0.labels.app": "backend-logging-load",
                            "spec.0.template.0.metadata.0.name": "",
                            "spec.0.template.0.metadata.0.namespace": "",
                            "spec.0.template.0.metadata.0.resource_version": "",
                            "spec.0.template.0.metadata.0.self_link": "",
                            "spec.0.template.0.metadata.0.uid": "",
                            "spec.0.template.0.spec.#": "1",
                            "spec.0.template.0.spec.0.active_deadline_seconds": "0",
                            "spec.0.template.0.spec.0.container.#": "1",
                            "spec.0.template.0.spec.0.container.0.args.#": "3",
En general, si alguien quiere un problema de programación para la entrevista, simplemente pídanle que escriba un parser para esto 🙂.
Después de muchos intentos de escribir un parser sin errores, encontré parte de él en el código de terraform, y de hecho, la parte más importante. Y todo parecía funcionar bien.
Intento tres.
Un proveedor de terraform es un binario que contiene código con todos los recursos y la lógica para trabajar con las API de nubes. Cada nube tiene su propio proveedor y terraform simplemente los llama a través de su protocolo RPC entre dos procesos.
Ahora decidí llamar directamente a los proveedores de terraform a través de llamadas RPC. Así salió bonito y permitió cambiar los proveedores de terraform por versiones más nuevas y obtener nuevas funcionalidades sin cambiar el código. También resultó que no todos los campos en tfstate deben estar en tf, ¿y cómo saberlo? Solo preguntando al proveedor sobre ello. Luego comenzó otra pornografía recursiva sobre la construcción de expresiones regulares con el lío de buscar campos dentro de tfstate en todos los niveles en profundidad.
Al final, resultó ser una herramienta CLI útil que tiene una infraestructura común para todos los proveedores de terraform y se puede agregar fácilmente uno nuevo. También, la adición de recursos requiere poco código. Además, hay ventajas como la conexión entre recursos. Por supuesto, hubo muchos problemas diferentes que no se pueden describir todos.
Llamé a la herramienta Terrafomer.
Intenté no escribir mucho, pero aún así me parece que la entrada resultó bastante larga. Las demás características de unRAID son bastante simples de configurar, sobre todo porque todo se configura con el ratón.
Con Terrafomer generamos de 500,000 a 700,000 líneas de código tf + tfstate en dos nubes. Pudimos tomar cosas heredadas y empezar a trabajarlas solo a través de terraform, como en las mejores ideas de infraestructura como código. Es pura magia cuando tomas una nube enorme y obtienes, con un comando, su representación en archivos terraform. Luego, solo grep/replace/git y así sucesivamente.
Analicé y ordené, obtuve permisos. Lo publiqué en GitHub para todos el jueves (02.05.19).
Ya obtuvo 600 estrellas, 2 pull requests agregando soporte para openstack y kubernetes. Buenos comentarios. En general, es un proyecto útil para la gente.
Se lo recomiendo a todos los que quieran empezar a trabajar con Terraform y no quieran reescribir todo para ello.
Estaré encantado de recibir pull requests, issues, estrellas.
Demo
Fuente: habr.com
