

Hola, amigos. Antes de irnos a la segunda parte de las festividades de mayo, compartimos con ustedes un material que hemos traducido en anticipación al lanzamiento de un nuevo curso. .
Los desarrolladores de aplicaciones dedican mucho tiempo a comparar varias bases de datos operativas para seleccionar la que mejor se adapte a la carga de trabajo prevista. Las necesidades pueden incluir modelado de datos simplificado, garantías transaccionales, rendimiento de lectura/escritura, escalabilidad horizontal y resistencia a fallos. Tradicionalmente, la selección comienza con la categoría de base de datos, SQL o NoSQL, ya que cada categoría ofrece un conjunto claro de compromisos. Un alto rendimiento en términos de baja latencia y alta capacidad de procesamiento generalmente se considera una necesidad innegociable, y por lo tanto es esencial para cualquier base de datos de la selección.
El objetivo de este artículo es ayudar a los desarrolladores de aplicaciones a tomar la decisión correcta entre SQL y NoSQL en el contexto del modelado de datos de la aplicación. Examinaremos una base de datos SQL, específicamente PostgreSQL, y dos bases de datos NoSQL: Cassandra y MongoDB, para discutir los fundamentos del diseño de bases de datos, como la creación de tablas, la inserción de datos, la lectura de datos de una tabla y su eliminación. En el próximo artículo, definitivamente abordaremos índices, transacciones, JOINs, directivas TTL y diseño de bases de datos basadas en JSON.
¿Cuál es la diferencia entre SQL y NoSQL?
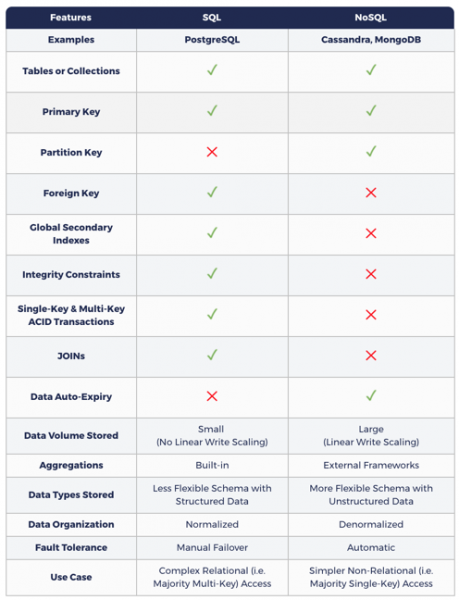
Las bases de datos SQL aumentan la flexibilidad de la aplicación gracias a las garantías transaccionales ACID, así como a su capacidad para consultar datos mediante JOIN de maneras inesperadas sobre modelos normalizados existentes de bases de datos relacionales.
Dada su arquitectura monolítica/unicapa y el uso del modelo de replicación maestro-esclavo para redundancia, las bases de datos SQL tradicionales carecen de dos características importantes: escalabilidad lineal de escritura (es decir, particionamiento automático en múltiples nodos) y pérdida de datos automática/cero. Esto significa que la cantidad de datos recibidos no puede exceder el máximo de escritura de un solo nodo. Además, cierta pérdida temporal de datos debe tenerse en cuenta en la tolerancia a fallos (en una arquitectura sin particionamiento de recursos). Aquí se debe tener en cuenta que los commits recientes aún no se han reflejado en la copia esclava. Las actualizaciones sin tiempo de inactividad también son difíciles de lograr en bases de datos SQL.
Las bases de datos NoSQL son, por naturaleza, generalmente distribuidas, es decir, los datos se dividen en secciones y se distribuyen entre varios nodos. Requieren desnormalización. Esto significa que los datos ingresados también deben ser copiados varias veces para responder a las consultas específicas que envías. El objetivo general es lograr un alto rendimiento al reducir la cantidad de shards disponibles durante la lectura. De aquí se deduce que NoSQL requiere que modeles tus consultas, mientras que SQL requiere que modeles tus datos.
NoSQL se centra en lograr un alto rendimiento en un clúster distribuido, y esta es la principal justificación de muchos compromisos en el diseño de bases de datos, que incluyen la pérdida de garantías transaccionales ACID, JOINs e índices secundarios globales consistentes.
Hay una opinión de que, aunque las bases de datos NoSQL ofrecen escalabilidad lineal de escritura y alta tolerancia a fallos, la pérdida de garantías transaccionales las hace inapropiadas para datos críticos.
La siguiente tabla muestra cómo la modelación de datos en NoSQL difiere de SQL.
SQL y NoSQL: ¿Por qué se necesitan ambos?
En aplicaciones reales con una gran cantidad de usuarios, como Amazon.com, Netflix, Uber y Airbnb, se llevan a cabo tareas complejas y diversas. Por ejemplo, una aplicación de comercio electrónico como Amazon.com necesita almacenar datos ligeros y críticos, como información sobre usuarios, productos, pedidos y facturas, junto con datos pesados pero menos sensibles, como reseñas de productos, mensajes del servicio de atención al cliente, actividad de los usuarios, comentarios y recomendaciones. Naturalmente, estas aplicaciones dependen de al menos una base de datos SQL junto con al menos una base de datos NoSQL. En sistemas interregionales y globales, la base de datos NoSQL funciona como un caché geográficamente distribuido para los datos almacenados en una fuente confiable, la base de datos SQL, que opera en una región específica.
¿Cómo integra YugaByte DB SQL y NoSQL?
Construida sobre un motor de almacenamiento híbrido orientado a registros, con auto-sharding, replicación de consenso distribuido shard y transacciones ACID distribuidas (inspiradas en Google Spanner), YugaByte DB es la primera base de datos de código abierto del mundo que es simultáneamente compatible con NoSQL (Cassandra & Redis) y SQL (PostgreSQL). Como se muestra en la tabla a continuación, YCQL, la API de YugaByte DB compatible con Cassandra, agrega conceptos de transacciones ACID de una y múltiples claves y de índices secundarios globales en la API NoSQL, abriendo así la era de las bases de datos NoSQL transaccionales. Además, YCQL, la API de YugaByte DB compatible con PostgreSQL, agrega conceptos de escalado lineal de escrituras y tolerancia a fallos automática a la API SQL, presentando al mundo las bases de datos SQL distribuidas. Dado que la base de datos YugaByte DB es en esencia transaccional, la API NoSQL ahora se puede utilizar en el contexto de datos críticos.
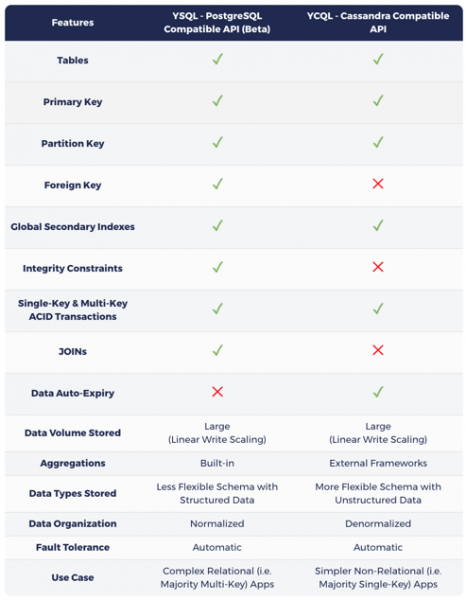
Como se mencionó anteriormente en el artículo , la elección entre SQL o NoSQL en YugaByte DB depende completamente de las características de la carga de trabajo principal:
- Si la carga de trabajo principal implica operaciones de múltiples claves con JOINs, al seleccionar YSQL, tenga en cuenta que sus claves pueden estar distribuidas en varios nodos, lo que resultará en una mayor latencia y/o una disminución del rendimiento en comparación con NoSQL.
- De lo contrario, elija cualquiera de las dos API NoSQL, recordando que obtendrá un rendimiento más alto como resultado de las consultas atendidas desde un solo nodo a la vez. YugaByte DB puede servir como una única base de datos operativa para aplicaciones complejas en tiempo real que requieren gestionar múltiples cargas de trabajo simultáneamente.
La base del laboratorio de modelado de datos en la siguiente sección consiste en APIs de bases de datos YugaByte DB compatibles con PostgreSQL y Cassandra, a diferencia de las bases de datos originales. Este enfoque subraya la simplicidad de la interacción con dos APIs diferentes (en dos puertos distintos) del mismo clúster de bases de datos en contraste con el uso de clústeres completamente independientes de dos bases de datos diferentes.
En las siguientes secciones, nos familiarizaremos con el laboratorio de modelado de datos para ilustrar las diferencias y algunas similitudes entre las bases de datos discutidas.
Laboratorio de modelado de datos
Instalación de bases de datos
Teniendo en cuenta el enfoque en el diseño del modelo de datos (y no en arquitecturas de despliegue complejas), instalaremos las bases de datos en contenedores Docker en una computadora local, y luego interactuaremos con ellas utilizando sus respectivas interfaces de línea de comandos.
Base de datos YugaByte DB compatible con PostgreSQL & Cassandra
mkdir ~/yugabyte && cd ~/yugabyte
wget https://downloads.yugabyte.com/yb-docker-ctl && chmod +x yb-docker-ctl
docker pull yugabytedb/yugabyte
./yb-docker-ctl create --enable_postgres
MongoDB
docker run --name my-mongo -d mongo:latestAcceso a través de la línea de comandos
Conectémonos a las bases de datos mediante la interfaz de línea de comandos para las APIs correspondientes.
PostgreSQL
— es la interfaz de línea de comandos para interactuar con PostgreSQL. Para facilitar el uso, YugaByte DB se incluye con psql directamente en la carpeta bin.
docker exec -it yb-postgres-n1 /home/yugabyte/postgres/bin/psql -p 5433 -U postgresCassandra
— es la interfaz de línea de comandos para interactuar con Cassandra y sus bases de datos compatibles a través de CQL (lenguaje de consultas de Cassandra). Para conveniencia, YugaByte DB se proporciona con cqlsh en el directorio bin.
Tenga en cuenta que CQL se inspiró en SQL y tiene conceptos similares de tablas, filas, columnas e índices. Sin embargo, como lenguaje NoSQL, agrega un conjunto de restricciones, la mayoría de las cuales también discutiremos en otros artículos.
docker exec -it yb-tserver-n1 /home/yugabyte/bin/cqlshMongoDB
– es una interfaz de línea de comandos para interactuar con MongoDB. Se puede encontrar en el directorio bin de la instalación de MongoDB.
docker exec -it my-mongo bash
cd bin
mongo
Creación de tabla
Ahora podemos interactuar con la base de datos para realizar varias operaciones a través de la línea de comandos. Empecemos creando una tabla que almacene información sobre canciones escritas por diferentes artistas. Estas canciones pueden formar parte de un álbum. También hay atributos opcionales para la canción: año de lanzamiento, precio, género y calificación. Necesitamos considerar atributos adicionales que pueden ser necesarios en el futuro a través del campo "etiquetas". Este puede almacenar datos semiestructurados en forma de pares clave-valor.
PostgreSQL
CREATE TABLE Music (
    Artist VARCHAR(20) NOT NULL,
    SongTitle VARCHAR(30) NOT NULL,
    AlbumTitle VARCHAR(25),
    Year INT,
    Price FLOAT,
    Genre VARCHAR(10),
    CriticRating FLOAT,
    Tags TEXT,
    PRIMARY KEY(Artist, SongTitle)
);
Cassandra
La creación de una tabla en Cassandra es muy similar a PostgreSQL. Una de las principales diferencias es la falta de restricciones de integridad (por ejemplo, NOT NULL), pero eso es responsabilidad de la aplicación, no de la base de datos NoSQL.. La clave primaria consiste en la clave de partición (columna Artist en el ejemplo a continuación) y un conjunto de columnas de clustering (columna SongTitle en el siguiente ejemplo). La clave de partición determina en qué partición/shard se debe colocar la fila, mientras que las columnas de clustering indican cómo se deben organizar los datos dentro del shard actual.
CREATE KEYSPACE myapp;
USE myapp;
CREATE TABLE Music (
    Artist TEXT,
    SongTitle TEXT,
    AlbumTitle TEXT,
    Year INT,
    Price FLOAT,
    Genre TEXT,
    CriticRating FLOAT,
    Tags TEXT,
    PRIMARY KEY(Artist, SongTitle)
);
MongoDB
MongoDB organiza los datos en bases de datos (Database) (análogo a Keyspace en Cassandra), donde hay colecciones (Collections) (análogo a tablas), que contienen documentos (Documents) (análogo a filas en una tabla). En MongoDB, en principio no se requiere la definición de un esquema inicial. El comando "use database", mostrado a continuación, crea una instancia de base de datos en la primera llamada y cambia el contexto para la nueva base de datos creada. Incluso las colecciones no necesitan ser creadas explícitamente, se crean automáticamente simplemente al agregar el primer documento a una nueva colección. Ten en cuenta que MongoDB usa por defecto una base de datos de prueba, por lo que cualquier operación a nivel de colecciones sin especificar una base de datos concreta se ejecutará en ella por defecto.
use myNewDatabase;Obteniendo información sobre la tabla
PostgreSQL
d Music
Tabla "public.music"
    Columna    |         Tipo          | Collation | Nulo | Predeterminado
--------------+-----------------------+-----------+----------+--------
 artista      | carácter variable(20) |           | no nulo |
 título_canción | carácter variable(30) |           | no nulo |
 título_album | carácter variable(25) |           |          |
 año         | entero               |           |          |
 precio      | doble precisión      |           |          |
 género      | carácter variable(10) |           |          |
 crítica     | doble precisión      |           |          |
 etiquetas    | texto                  |           |          |
Índices:
    "music_pkey" CLAVE PRIMARIA, btree (artista, título_canción)
Cassandra
DESCRIBIR TABLA MUSIC;
CREAR TABLA myapp.music (
    artista texto,
    título_canción texto,
    título_album texto,
    año int,
    precio float,
    género texto,
    etiquetas texto,
    CLAVE PRIMARIA (artista, título_canción)
) CON ORDENAMIENTO DE CLUSTER POR (título_canción ASC)
    Y default_time_to_live = 0
    Y transacciones = {'enabled': 'false'};
MongoDB
usar myNewDatabase;
mostrar colecciones;
Inserción de datos en la tabla
PostgreSQL
INSERTAR EN Music
    (Artista, TítuloCanción, TítuloÁlbum,
    Año, Precio, Género, Crítica,
    Etiquetas)
VALORES(
    'No One You Know', 'Call Me Today', 'Somewhat Famous',
    2015, 2.14, 'Country', 7.8,
    '{"Compositores": ["Smith", "Jones", "Davis"],"DuraciónEnSegundos": 214}'
);
INSERTAR EN Music
    (Artista, TítuloCanción, TítuloÁlbum,
    Precio, Género, Crítica)
VALORES(
    'No One You Know', 'My Dog Spot', 'Hey Now',
    1.98, 'Country', 8.4
);
INSERTAR EN Music
    (Artista, TítuloCanción, TítuloÁlbum,
    Precio, Género)
VALORES(
    'The Acme Band', 'Look Out, World', 'The Buck Starts Here',
    0.99, 'Rock'
);
INSERTAR EN Music
    (Artista, TítuloCanción, TítuloÁlbum,
    Precio, Género,
    Etiquetas)
VALORES(
    'The Acme Band', 'Still In Love', 'The Buck Starts Here',
    2.47, 'Rock',
    '{"estacionesDeRadioSonando": ["KHCR", "KBQX", "WTNR", "WJJH"], "fechasDeGira": { "Seattle": "20150625", "Cleveland": "20150630"}, "rotación": Pesada}'
);
Cassandra
En general, la expresión INSERTAR en Cassandra se ve muy similar a la correspondiente en PostgreSQL. Sin embargo, hay una gran diferencia en la semántica. En Cassandra INSERTAR es, de hecho, una operación UPSERT, donde la fila incluye los últimos valores, en caso de que la fila ya exista.
La entrada de datos ocurre de manera similar a PostgreSQL
INSERTARarriba
.
MongoDB
A pesar de que MongoDB es una base de datos NoSQL, similar a Cassandra, su operación de inserción de datos no tiene nada que ver con el comportamiento semántico en Cassandra. En MongoDB no tiene capacidades UPSERT, lo que lo hace similar a PostgreSQL. La adición de datos por defecto sin _id especificado resultará en la adición de un nuevo documento a la colección.
db.music.insert( {
 artista: "No One You Know",
 tituloCancion: "Call Me Today",
 tituloAlbum: "Somewhat Famous",
 año: 2015,
 precio: 2.14,
 género: "Country",
 etiquetas: {
 Compositores: ["Smith", "Jones", "Davis"],
 DuraciónEnSegundos: 214,
 }
 }
 );
 db.music.insert( {
 artista: "No One You Know",
 tituloCancion: "My Dog Spot",
 tituloAlbum: "Hey Now",
 precio: 1.98,
 género: "Country",
 calificacionCritica: 8.4,
 }
 );
 db.music.insert( {
 artista: "The Acme Band",
 tituloCancion: "Look Out, World",
 tituloAlbum: "The Buck Starts Here",
 precio: 0.99,
 género: "Rock",
 }
 );
 db.music.insert( {
 artista: "The Acme Band",
 tituloCancion: "Still In Love",
 tituloAlbum: "The Buck Starts Here",
 precio: 2.47,
 género: "Rock",
 etiquetas: {
 estacionesDeRadioQueLoToquen: ["KHCR", "KBQX", "WTNR", "WJJH"],
 fechasDeGira: {
 Seattle: "20150625",
 Cleveland: "20150630"
 },
 rotación: "Pesada"
 }
 }
 );
Consulta de tabla
Puede que la diferencia más significativa entre SQL y NoSQL en términos de redacción de consultas radique en el uso de formulaciones FROM y WHERE. SQL permite seleccionar múltiples tablas después de la expresión FROM y puede ser de cualquier complejidad (incluyendo operaciones WHERE entre tablas). Sin embargo, NoSQL tiende a imponer una estricta limitación sobre JOIN , y trabaja solo con una tabla especificada, mientras que en FROM. WHERE, siempre debe especificarse la clave primaria. Esto se debe al deseo de mejorar el rendimiento de NoSQL, del que hablamos anteriormente. Este deseo lleva a una reducción de cualquier interacción cruzada entre tablas y claves. Puede resultar en una gran latencia en la comunicación entre nodos al responder a la consulta y, por lo tanto, se debe evitar en principio. Por ejemplo, Cassandra requiere que las consultas estén limitadas a ciertos operadores (solo se permiten =, IN, , =>, <=) en las claves de partición, excepto en el caso de la consulta de índices secundarios (donde solo se permite el operador =).
PostgreSQL
A continuación se presentan tres ejemplos de consultas que fácilmente pueden ser ejecutadas por una base de datos SQL.
- Mostrar todas las canciones del artista;
- Mostrar todas las canciones del artista que coinciden con la primera parte del título;
- Mostrar todas las canciones del artista que tienen una palabra específica en el título y tienen un precio menor a 1.00.
SELECT * FROM Music
WHERE Artist='No One You Know';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle LIKE 'Call%';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle LIKE '%Today%'
AND Price > 1.00;
Cassandra
De las consultas enumeradas anteriormente, solo la primera funcionará en Cassandra sin cambios, ya que el operador LIKE no se puede aplicar a las columnas de clustering como SongTitle. En este caso, solo se permiten los operadores = y IN.
SELECT * FROM Music
WHERE Artist='No One You Know';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle IN ('Call Me Today', 'My Dog Spot')
AND Price > 1.00;
MongoDB
Como se muestra en los ejemplos anteriores, el método principal para crear consultas en MongoDB es . Este método contiene explícitamente el nombre de la colección (música en el ejemplo siguiente), por lo que la consulta en múltiples colecciones está prohibida.
db.music.find( {
  artist: "No One You Know"
 }
);
db.music.find( {
  artist: "No One You Know",
  songTitle: /Call/
 }
);
Leer todas las filas de la tabla
Leer todas las filas es simplemente un caso particular de la plantilla de consulta que discutimos anteriormente.
PostgreSQL
SELECT *
FROM Music;
Cassandra
De manera similar al ejemplo de PostgreSQL anterior.
MongoDB
db.music.find( {} );Editar datos en la tabla
PostgreSQL
PostgreSQL proporciona la instrucción ACTUALIZAR para modificar los datos. No tiene opciones UPSERT, por lo que la ejecución de esta instrucción resultará en un error si no hay filas en la base de datos.
UPDATE Music
SET Genre = 'Disco'
WHERE Artist = 'The Acme Band' AND SongTitle = 'Still In Love';
Cassandra
En Cassandra hay ACTUALIZAR un análogo de PostgreSQL. ACTUALIZAR tiene la misma semántica UPSERT, similar a INSERTAR.
De manera similar al ejemplo de PostgreSQL anterior.
MongoDB
Operación En MongoDB, se puede actualizar un documento existente por completo o solo ciertos campos. Por defecto, solo actualiza un documento con la semántica desactivada. UPSERT. La actualización de múltiples documentos y el comportamiento son análogos. UPSERT Se puede aplicar estableciendo flancos adicionales para la operación. Como en el siguiente ejemplo, se actualiza el género de un intérprete específico según su canción.
db.music.update(
  {"artist": "The Acme Band"},
  {
    $set: {
      "genre": "Disco"
    }
  },
  {"multi": true, "upsert": true}
);
Eliminación de datos de la tabla.
PostgreSQL
DELETE FROM Music
WHERE Artist = 'The Acme Band' AND SongTitle = 'Look Out, World';
Cassandra
De manera similar al ejemplo de PostgreSQL anterior.
MongoDB
En MongoDB hay dos tipos de operaciones para eliminar documentos — y . Ambos tipos eliminan documentos, pero devuelven diferentes resultados.
db.music.deleteMany( {
        artist: "The Acme Band"
    }
);
Eliminación de la tabla.
PostgreSQL
DROP TABLE Music;Cassandra
De manera similar al ejemplo de PostgreSQL anterior.
MongoDB
db.music.drop();Conclusión
La controversia sobre la elección entre SQL y NoSQL ha ardido durante más de 10 años. Hay dos aspectos principales en este debate: la arquitectura del núcleo de la base de datos (SQL monolítico y transaccional frente a NoSQL distribuido y no transaccional) y el enfoque de diseño de la base de datos (modelado de datos en SQL frente a modelado de sus consultas en NoSQL).
Con una base de datos transaccional distribuida, como YugaByte DB, los debates sobre la arquitectura de la base de datos pueden disiparse fácilmente. A medida que los volúmenes de datos se vuelven mayores que lo que puede escribirse en un solo nodo, se vuelve necesario tener una arquitectura completamente distribuida que soporte escalabilidad lineal de escritura con fragmentación automática/rebalanceo.
Además de lo que se menciona en uno de los artículos , las arquitecturas transaccionales y de fuerte consistencia se están aplicando ahora más ampliamente para proporcionar una mejor flexibilidad en el desarrollo que las arquitecturas no transaccionales, que son finalmente consistentes.
Volviendo a la discusión sobre el diseño de bases de datos, es justo decir que ambos enfoques de diseño (SQL y NoSQL) son necesarios para cualquier aplicación real compleja. El enfoque SQL de "modelado de datos" permite a los desarrolladores adaptarse más fácilmente a los cambiantes requisitos comerciales, mientras que el enfoque NoSQL de "modelado de consultas" permite a los mismos desarrolladores manejar grandes volúmenes de datos con baja latencia y alta capacidad de procesamiento. Es por esta razón que YugaByte DB ofrece API SQL y NoSQL en un núcleo común, en lugar de promover uno de los enfoques. Además, al proporcionar compatibilidad con los lenguajes de bases de datos populares, incluyendo PostgreSQL y Cassandra, YugaByte DB garantiza que los desarrolladores no tengan que aprender un nuevo idioma para trabajar con el núcleo de base de datos distribuido y estrictamente consistente.
En este artículo hemos explorado cómo los fundamentos del diseño de bases de datos varían en PostgreSQL, Cassandra y MongoDB. En los siguientes artículos, profundizaremos en conceptos avanzados de diseño, como índices, transacciones, JOINs, directivas TTL y documentos JSON.
Les deseamos que pasen un excelente fin de semana y los invitamos a , que tendrá lugar el 14 de mayo.
Fuente: habr.com
