

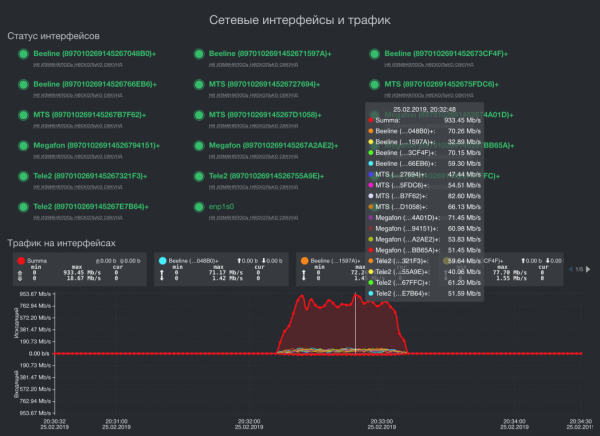
16 módems, 4 operadores móviles = Velocidad de salida 933.45 Mbit/s
Introducción
¡Hola! Este es un artículo sobre cómo escribimos un nuevo sistema de monitoreo para nosotros. Se diferencia de los existentes por su capacidad de obtener métricas de manera sincrónica a alta frecuencia y por su bajo consumo de recursos. La frecuencia de sondeo puede alcanzar 0.1 milisegundos con una precisión de sincronización entre métricas de 10 nanosegundos. Todos los archivos binarios ocupan 6 megabytes.
Sobre el proyecto
Tenemos un producto bastante específico. Producimos una solución integral para la suma de capacidad y redundancia de canales de transmisión de datos. Esto es cuando hay varios canales, por ejemplo Operador1 (40 Mbit/s) + Operador2 (30 Mbit/s) + Algo más (5 Mbit/s), resultando en un canal estable y rápido cuya velocidad sería aproximadamente así: (40+30+5)x0.92=75×0.92=69 Mbit/s.
Estas soluciones son demandadas donde la capacidad de un solo canal no es suficiente. Por ejemplo, en transporte, sistemas de videovigilancia y transmisión de video en tiempo real, transmisión de emisiones de televisión y radio en vivo, en cualquier propiedad rural donde los operadores de telecomunicaciones sean solo representantes de los grandes cuatro y la velocidad en un módem/canal no es suficiente.
Para cada una de estas áreas, lanzamos una línea separada de dispositivos, sin embargo, su parte de software es casi la misma y un sistema de monitoreo de calidad es uno de sus principales módulos, sin cuya implementación adecuada el producto no sería posible.
En varios años, hemos logrado crear un sistema de monitoreo rápido, multiplataforma y ligero. Es lo que queremos compartir con la respetada comunidad.
Planteamiento del problema
El sistema de monitoreo garantiza la recepción de métricas de dos clases fundamentalmente diferentes: métricas en tiempo real y todas las demás. Se establecieron los siguientes requisitos para el sistema de monitoreo:
- Recepción sincrónica de alta frecuencia de métricas en tiempo real y su transmisión al sistema de gestión de comunicación sin retrasos.
Una alta frecuencia y la sincronización de diferentes métricas no solo son importantes, son vitales para el análisis de la entropía en los canales de transmisión de datos. Si en un canal de transmisión de datos la latencia media es de 30 milisegundos, un error de sincronización de solo un milisegundo entre las demás métricas conducirá a una degradación de la velocidad del canal resultante de aproximadamente el 5%. Si cometemos un error de sincronización de 1 milisegundo en 4 canales, la degradación de la velocidad podría caer fácilmente hasta el 30%. Además, la entropía en los canales cambia muy rápido, por lo que si la medimos con menos frecuencia que una vez cada 0.5 milisegundos, en canales rápidos con baja latencia, obtendremos una alta degradación de la velocidad. Por supuesto, tal precisión no se necesita para todas las métricas y no en todas las condiciones. Cuando la latencia en el canal sea de 500 milisegundos, y trabajamos con tales, un error de 1 milisegundo casi no será perceptible. Asimismo, para las métricas de los sistemas de soporte vital, nos basta con una frecuencia de sondeo y sincronización de 2 segundos; sin embargo, el propio sistema de monitoreo debe ser capaz de trabajar con frecuencias de sondeo extremadamente altas y una sincronización de métricas muy precisa. - Mínimo consumo de recursos y una pila unificada.
El dispositivo final puede ser tanto un potente complejo a bordo que puede analizar la situación en la carretera o realizar la toma biométrica de personas, como un ordenador de una sola placa del tamaño de la palma de la mano que el soldado de un escuadrón de élite lleva bajo un chaleco antibalas para transmitir vídeo en tiempo real en condiciones de mala conexión. A pesar de la diversidad de arquitecturas y potencias de cálculo, nos gustaría tener una pila de software uniforme. - Arquitectura de paraguas
Las métricas deben ser recopiladas y agregadas en el dispositivo final, tener un sistema local de almacenamiento y visualización en tiempo real y retrospectiva. En caso de haber conexión, los datos deben ser enviados al sistema central de monitoreo. Cuando no hay conexión, la cola de envío debe acumularse y no consumir memoria operativa. - API para la integración en el sistema de monitoreo del cliente, porque nadie necesita muchos sistemas de monitoreo. El cliente debe recopilar datos de cualquier dispositivo y red en un solo monitoreo.
¿Qué resultados se obtuvieron?
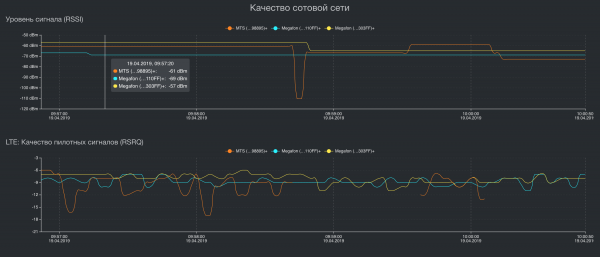
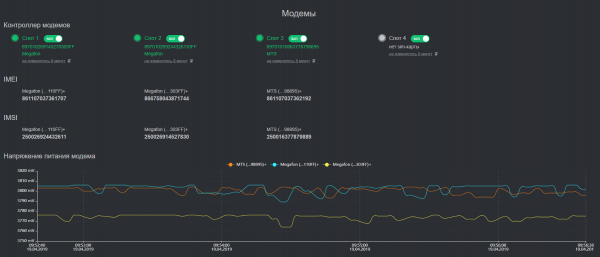
Para no cargar aún más este extenso artículo, no proporcionaré ejemplos y medidas de todos los sistemas de monitoreo. Eso requeriría otro artículo. Solo diré que no hemos podido encontrar un sistema de monitoreo que pueda capturar dos métricas simultáneamente con una desviación de menos de 1 milisegundo y que funcione de manera igualmente efectiva en arquitectura ARM con 64 MB de RAM y en arquitectura x86_64 con 32 GB de RAM. Por lo tanto, decidimos crear el nuestro, que puede hacer todo eso. Esto es lo que logramos:
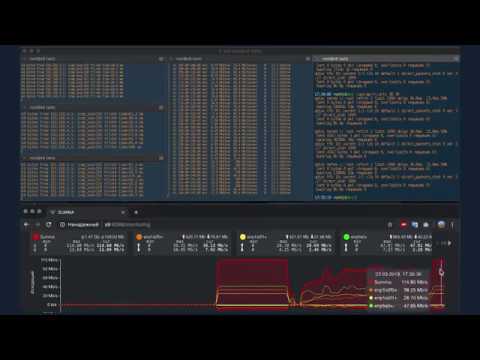
Suma de la capacidad de tres canales para diferentes topologías de red
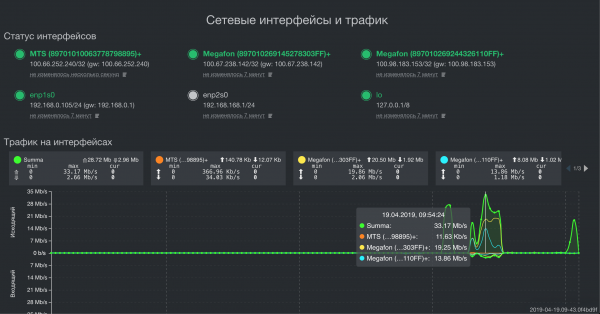
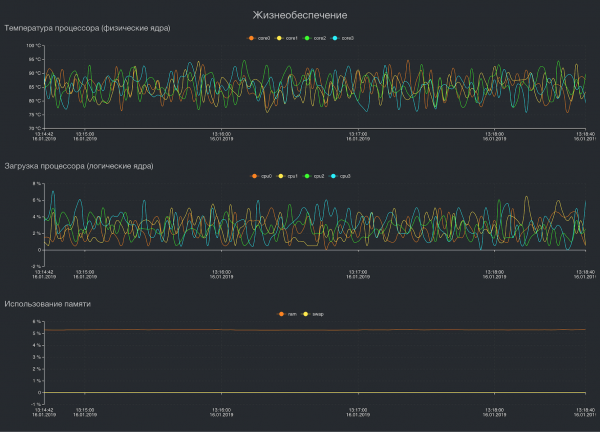
Visualización de algunas métricas clave
Arquitectura
Como lenguaje de programación principal, tanto en el dispositivo como en el centro de datos, utilizamos Golang. Ha facilitado en gran medida nuestra vida con su implementación de concurrencia y la posibilidad de obtener un único binario estáticamente vinculado para cada servicio. Como resultado, ahorramos significativamente en recursos, métodos y tráfico de despliegue del servicio en dispositivos finales, así como en el tiempo de desarrollo y depuración del código.
El sistema se implementa siguiendo el principio modular clásico y contiene varios subsistemas:
- Registro de métricas.
Cada métrica es gestionada por su propio hilo y se sincroniza a través de canales. Hemos logrado una precisión de sincronización de hasta 10 nanosegundos. - Almacenamiento de métricas
Estuvimos eligiendo entre escribir nuestro propio almacenamiento para series temporales o usar algo disponible. La base de datos se necesita para datos retrospectivos que serán posteriormente visualizados. Es decir, no hay datos sobre las latencias en el canal cada 0.5 milisegundos o lecturas de errores en la red de transporte, pero hay velocidad en cada interfaz cada 500 milisegundos. Además de los altos requisitos de multiplataforma y bajo consumo de recursos, es crucial para nosotros poder procesar los datos donde se almacenan. Esto ahorra enormes recursos computacionales. Desde 2016, utilizamos la base de datos Tarantool en este proyecto y, por el momento, no vemos sustituto en el horizonte. Es flexible, con un consumo de recursos óptimo y un soporte técnico más que adecuado. También en Tarantool se implementó un módulo GIS. No es tan poderoso como PostGIS, pero es suficiente para nuestras necesidades de almacenamiento de algunas métricas relacionadas con la ubicación (relevante para el transporte). - Visualización de métricas
Aquí todo es relativamente sencillo. Tomamos los datos del almacenamiento y los mostramos ya sea en tiempo real o de manera retrospectiva. - Sincronización de datos con el sistema central de monitoreo.
El sistema central de monitoreo recibe datos de todos los dispositivos, los almacena con la retrospectiva designada y a través de API los entrega al sistema de monitoreo del Cliente. A diferencia de los sistemas de monitoreo clásicos, donde la 'cabeza' va y recopila datos, aquí tenemos un esquema inverso. Los dispositivos envían datos ellos mismos cuando hay conexión. Este es un punto muy importante, ya que permite obtener datos del dispositivo durante los períodos en los que no está disponible y no sobrecargar canales y recursos cuando el dispositivo no está accesible. Como sistema central de monitoreo utilizamos el servidor de monitoreo Influx. A diferencia de otros, puede importar datos retrospectivos (es decir, con una marca de tiempo diferente al momento de recibir la métrica). Las métricas recopiladas son visualizadas por una versión modificada de Grafana. Este stack estándar fue elegido también porque tiene API de integración listas para prácticamente cualquier sistema de monitoreo del cliente. - Sincronización de datos con el sistema central de gestión de dispositivos.
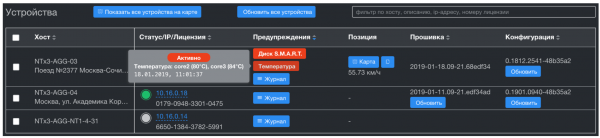
El sistema de gestión de dispositivos implementa Zero Touch Provisioning (actualización de firmware, configuración, etc.) y, a diferencia del sistema de monitoreo, recibe únicamente problemas de los dispositivos. Estos son los disparadores para el funcionamiento de los servicios de vigilancia de hardware a bordo y todas las métricas de los sistemas de soporte vital: temperatura de CPU y SSD, carga de CPU, espacio libre y salud S.M.A.R.T de los discos. El almacenamiento de la subsistema también está construido sobre Tarantool. Esto nos proporciona una velocidad significativa en la agregación de series temporales de miles de dispositivos, así como resuelve completamente el tema de la sincronización de datos con estos dispositivos. Tarantool tiene un excelente sistema de colas y entrega garantizada. ¡Esta importante característica la obtenemos de manera predeterminada, genial!
Sistema de gestión de red
¿Qué sigue?
Por ahora, el eslabón más débil es nuestro sistema central de monitoreo. Está implementado en un 99.9% en la pila estándar y tiene una serie de desventajas:
- InfluxDB pierde datos al cortarse la energía. Por lo general, el Cliente recoge rápidamente todo lo que reciben los dispositivos y en la propia base de datos no hay datos mayores a 5 minutos, sin embargo, en el futuro esto puede convertirse en un problema.
- Grafana tiene varios problemas con la agregación de datos y la sincronización de su visualización. El problema más común es cuando en la base hay una serie temporal con un intervalo de 2 segundos comenzando, digamos, a las 00:00:00, y Grafana comienza a mostrar los datos en la agregación con +1 segundo. Como resultado, el usuario ve un gráfico inestable.
- Exceso de código para la integración API con sistemas de monitoreo externos. Se podría hacer mucho más compacto y, por supuesto, reescribirlo en Go)
Supongo que todos ustedes han visto cómo se ve Grafana y conocen sus problemas sin que yo lo mencione, así que no sobrecargaré la publicación con imágenes.
Conclusión
He decidido no describir los detalles técnicos y solo he esbozado el diseño base de este sistema. En primer lugar, para describir técnicamente el sistema se requeriría otro artículo. En segundo lugar, no a todos les interesará esto. Escriban en los comentarios qué detalles técnicos les gustaría saber.
Si alguien tiene preguntas más allá de este artículo, puede escribirme a a.rodin @ qedr.com
Fuente: habr.com
