

El 29 de enero, el comité técnico de la organización CNCF (Cloud Native Computing Foundation), responsable de Kubernetes, Prometheus y otros productos Open Source del mundo de los contenedores y cloud native, aprobó el proyecto Rook para sus filas. Una gran oportunidad para conocer más de cerca a este «orquestador de sistemas de almacenamiento distribuido en Kubernetes».
¿Qué es Rook?
— es un software escrito en Go ( bajo la licencia libre Apache License 2.0), destinado a dotar a los sistemas de almacenamiento de funciones automatizadas que los hacen autogestionados, escalables y auto-reparables.Para ello, Rook automatiza (para los sistemas de almacenamiento utilizados en el entorno de Kubernetes): implementación, bootstrap, configuración, aprovisionamiento, escalado, actualizaciones, migraciones, recuperación ante fallos, monitoreo y gestión de recursos.
El proyecto está en fase alfa y se especializa en la orquestación del sistema de almacenamiento distribuido Ceph en clústeres de Kubernetes. Los autores también han declarado su intención de soportar otros sistemas de almacenamiento, pero esto no sucederá en las próximas versiones.
Componentes y estructura técnica
En el núcleo del funcionamiento de Rook dentro de Kubernetes hay un operador especial (hemos escrito más sobre Kubernetes Operators en ), que automatiza la configuración del almacenamiento y realiza su monitoreo.
Así que, El operador Rook se presenta como un contenedor que contiene todo lo necesario para implementar y posteriormente mantener el almacenamiento. Entre las responsabilidades del operador están:
- la creación de DaemonSets para los demonios de almacenamiento Ceph () con un clúster sencillo de RADOS;
- la creación de pods para el monitoreo de Ceph (con , que verifican el estado del clúster; para establecer un quórum, en la mayoría de los casos se implementan tres instancias, y al fallar cualquiera de ellas, se levanta una nueva);
- la gestión de CRDs () para el propio , , (conjuntos de recursos y servicios para manejar solicitudes HTTP, ejecutando PUT/GET para objetos, que son compatibles con S3 y Swift API), así como ;
- la inicialización de pods para activar todos los servicios necesarios;
- la creación de agentes Rook.
Los agentes Rook se presentan como pods independientes, que se implementan en cada nodo de Kubernetes. La finalidad del agente es la configuración del plugin , que proporciona soporte para volúmenes de almacenamiento en Kubernetes. El agente implementa la explotación del almacenamiento: conecta dispositivos de almacenamiento en red, monta volúmenes, formatea el sistema de archivos, etc.
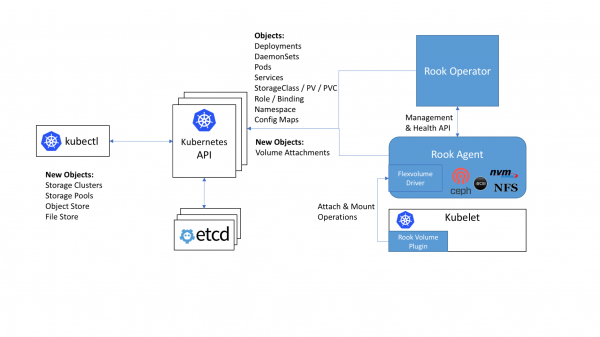
Lugar y función de los componentes Rook en el esquema general del clúster de Kubernetes
Rook ofrece tres tipos de almacenamiento:
- (Block,
StorageClass) — monta el almacenamiento a un único pod; - (Object,
ObjectStore) — accesible dentro y fuera del clúster de Kubernetes (a través de la API S3); - (Shared File System,
Sistema de archivos) — sistema de archivos que se puede montar para lectura y escritura desde múltiples pods.
El dispositivo interno de Rook incluye:
- Mons — pods para monitoreo de Ceph (con los ya mencionados ceph-mon);
- OSDs — pods con demonios ceph-osd (Object Storage Daemons);
- MGR — pods con el demonio (Ceph Manager), que proporciona capacidades adicionales de monitorización e interfaces para sistemas externos (de monitoreo/gestión);
- RGW (opcional) — pods con almacenamiento de objetos;
- MDS (opcional) — pods con sistema de archivos compartido.
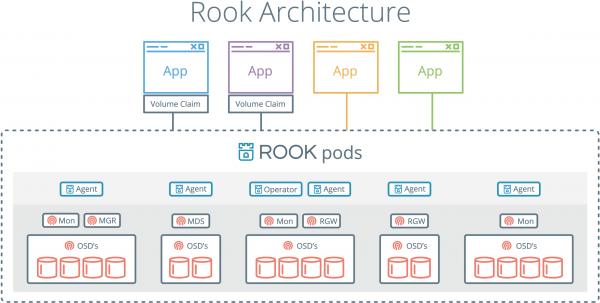
Todos los demonios de Rook (Mons, OSDs, MGR, RGW, MDS) están compilados en un único binario (rook), que se ejecuta en un contenedor.
Para una breve presentación del proyecto Rook, también puede ser útil este pequeño (12 diapositivas) de Bassam Tabbara (CTO en Quantum Corp).
Explotación de Rook
El operador Rook soporta completamente Kubernetes versión 1.6 y superior (y, parcialmente, el lanzamiento más antiguo de K8s — 1.5.2). Su instalación en se ve así:
cd cluster/examples/kubernetes
kubectl create -f rook-operator.yaml
kubectl create -f rook-cluster.yaml
Además, para el operador Rook hay preparado , lo que permite que la instalación también se realice de esta manera:
helm repo add rook-alpha https://charts.rook.io/alpha
helm install rook-alpha/rook
Hay una pequeña cantidad de (por ejemplo, se puede desactivar el soporte , si esta posibilidad no se utiliza en su clúster), que se pasan en helm install a través del parámetro --set key=value[,key=value] (o almacenarlo en un archivo YAML separado y pasarlo a través de -f values.yaml).
Después de instalar el operador Rook y ejecutar pods con sus agentes, queda por crear el propio clúster Rook, cuya configuración más sencilla se ve como sigue (rook-cluster.yaml):
apiVersion: v1
kind: Namespace
metadata:
  name: rook
---
apiVersion: rook.io/v1alpha1
kind: Cluster
metadata:
  name: rook
  namespace: rook
spec:
  dataDirHostPath: /var/lib/rook
  storage:
    useAllNodes: true
    useAllDevices: false
    storeConfig:
      storeType: bluestore
      databaseSizeMB: 1024
journalSizeMB: 1024Nota: se debe prestar especial atención al atributo dataDirHostPath, cuyo valor correcto es necesario para mantener el clúster después de reinicios. Para los casos de uso como un lugar de almacenamiento permanente de datos, los autores de Rook en los hosts de Kubernetes recomiendan tener al menos 5 GB de espacio libre en disco en este directorio.
Queda por crear el clúster a partir de la configuración y asegurarse de que los pods se hayan creado en el clúster (en el espacio de nombres rook):
kubectl create -f rook-cluster.yaml
kubectl -n rook get pod
NAME                              READY     STATUS    RESTARTS   AGE
rook-api-1511082791-7qs0m         1/1       Running   0          5m
rook-ceph-mgr0-1279756402-wc4vt   1/1       Running   0          5m
rook-ceph-mon0-jflt5              1/1       Running   0          6m
rook-ceph-mon1-wkc8p              1/1       Running   0          6m
rook-ceph-mon2-p31dj              1/1       Running   0          6m
rook-ceph-osd-0h6nb               1/1       Running   0          5m
Upgrade la actualización del clúster Rook (hasta la nueva versión) es un procedimiento que en esta etapa requiere la actualización secuencial de todos sus componentes en un orden específico, y solo se puede comenzar una vez que usted se asegure de que la instalación actual de Rook esté en un estado completamente 'saludable'. Se puede encontrar una guía detallada paso a paso sobre la actualización de Rook de la versión 0.5.0 a la 0.5.1 en .
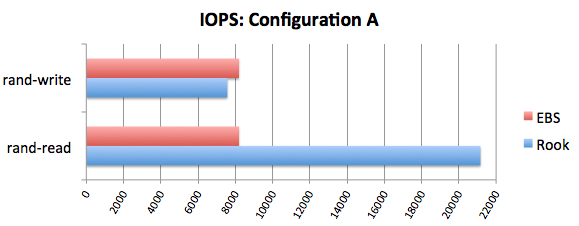
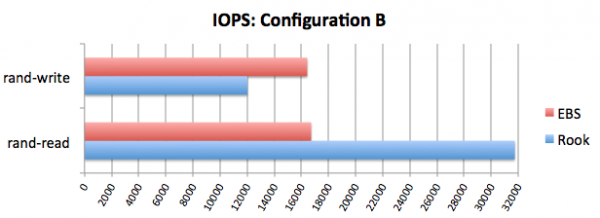
En noviembre del año pasado, en el blog de Rook comparación rendimiento con EBS. Sus resultados son dignos de atención, y resumiendo, son los siguientes:
Perspectivas
El estado actual de Rook es alpha, y la última gran versión hasta la fecha es , lanzada en noviembre de 2017 (corrección actual — — se lanzó el 14 de diciembre). Ya en la primera mitad de 2018 se esperan lanzamientos de versiones más maduras: betas y una estable (oficialmente lista para producción).
Según del proyecto, los desarrolladores tienen una visión detallada para el desarrollo de Rook al menos en los dos próximos lanzamientos: 0.7 (su preparación en el rastreador de GitHub como 60 %) y 0.8. Entre los cambios esperados se incluyen la transición del soporte de Ceph Block y Ceph Object a estado beta, la provisión dinámica de volúmenes para CephFS, un sistema de registro mejorado, actualizaciones automatizadas del clúster, soporte para instantáneas de volúmenes.
La inclusión de Rook en la lista (por ahora en la etapa más temprana — 'inception-level', — al mismo nivel que y ) actúa como una especie de garantía del creciente interés por el producto. Cuánto se consolidará en el mundo de las aplicaciones en la nube se podrá entender mejor tras la aparición de versiones estables, que sin duda traerán a Rook nuevos «evaluadores» y usuarios.
P.D.
También puedes leer en nuestro blog:
- «»;
- «»;
- «»;
- «»;
- «».
Fuente: habr.com
