

Como en , surgió un problema con el servicio distribuido, llamémoslo Elvin. Esta vez no fui yo quien detectó el problema; me lo comunicaron los chicos del lado del cliente.
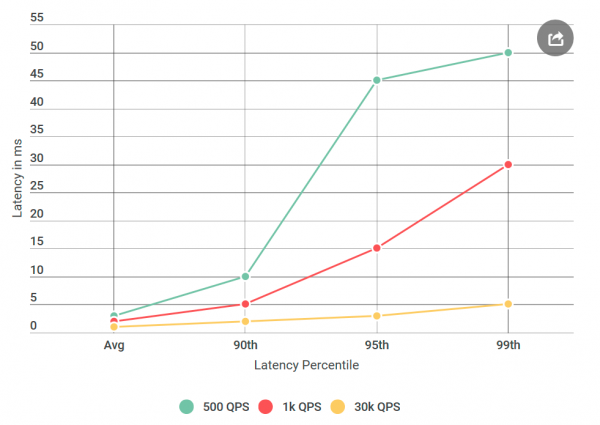
Una vez, me desperté de un correo descontento debido a grandes retrasos con Elvin, el cual planeábamos lanzar en breve. En particular, el cliente experimentó un retraso en el percentil 99 de alrededor de 50 ms, mucho más alto que nuestro presupuesto de latencia. Fue sorprendente, ya que había probado el servicio minuciosamente, especialmente en términos de latencia, un tema que suele generar muchas quejas.
Antes de pasar Elvin a las pruebas, realicé muchos experimentos con 40 mil solicitudes por segundo (QPS), todos mostraron una latencia de menos de 10 ms. Estaba dispuesto a afirmar que no estaba de acuerdo con sus resultados. Pero al mirar nuevamente el correo, noté algo nuevo: no había probado precisamente las condiciones que mencionaron, su QPS era mucho más bajo que el mío. Yo había probado con 40k QPS, y ellos solo con 1k. Realicé otro experimento, esta vez con un QPS más bajo, solo para satisfacerlos.
Dado que estoy escribiendo esto en el blog, probablemente ya lo has adivinado: sus cifras resultaron ser correctas. Revisé mi cliente virtual una y otra vez, obteniendo siempre el mismo resultado: un bajo número de solicitudes no solo aumentaba la latencia, sino que también incrementaba el número de solicitudes con latencia superior a 10 ms. En otras palabras, con 40k QPS, alrededor de 50 solicitudes por segundo superaban los 50 ms, mientras que con 1k QPS había 100 solicitudes cada segundo por encima de los 50 ms. ¡Paradoja!
Acotando la búsqueda
Al enfrentar un problema de latencia en un sistema distribuido con muchos componentes, lo primero que hay que hacer es elaborar una lista corta de sospechosos. Profundicemos un poco más en la arquitectura de Elvin:
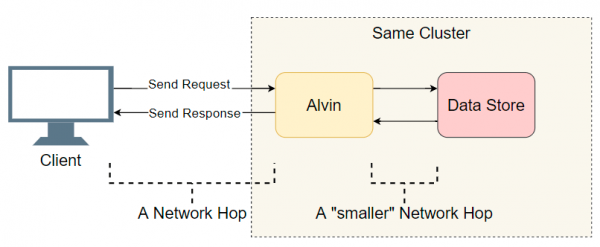
Un buen punto de partida es una lista de las transiciones de entrada/salida realizadas (llamadas de red/búsquedas en disco, etc.). Intentemos descubrir dónde está la latencia. Además del obvio E/S con el cliente, Elvin hace un paso adicional: se comunica con el almacenamiento de datos. Sin embargo, este almacenamiento opera en el mismo clúster que Elvin, por lo que la latencia allí debería ser menor que con el cliente. Así que, la lista de sospechosos es:
- Llamada de red del cliente a Elvin.
- Llamada de red de Elvin al almacenamiento de datos.
- Búsqueda en disco en el almacenamiento de datos.
- Llamada de red desde el almacenamiento de datos a Elvin.
- Llamada de red de Elvin al cliente.
Intentemos eliminar algunos puntos.
El almacenamiento de datos no tiene nada que ver.
Primero convertí a Elvin en un servidor ping-ping, que no procesa solicitudes. Al recibir una solicitud, devuelve una respuesta vacía. Si la latencia disminuye, hay un error en la implementación de Elvin o en el almacenamiento de datos—nada extraordinario. En el primer experimento, obtenemos este gráfico:
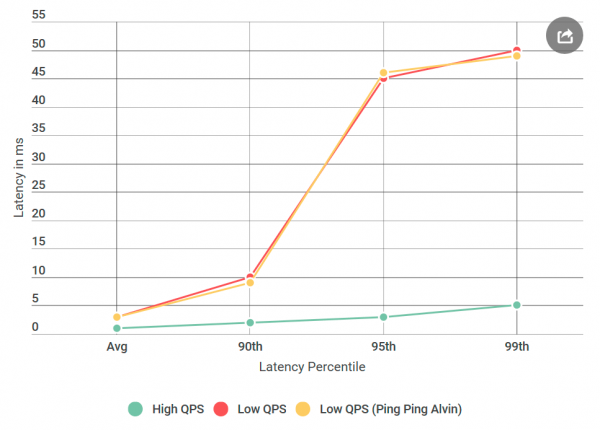
Como podemos ver, al usar el servidor ping-ping no hay mejoras observables. Esto significa que el almacenamiento de datos no aumenta la latencia, y la lista de sospechosos se reduce a la mitad:
- Llamada de red del cliente a Elvin.
- Llamada de red de Elvin al cliente.
¡Genial! La lista se está reduciendo rápidamente. Pensé que casi había averiguado la causa.
gRPC
Es hora de presentarles un nuevo jugador: . Esta es una biblioteca de código abierto de Google para comunicación intraproceso. . Aunque gRPC está bien optimizada y es ampliamente utilizada, es la primera vez que la utilizo en un sistema de tal escala, y esperaba que mi implementación fuera subóptima—por decirlo de alguna forma.
La existencia gRPC en la pila planteó una nueva pregunta: ¿podría ser mi implementación o el propio gRPC causa el problema de latencia? Añadimos un nuevo sospechoso a la lista:
- El cliente llama a la biblioteca
gRPC - La biblioteca
gRPCen el cliente ejecuta una llamada de red de la bibliotecagRPCen el servidor - La biblioteca
gRPCse comunica con Elvin (sin operaciones en el caso del servidor ping-pong)
Para que entiendan cómo es el código, mi implementación del cliente/Elvin no se desvía mucho de los ejemplos de cliente-servidor .
Nota: la lista anterior está un poco simplificada, ya que
gRPCpermite el uso de un modelo de flujo propio (¿plantilla?) en el que se entrelazan la pila de ejecucióngRPCy la implementación del usuario. Por simplicidad, nos mantendremos en este modelo.
El perfilado lo resolverá todo.
Después de descartar el almacenamiento de datos, pensé que casi había terminado: «¡Ahora es fácil! Aplicaremos el perfil y descubriremos dónde ocurre la latencia». Soy porque el CPU es muy rápido y a menudo no es el cuello de botella. La mayoría de las latencias ocurren cuando el procesador debe detener el procesamiento para hacer algo más. El perfilado preciso del CPU está diseñado precisamente para esto: registra de manera exacta todos los y proporciona información sobre dónde ocurren las latencias.
Tomé cuatro perfiles: para un alto QPS (baja latencia) y con un servidor de ping-pong en bajo QPS (alta latencia), tanto del lado del cliente como del servidor. Y por si acaso, también tomé una muestra del perfil del procesador. Al comparar los perfiles, generalmente busco una pila de llamadas anómala. Por ejemplo, del lado malo con alta latencia, hay muchas más conmutaciones de contexto (10 veces más o más). Pero en mi caso, la cantidad de conmutaciones de contexto coincidía prácticamente. Para mi horror, no había nada significativo allí.
Depuración adicional
Estaba desesperado. No sabía qué otras herramientas utilizar, y mi siguiente plan consistía esencialmente en repetir experimentos con diferentes variaciones, en lugar de diagnosticar claramente el problema.
Qué pasaría si
Desde el principio, me preocupaba un tiempo de latencia específico de 50 ms. Es un tiempo muy alto. Decidí que iría cortando trozos de código hasta que pudiera averiguar exactamente qué parte estaba causando este error. Luego siguió un experimento que funcionó.
Como suele suceder, a posteriori parece que todo era obvio. Coloqué al cliente en una máquina con Elvin y envié una solicitud a localhost. ¡Y la latencia aumentada desapareció!
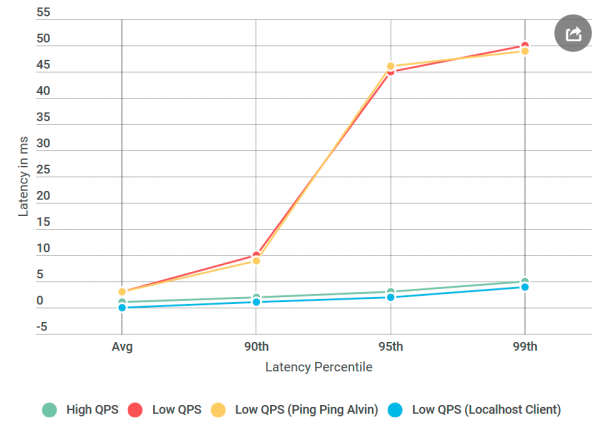
Algo estaba mal en la red.
Desarrollando habilidades de ingeniero de redes
Debo confesar: mis conocimientos de tecnologías de red son terribles, especialmente considerando que trabajo con ellas a diario. Pero la red era el principal sospechoso, y necesitaba aprender cómo depurarla.
Afortunadamente, internet ama a quienes quieren aprender. La combinación de ping y tracert parecía un buen comienzo para depurar problemas de transporte de red.
Primero, ejecuté en el puerto TCP de Elvin. Usé los parámetros predeterminados, nada especial. De más de mil pings, ninguno excedió los 10 ms, excepto el primero para calentar. Esto contradice el aumento de latencia observado de 50 ms en el percentil 99: allí, por cada 100 solicitudes, deberíamos haber visto alrededor de una solicitud con una latencia de 50 ms.
Luego probé : tal vez el problema esté en uno de los nodos en la ruta entre Elvin y el cliente. Pero el tracer también volvió con las manos vacías.
Por lo tanto, la causa de la latencia no era mi código, ni la implementación de gRPC, ni la red. Ya comenzaba a preocuparme de que nunca lo entendería.
Ahora, ¿en qué sistema operativo estamos?
gRPC se utiliza ampliamente en Linux, pero para Windows es exótico. Decidí realizar un experimento que funcionó: creé una máquina virtual Linux, compilé Alvin para Linux y la implementé.
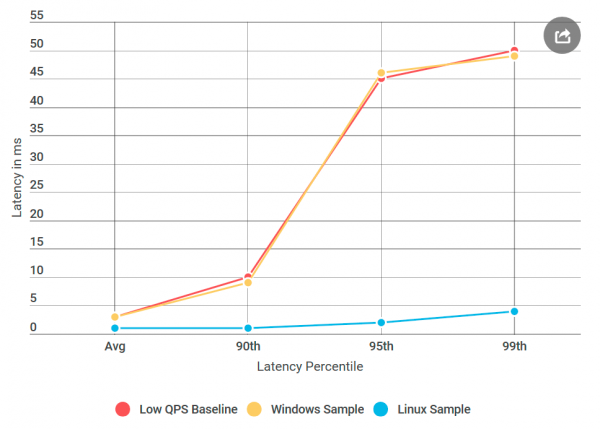
Y esto es lo que resultó: en el servidor ping-pong de Linux no había tales latencias como en el nodo equivalente de Windows, aunque la fuente de datos no difería. Resulta que el problema está en la implementación de gRPC para Windows.
El algoritmo de Nagle
Durante todo este tiempo pensé que me faltaba una bandera gRPC. Ahora entendí que en realidad es la gRPC falta de una bandera de Windows. Encontré una biblioteca interna de RPC, en la que estaba seguro de que funcionaría bien para todas las banderas establecidas . Luego añadí todas estas banderas a gRPC y desplegué Alvin en Windows, en el servidor ping-pong corregido para Windows!
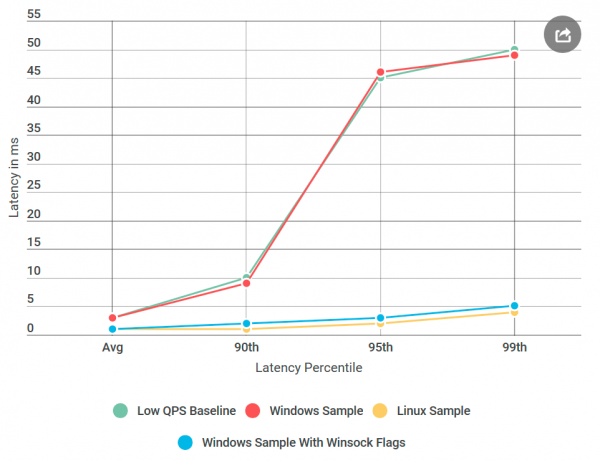
Casi listo: empecé a eliminar las banderas añadidas una por una, hasta que regresó la regresión, así que pude determinar con precisión su causa. Era el infame , un conmutador del algoritmo de Nagle.
intenta reducir la cantidad de paquetes enviados por la red, retrasando el envío de mensajes hasta que el tamaño del paquete supere cierta cantidad de bytes. Aunque esto puede ser agradable para el usuario promedio, es destructivo para los servidores en tiempo real, ya que el sistema operativo retrasará algunos mensajes, causando latencias en un bajo QPS. El gRPC este flag estaba habilitado en la implementación de Linux para sockets TCP, pero no para Windows. Yo lo .
Conclusión
Grandes latencias en un bajo QPS fueron causadas por la optimización del sistema operativo. Mirando hacia atrás, el perfilado no detectó la latencia porque se realizó en modo núcleo, no en . No sé si se puede observar el algoritmo de Nagle a través de capturas de ETW, pero sería interesante.
En cuanto al experimento localhost, probablemente no se trató del código de red real, y el algoritmo de Nagle no se activó, así que los problemas de latencia desaparecieron cuando el cliente se dirigió a Alvin a través de localhost.
¡La próxima vez que veas un aumento en la latencia al reducir la cantidad de solicitudes por segundo, el algoritmo de Nagle debería estar en tu lista de sospechosos!
Fuente: habr.com
