

La definición de DevOps es muy compleja, por lo que cada vez es necesario iniciar la discusión sobre el tema desde cero. Solo en Habr hay mil publicaciones al respecto. Pero si estás leyendo esto, seguramente sabes qué es DevOps. Porque yo no lo sé. Hola, me llamo Alexander Titov (@), y simplemente hablaremos sobre DevOps y compartiré mi experiencia.
He estado pensando mucho en cómo hacer que mi relato sea útil, por lo que aquí habrá muchas preguntas: aquellas que yo mismo me hago y las que pregunto a los clientes de nuestra empresa. Al responder estas preguntas, la comprensión mejora. Te contaré por qué DevOps es necesario desde mi perspectiva, qué es, nuevamente desde mi posición, y cómo entender que te estás moviendo hacia DevOps, de nuevo desde mi punto de vista. El último punto será a través de preguntas. Al responderlas a ti mismo, podrás entender si tu empresa se está moviendo hacia DevOps o si hay problemas.
Durante un tiempo, navegué en las aguas de fusiones y adquisiciones. Primero trabajé en una pequeña startup llamada Qik, luego fue comprada por una empresa un poco más grande, Skype, que a su vez fue adquirida por una empresa aún más grande, Microsoft. En ese momento, me di cuenta de cómo se transforma la percepción de DevOps en diferentes empresas según su tamaño. Después de eso, me interesó observar DevOps desde la perspectiva del mercado, y con mis colegas organizamos la empresa Expres 42. Ya llevamos 6 años navegando en este mercado.
Además de todo, soy uno de los organizadores de la comunidad DevOps Moscow y organizador de DevOps-Days 2017, pero no organicé el 2018. Expres 42 trabaja con muchas empresas. Estamos promoviendo DevOps allí, observando cómo ocurre, sacando conclusiones, analizando, compartiendo nuestros hallazgos con todos, y formando a las personas en prácticas de DevOps. En resumen, cultivamos la experiencia y la experticia en este sentido.
¿Por qué DevOps?
La primera pregunta que persigue a todos y siempre es: ¿por qué? Muchos piensan que DevOps es solo automatización o algo similar que ya estaba en cada empresa.
— Teníamos Integración Continua — eso significa que ya teníamos DevOps, ¿y para qué necesitamos todo este asunto? Allí afuera se divierten, ¡y aquí nos impiden trabajar!
Después de 9 años de desarrollo de la comunidad y la metodología, ya está claro que no son solo destellos de marketing, pero aún no está del todo claro por qué es necesario. Como cualquier herramienta y proceso, DevOps tiene objetivos concretos que finalmente resuelve.
Todo esto está relacionado con el hecho de que el mundo está cambiando. Se aleja del enfoque empresarial, donde las compañías avanzan directamente hacia su sueño, como cantaba nuestro clásico de San Petersburgo, del punto A al punto B siguiendo una estrategia definida, con una estructura específica construida para eso.
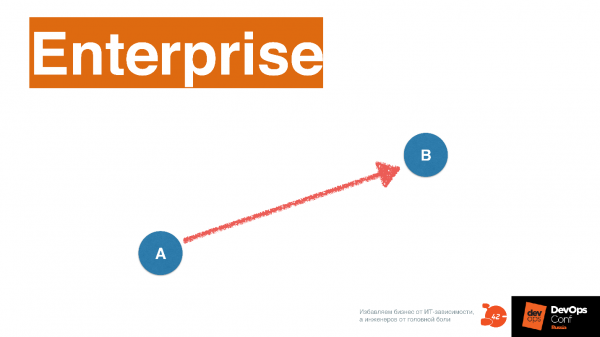
En principio, todo en TI debería construirse bajo este enfoque. Aquí, la TI se utiliza exclusivamente para la automatización de procesos.
La automatización no cambia a menudo porque cuando una empresa sigue un camino ya trazado, ¿qué hay que cambiar? Si funciona, ¡no lo toques! Actualmente, en el mundo los enfoques están cambiando, y el que se llama Agile dice que el punto final B no se ve de inmediato.
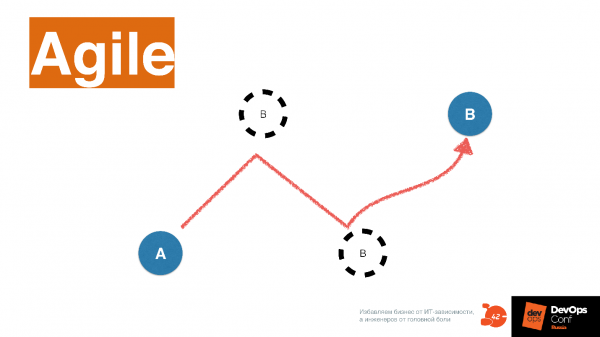
Cuando una empresa navega en el mercado, trabaja con el cliente, constantemente investiga el mercado y cambia su punto final B. Además, cuanto más a menudo una empresa cambia su dirección, más éxito tiene al elegir más nichos de mercado.
Una estrategia es demostrada por una empresa interesante de la que me enteré recientemente. One Box Shave es un servicio de entrega de maquinillas de afeitar y productos de afeitado por suscripción en una caja. Pueden personalizar su 'cajita' para diferentes clientes. Esto se maneja mediante un software específico que luego envía el pedido a una fábrica en Corea que produce el producto.
Este producto fue adquirido por la empresa Unilever por 1 mil millones de dólares. Ahora compite con Gillette y ha robado una parte significativa de su base de consumidores en el mercado estadounidense. One Box Shave dice:
— ¿4 hojas? ¿En serio? ¿Para qué las necesitas? Esto no mejora en nada la calidad del afeitado. Una crema bien seleccionada, una fragancia y una maquinilla de afeitar de calidad con dos hojas resuelven muchos más problemas que esas tontas 4 hojas de Gillette. ¿Pronto llegarán a 10?
Así es como el mundo cambia. Unilever afirma que tienen un excelente sistema de TI que permite hacer esto. Al final, esto se presenta como un concepto Time-to-market, del que ya no ha hablado nadie.
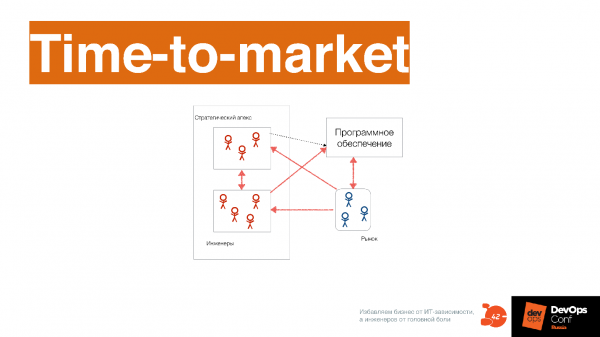
El sentido de Time-to-market no reside en cuán a menudo hacemos despliegues. Se puede desplegar con frecuencia, pero los ciclos de lanzamiento pueden ser largos. Si se superponen ciclos de lanzamiento de tres meses, desplazándolos una semana, parece que la empresa se despliega una vez a la semana. Sin embargo, desde la idea hasta la implementación final pasan 3 meses.
Time-to-market se trata de minimizar el tiempo desde la idea hasta la implementación final.
En este caso, el software interactúa con el mercado. Así, en One Box Shave, el sitio web interactúa con el cliente. No tienen vendedores, solo un sitio donde el visitante hace clic y deja sus deseos. Por lo tanto, es necesario actualizar constantemente el sitio, añadiendo novedades de acuerdo a estos deseos. Por ejemplo, en Corea del Sur se afeitan de manera diferente que en Rusia, y prefieren centros de fragancia con aromas como el de zanahoria y vainilla, no con olor a pino.
Dado que necesitamos cambiar rápidamente el contenido del sitio, el desarrollo de software está cambiando drásticamente. A través del software, debemos saber lo que quiere el cliente. Antes, esto lo descubríamos por métodos indirectos, como a través de la gestión empresarial. Luego, diseñábamos, incorporábamos los requisitos en el sistema informático y todo funcionaba perfectamente. Ahora es diferente: el software es diseñado por todos los involucrados en el proceso, incluidos los ingenieros, porque ellos aprenden a través de las especificaciones técnicas cómo funciona el mercado y también comparten sus conocimientos con el negocio.
Por ejemplo, en la empresa Qik, de repente descubrimos que a la gente le gusta mucho subir listas de contactos al servidor, y nos desarrollaron una aplicación para ello. Inicialmente, no habíamos pensado en esto. En una empresa clásica, todos habrían decidido que era un error, ya que en la especificación no se decía que debía funcionar bien y, de hecho, se había implementado de manera improvisada; habrían desactivado la función y dirían: «No es necesario, lo más importante es que la funcionalidad básica funcione». Pero una empresa tecnológica ve una oportunidad en esto y comienza a cambiar el software en consecuencia.
En 1968, un perspicaz joven llamado Melvin Conway formuló la siguiente idea.
Una organización que crea un sistema está limitada por el diseño que copia la estructura de comunicación dentro de esa organización.
Para producir sistemas de otro tipo, es necesario tener además una estructura de comunicación diferente dentro de la empresa. Si su estructura de comunicación es jerárquica, no podrá crear sistemas que proporcionen un alto índice de Time-to-market.
Leer en . Es importante para entender la cultura o filosofía de DevOps, ya que lo único que cambia fundamentalmente en DevOps es precisamente la estructura de comunicación entre equipos..
Desde el punto de vista del proceso, antes de DevOps, todas las etapas: análisis, desarrollo, pruebas, explotación, eran lineales.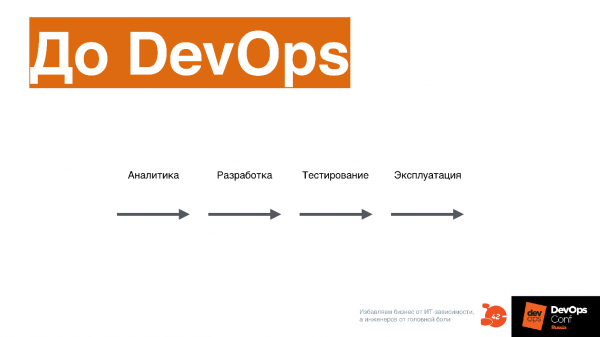
En el caso de DevOps, todos estos procesos se desarrollan simultáneamente.
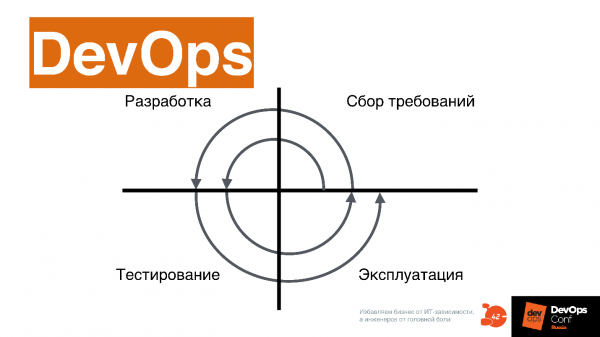
El Time-to-market solo se puede cumplir de esta manera. Para las personas que trabajaron en el antiguo proceso, esto parece un poco extraño y en general no es muy bien visto.
Entonces, ¿por qué se necesita DevOps?
Para el desarrollo de productos digitales. Si su empresa no tiene un producto digital, no necesita DevOps, esto es muy importante.
DevOps supera las limitaciones de velocidad del modelo de producción secuencial. En él, todos los procesos ocurren al mismo tiempo.
Aumenta la complejidad. Cuando los evangelistas de DevOps dicen que con él será más fácil lanzar software, es una tontería.
Con DevOps, las cosas solo serán más complejas.
En la conferencia, en el stand de Avito, se podía ver lo que significa desplegar un contenedor Docker: una tarea increíblemente difícil. La complejidad se vuelve abrumadora, hay que hacer malabares con muchas cosas al mismo tiempo.
DevOps cambia completamente el proceso y la organización de la empresa — más bien, no lo cambia DevOps, sino el producto digital. Para llegar al DevOps, este proceso debe cambiarse por completo.
Preguntas para el especialista
¿Y usted? Preguntas que puede hacerse mientras trabaja en la empresa y se desarrolla como especialista.
¿Tiene una estrategia para crear un producto digital? Si la tiene, ya es un buen signo. Esto significa que su empresa avanza hacia DevOps.
¿Su empresa ya está creando un producto digital? Esto significa que puede avanzar un paso más, dedicarse a asuntos más interesantes, desde el punto de vista de DevOps nuevamente. Hablo solo desde este punto de vista.
¿Su empresa es uno de los líderes del mercado en el nicho de productos digitales? Spotify, Yandex, Uber: empresas que están a la vanguardia del progreso tecnológico en este momento.
Pregúntate estas cuestiones, y si todas las respuestas son negativas, tal vez no deberías involucrarte en DevOps en esta empresa. Sin embargo, si realmente te interesa el tema de DevOps, ¿quizás deberías considerar cambiar de empresa? Si tu empresa quiere incorporar DevOps, pero has respondido "No" a todas las preguntas, entonces se parece a ese hermoso rinoceronte que nunca cambiará.
Organización
Como ya he mencionado, según la ley de Conway, la organización en la empresa cambia. Comenzaré por lo que impide que DevOps se infiltre en la empresa desde la perspectiva organizacional.
El problema de los "silos"
La palabra inglesa "Silo" se traduce aquí al español como "silo". El sentido de este problema es que no hay intercambio de información entre los equipos.Cada equipo profundiza en su propia experiencia sin construir un mapa común en el que se pueda orientar.
Esto se asemeja a una persona que acaba de llegar a Moscú y aún no sabe orientarse en el mapa del metro. Los moscovitas suelen conocer su área perfectamente, mientras que en toda Moscú se orientan con el mapa del metro. Cuando llegas a Moscú por primera vez, no tienes esta habilidad y simplemente te sientes desorientado.
DevOps propone atravesar este momento de desorientación y construir juntos un mapa común de interacción entre todos los departamentos.
Dos factores lo dificultan.
La consecuencia del sistema corporativo de gestión. Está construido sobre "silos" jerárquicos separados. Por ejemplo, hay ciertos KPI en las empresas que apoyan este sistema. Por otro lado, también intervienen las limitaciones cognitivas de la persona, que a menudo tiene dificultades para salir de los límites de su propia experiencia y orientarse en todo el sistema. Simplemente no es cómodo. Imagina que estás en el aeropuerto de Bangkok: no es fácil orientarse rápidamente. También es complicado orientarse en DevOps, por lo que la gente suele decir que hay que encontrar un guía para poder entrar.
Pero lo más importante es que el problema de los "silos" para un ingeniero que ha adoptado el espíritu de DevOps, que ha leído a Fowler y montones de otros libros, se expresa en el hecho de que "los silos" no permiten hacer cosas "obvias". A menudo nos reunimos después de DevOps Moscow, conversamos entre nosotros y la gente se queja:
— Solo queríamos iniciar CI, pero resultó que la gerencia no lo necesita.
Esto ocurre precisamente porque CI y proceso de entrega continua se encuentran en la frontera de muchas experiencias. Simplemente, al no superar el problema de los "pozos" a nivel organizacional, no se podrá avanzar más, por mucho que se haga y por triste que sea.
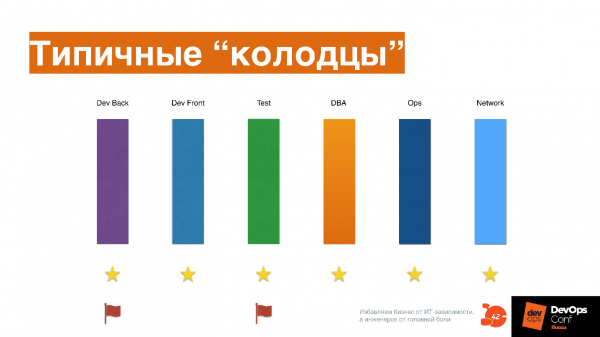
Cada participante del proceso en la empresa: desarrolladores de backend y frontend, pruebas, DBA, operaciones, redes, trabaja en su propia dirección, y nadie tiene un mapa general, excepto el gerente, que de alguna manera los observa y gestiona con el método de "divide y vencerás".
Las personas luchan por algunas estrellitas o banderitas, cada uno profundiza en su propia experiencia.
Al final, cuando surge la tarea de juntar todo esto y construir un pipeline común, y ya no es necesario luchar por estrellitas y banderitas, surge la pregunta: ¿qué se debe hacer? Hay que llegar a un acuerdo de alguna manera, pero ¿cómo se hace eso? En la escuela no nos enseñaron. Desde el colegio nos enseñaron: ¡octavo grado — wow! — en comparación con séptimo grado. Aquí es lo mismo.
¿Es igual en su empresa?
Para comprobarlo, se pueden hacer las siguientes preguntas.
¿Utilizan los equipos herramientas comunes, aportan cambios a estas herramientas comunes?
¿Con qué frecuencia se reorganizan los equipos — especialistas de un equipo pasan a otro equipo? Esto se vuelve normal en el entorno DevOps, porque a veces una persona simplemente no entiende qué hace otra área de especialización. Se mudan a otro departamento, trabajan allí durante un par de semanas para crear un mapa de orientación e interacción con ese departamento.
¿Se puede crear un comité de cambio y hacer algo al respecto? ¿O se necesita la mano firme de la alta dirección y una orden? Recientemente escribí en Facebook cómo un banco poco conocido implementa herramientas a través de órdenes: escribieron una orden, llevan un año implementándola y observan qué sucede. Eso, por supuesto, es largo y triste.
¿Cuán importante es para los gerentes lograr logros personales sin tener en cuenta los logros de la empresa?
Si respondes a estas preguntas, te será más claro si tienes este problema en la empresa.
Infraestructura como código
Una vez que se ha resuelto este problema, la primera práctica importante, sin la cual es difícil avanzar en DevOps, es infraestructura como código.
La infraestructura como código se percibe más comúnmente de la siguiente manera:
— ¡Automatizamos todo con bash, llenémonos de scripts para que los administradores tengan menos trabajo manual!
Pero no es así.
La infraestructura como código implica que describes el sistema IT con el que trabajas en forma de código, para comprender siempre su estado.
Junto con otros equipos, creas un mapa en forma de código que es claro para todos, sobre el cual se puede orientar y navegar. No importa en qué se haya hecho: Chef, Ansible, Salt, o si se utilizan archivos YAML en Kubernetes, no hay diferencia.
En la conferencia, un colega de 2GIS habló sobre cómo crearon su herramienta interna para Kubernetes, que describe la configuración de sistemas individuales. Para describir 500 sistemas, necesitaron una herramienta separada que genera esta descripción. Cuando existe esta descripción, cualquiera puede consultarla, monitorear cambios, cómo modificarla y mejorarla, y qué falta.
Estarás de acuerdo en que los scripts bash separados normalmente no proporcionan esa comprensión. En una de las empresas donde trabajé, incluso había un nombre para ellos: script 'write only' — una vez escrito, ya no se puede leer. Creo que a ti también te resulta familiar.
La infraestructura como código es código que describe el estado actual de la infraestructura. Este código es trabajado en conjunto por muchos equipos de producto, infraestructura y servicios, y lo más importante, todos ellos deben entender cómo funciona este código.
El código se mantiene de acuerdo con las mejores prácticas de desarrollo de software:desarrollo colaborativo, revisión de código, programación XP, pruebas, pull requests, CI para la infraestructura como código — todo esto es valioso y se puede utilizar.
El código se convierte en un lenguaje común para todos los ingenieros.
Modificar la infraestructura en código no lleva mucho tiempo. Sí, en el código de infraestructura también puede haber deuda técnica. Generalmente, los equipos se enfrentan a ella un año y medio después de haber comenzado a implementar 'infraestructura como código' en forma de un montón de scripts o incluso Ansible, que escriben como si fuera código espagueti, y además le añaden unos scripts bash al fuego.
Importante: si aún no has probado este truco, recuerda que Ansible no es bash! Lee la documentación con atención, investiga lo que se dice sobre esto.
La infraestructura como código es la separación del código de infraestructura en capas distintas.
En nuestra empresa, destacamos 3 capas básicas que son muy claras y simples, pero pueden haber más. Puedes revisar tu código de infraestructura y decir si tienes esta condición o no. Si no se destacan capas, es necesario dedicar tiempo para refactorizar un poco.
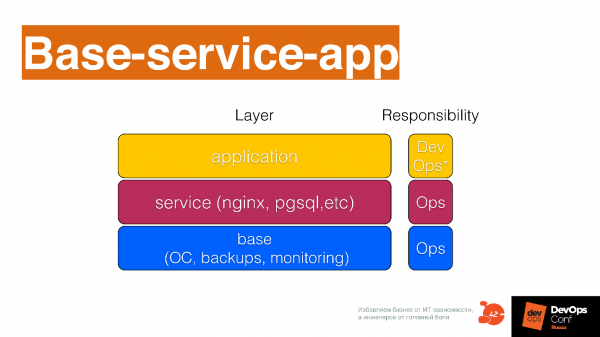
Capa básica es como se configura el sistema operativo, las copias de seguridad y otras cosas a bajo nivel, por ejemplo, cómo se despliega Kubernetes en un nivel básico.
Nivel de servicios son los servicios que ofreces al desarrollador: logging como servicio, monitoreo como servicio, base de datos como servicio, balanceador como servicio, cola como servicio, Continuous Delivery como servicio: un montón de servicios que equipos separados pueden proporcionar al desarrollo. Todo esto debe describirse en módulos separados en tu sistema de gestión de configuración.
Capa donde se desarrollan las aplicaciones y se describe cómo se desplegarán sobre las dos capas anteriores.
Preguntas clave
¿Tienes en tu empresa un repositorio de infraestructura común? ¿Controlas la deuda técnica en la infraestructura? ¿Usas prácticas de desarrollo en el repositorio de infraestructura? ¿Está tu infraestructura dividida en capas? Puedes consultar con el esquema Base-service-APP. ¿Qué tan difícil es hacer un cambio?
Si te has encontrado con que hacer cambios toma un día y medio, eso significa que tienes deuda técnica y debes trabajar en ello. Te has topado con el problema de la deuda técnica en el código de infraestructura. Recuerdo muchas historias en las que para cambiar algún CCTL, necesitas reescribir la mitad del código de infraestructura porque la creatividad y el deseo de automatizar todo llevaron a que todo esté enredado, se quitaron todas las manijas, y es necesario refactorizar.
Entrega continua
Hagamos un balance entre el débito y el crédito. Primero, aparece una descripción de la infraestructura, que puede ser bastante básica. No es necesario describir todo en detalle, pero se requiere alguna descripción básica para que puedas trabajar con ello. De lo contrario, no está claro sobre qué hacer a continuación para realizar una entrega continua. Todas estas prácticas se despliegan al mismo tiempo cuando llegas a DevOps, pero debes comenzar con el entendimiento de lo que tienes y cómo gestionarlo. Esa es precisamente la práctica de infraestructura como código.
Después de entender lo que tienes y cómo gestionarlo, comienzas a idear cómo enviar el código del desarrollador al producción lo más rápido posible. Me refiero a hacerlo junto con el desarrollador, recordando el problema de los “pozos”, es decir, no son solo personas individuales las que lo idean, sino el equipo.
Cuando estuvimos con Vanya Evtukhovich y vimos el primer libro de Jez Humble y un grupo de autores «Continuous Delivery», que salió en 2009, pensamos mucho sobre cómo traducir su título al español. Queríamos traducirlo como «Entrega continua», pero, lamentablemente, se tradujo como «Entrega continua». Me parece que en nuestro título hay algo muy español, con ímpetu.
Entregar continuamente significa
El código que está en el repositorio de productos siempre puede ser desplegado en producción.Puede que no se despliegue, pero siempre está listo para ello. En consecuencia, siempre escribes código con una sensación difícil de explicar de cierta inquietud en la parte baja de la espalda. Esta sensación de inquietud debería estar presente; provoca procesos mentales que permiten escribir el código de manera un poco diferente. Esto debe estar registrado en las reglas dentro del desarrollo.
Para entregar continuamente, se necesita un formato de artefacto que pase por la plataforma de infraestructura. Si lanzas en la plataforma de infraestructura desechos de diferentes formatos, se vuelve no unificada, es difícil de mantener, y surge el problema de la deuda técnica. El formato del artefacto debe alinearse, y esa también es una tarea colectiva: todos deben reunirse, poner sus mentes en marcha y pensar en este formato.
El artefacto mejora continuamente y cambia en función del entorno de producción durante su paso por el pipeline de entrega. Cuando el artefacto se mueve a través del pipeline, siempre se enfrenta a ciertas dificultades similares a las que encuentra el artefacto que se despliega en producción. Si en el desarrollo clásico esto es manejado por el administrador de sistemas que realiza el despliegue, en el proceso de DevOps esto ocurre constantemente: aquí lo han probado con algunas pruebas, allí lo han lanzado al clúster de Kubernetes, que es más o menos similar a producción, y de repente han iniciado pruebas de carga.
Esto se asemeja a un juego de Pac-Man: el artefacto sigue una historia. Es fundamental controlar si el código realmente sigue esta historia y si está relacionado con tu producción. Las historias de producción pueden incorporarse al proceso de Continuous Delivery: había un caso en el que algo falló, así que vamos a programar este escenario dentro del sistema. Cada vez que el código pase por este escenario, no te encontrarás con el mismo problema la próxima vez. Te enterarás de él mucho antes de que llegue a tu cliente.
Diferentes estrategias de despliegue. Por ejemplo, utilizas pruebas A/B o despliegues canarios para "tocar" el código de diferentes formas en diferentes clientes, obteniendo información sobre cómo funciona el código, mucho antes de que se despliegue a 100 millones de usuarios.
La "entrega continua" se ve así.
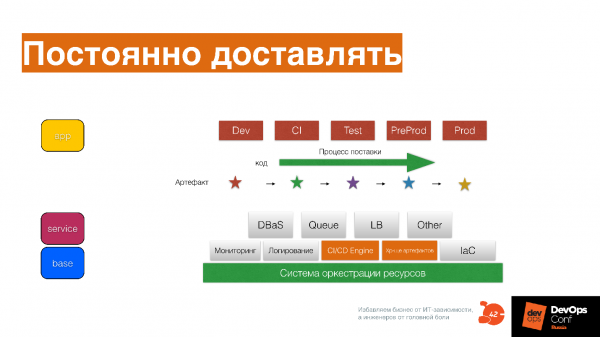
El proceso de entrega Dev, CI, Test, PreProd, Prod no es un entorno separado, son etapas o estaciones con sumas inextinguibles, por las que pasa tu artefacto.
Si tienes código de infraestructura que está descrito como Base Service APP, entonces ayuda a no olvidar todos los escenarios, y también registrar estos escenarios como código para este artefacto, promover el artefacto y modificarlo a medida que avanza.
Preguntas para autoevaluación
¿El tiempo desde la descripción de la característica hasta el despliegue en producción es, en el 95 % de los casos, menor de una semana? ¿Aumenta la calidad del artefacto en cada etapa del pipeline? ¿Hay una historia por la que pasa? ¿Utilizas diversas estrategias de despliegue?
Si todas las respuestas son sí, ¡entonces eres increíble! Deja tus respuestas en los comentarios, estaré encantado de leerlas).
Retroalimentación
Esta es la práctica más complicada de todas. En la conferencia DevOpsConf, un colega de Infobip, al hablar sobre ella, se confundía un poco porque realmente es una práctica muy complicada sobre lo que hay que monitorear: ¡todo!
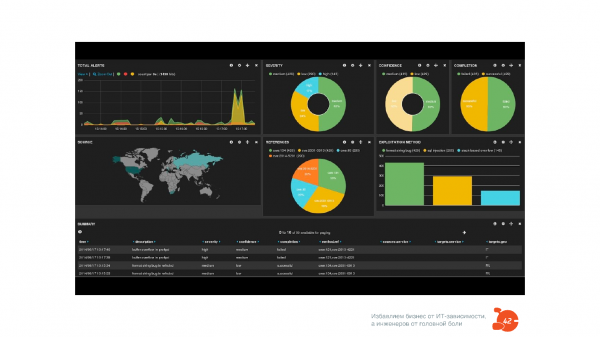
Por ejemplo, hace tiempo, cuando trabajaba en Qik, nos dimos cuenta de que había que monitorear todo. Lo hicimos, y en Zabbix aparecieron 150,000 items que se monitorean constantemente. Era aterrador, el director técnico se volvió loco:
— Chicos, ¿por qué están torturando el servidor con cosas incomprensibles?
Pero luego sucedió algo que demostró que esta es realmente una estrategia muy buena.
Uno de los servicios comenzó a fallar constantemente. Inicialmente no fallaba, lo curioso es que no se estaba agregando código, porque era un broker básico, que prácticamente no tenía funcionalidad empresarial, simplemente enviaba mensajes entre servicios distintos. El servicio no cambió durante 4 meses, y de repente comenzó a fallar con el error «Segmentation fault».
Estábamos en shock, abrimos nuestros gráficos en Zabbix, y descubrimos que hace una semana y media el comportamiento de las solicitudes en el servicio API había cambiado drásticamente. Luego observamos que cambió la frecuencia de envío de un cierto tipo de mensajes. Después supimos que eran los clientes de Android. Les preguntamos:
— Chicos, ¿qué sucedió hace una semana y media?
En respuesta escuchamos una historia interesante sobre cómo habían remodelado la interfaz. Difícilmente alguien diría de inmediato que cambiaron la biblioteca HTTP. Para los clientes de Android es como cambiar el jabón en el baño: simplemente no lo recuerdan. Al final, después de 40 minutos de conversación, descubrimos que efectivamente habían cambiado la biblioteca HTTP, y esta había cambiado los tiempos predeterminados. Esto provocó un cambio en el comportamiento del tráfico en el servidor API, lo que llevó a una situación que causó una carrera dentro del broker, y comenzó a fallar.
Sin un monitoreo profundo, esto sería imposible de detectar.. Si en la organización hay otro problema de "pozos", donde cada uno se pasa la responsabilidad al otro, esto puede persistir durante años. Simplemente reinicias el servidor porque no se puede resolver el problema. Cuando monitoreas, sigues y registras todos los eventos que tienes, y usas el monitoreo como prueba — escribes el código y de inmediato indicas cómo monitorearlo, también en forma de código (ya tenemos infraestructura como código), todo se vuelve claro como el agua. Incluso los problemas más complejos son fáciles de rastrear.
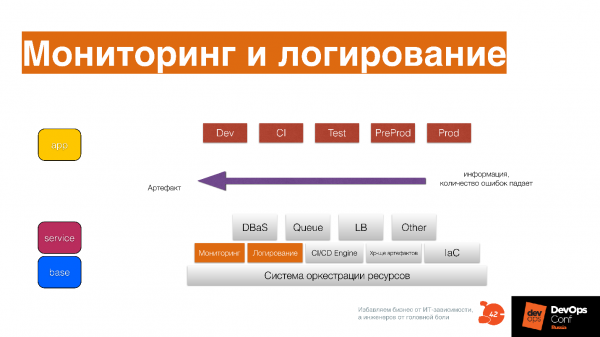
Reúne toda la información sobre lo que ocurre con el artefacto en cada etapa del proceso de entrega — no en producción.
Carga el monitoreo en CI, y ahí ya se verán algunas cosas básicas. Luego las verás tanto en Test como en PredProd y en pruebas de carga. Recoge información en todas las etapas, no solo métricas y estadísticas, sino también registros: cómo se desplegó la aplicación, anomalías — recopila todo.
De lo contrario, será difícil entender. Ya he mencionado que DevOps implica una mayor complejidad. Para lidiar con esta complejidad, necesitas tener una analítica adecuada..
Preguntas para la autoevaluación.
¿Es tu monitoreo y registro una herramienta de desarrollo para ti? ¿Tus desarrolladores, incluido tú mismo, piensan en cómo monitorear el código que escriben?
¿Te enteras de los problemas por parte de los clientes? ¿Comprendes mejor al cliente a través del monitoreo y el registro? ¿Comprendes mejor el sistema a través del monitoreo y el registro? ¿Cambias el sistema simplemente porque ves que la tendencia en el sistema está creciendo y entiendes que en tres semanas todo se caerá?
Cuando tienes estos tres componentes, puedes pensar en qué tipo de plataforma de infraestructura tienes en tu empresa.
Plataforma de infraestructura.
El sentido no está en que sea un conjunto de herramientas dispares que existen en cada empresa.
El objetivo de la plataforma de infraestructura es que todos los equipos utilicen estas herramientas y las desarrollen conjuntamente.
Es evidente que hay equipos separados que son responsables de desarrollar diferentes partes de la plataforma de infraestructura. Pero, al mismo tiempo, cada ingeniero es responsable del desarrollo, la operatividad y la promoción de la plataforma de infraestructura. A nivel interno, se convierte en una herramienta común..
Todos los equipos desarrollan la plataforma de infraestructura y la cuidan como si fuera su propia IDE.. En su IDE, coloca diferentes complementos para que todo sea hermoso y rápido, y configura atajos de teclado. Cuando abre Sublime, Atom o Visual Studio Code, aparecen errores de código y se da cuenta de que es completamente imposible trabajar, se siente triste de inmediato y corre a arreglar su IDE.
Trate su plataforma de infraestructura de la misma manera. Si se da cuenta de que algo no va bien, deje una solicitud si no puede solucionarlo usted mismo. Si es algo simple, corríjalo usted mismo, envíe una solicitud de extracción — el equipo la revisará y añadirá. Este es un enfoque diferente hacia las herramientas de ingeniería en la mente del desarrollador.
La plataforma de infraestructura garantiza la transferencia del artefacto desde el desarrollo al cliente con una mejora continua de la calidad.. En la PI, se programa un conjunto de historias que ocurren con el código en producción. A lo largo de los años de desarrollo, se acumulan muchas historias, algunas de las cuales son únicas y solo le conciernen a usted — no se pueden buscar en Google.
En este momento, la plataforma de infraestructura se convierte en su ventaja competitiva., porque incluye lo que no está en la herramienta de la competencia. Cuanto más profunda sea su PI, mayor será su ventaja competitiva en términos de Time-to-market. Aquí surge el problema del vendor lock: puede adoptar una plataforma ajena, pero al usar la experiencia de otros, no entenderá cuán relevante es para usted. Sí, no toda empresa puede construir una plataforma como la de Amazon. Es una línea complicada, donde la experiencia de la empresa es relevante a su posición en el mercado, y no se puede permitir el vendor lock allí. También es importante reflexionar sobre esto.
Esquema
Este es el esquema básico de la plataforma de infraestructura que le ayudará a establecer todas las prácticas y procesos en una empresa DevOps.
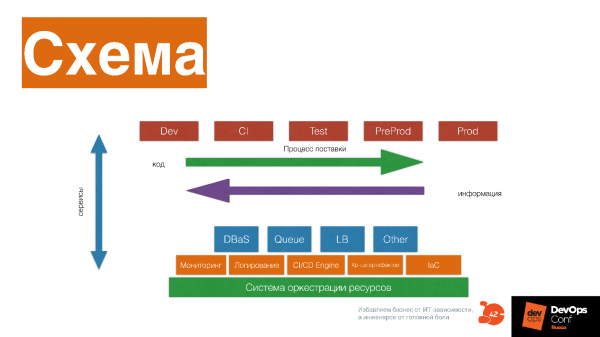
Consideremos de qué se compone.
Sistema de orquestación de recursos, que proporciona CPU, memoria y almacenamiento a las aplicaciones y otros servicios. Encima de esto — servicios de bajo nivel: monitoreo, registro, motor CI/CD, almacenamiento de artefactos, infraestructura como código.
Servicios de mayor nivel.: base de datos como servicio, colas como servicio, Balanceo de Carga como servicio, redimensionamiento de imágenes como servicio, Big Data como servicio. Por encima de esto — un pipeline que entrega código constantemente modificado a su cliente.
Obtiene información sobre cómo su software opera en el cliente, modifica, vuelve a entregar este código, obtiene información — y así desarrolla constantemente tanto la plataforma de infraestructura como su software.
En el esquema, el delivery pipeline consta de múltiples etapas. Pero esta es una representación básica, proporcionada como ejemplo — no es necesario replicarla al pie de la letra. Las etapas interactúan con los servicios como si fueran servicios — cada ladrillo de la plataforma tiene su propia historia: cómo se asignan los recursos, cómo se inicia la aplicación, cómo trabaja con los recursos, cómo se monitorea y se modifica.
Es importante entender que cada parte de la plataforma tiene su historia, y preguntarse — ¿cuál es la historia que cuenta este ladrillo? Tal vez valga la pena desecharlo y reemplazarlo con un servicio de terceros. Por ejemplo, ¿se puede sustituir un ladrillo por Okmeter? Tal vez ellos ya tengan más experiencia en esto que nosotros. Pero tal vez no — puede que tengamos una experiencia única, debemos implementar Prometheus y desarrollarlo más.
Creación de la plataforma
Es un proceso comunicativo complejo. Cuando tiene prácticas básicas, inicia la comunicación entre diferentes ingenieros y especialistas que desarrollan requisitos y estándares, y los cambian constantemente para diferentes herramientas y enfoques. Aquí la cultura es importante, la que existe en DevOps.
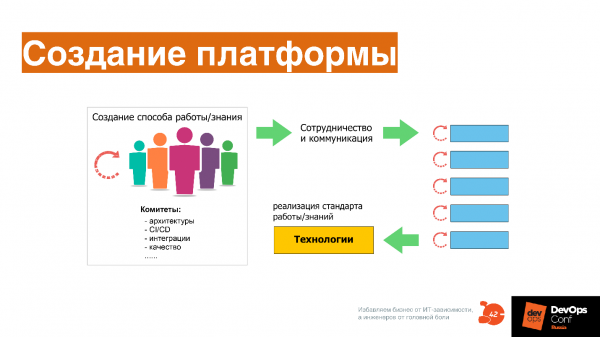
Con la cultura, todo es muy simple — es colaboración y comunicación, es decir, el deseo de trabajar conjuntamente en el mismo terreno, el deseo de dominar una herramienta juntos. No hay nada complicado — todo es muy simple, banal. Por ejemplo, todos vivimos en un edificio y mantenemos su limpieza — ese es el nivel de cultura.
¿Y ustedes?
Nuevamente, preguntas que pueden hacerse.
¿Está la plataforma de infraestructura claramente definida? ¿Quién es responsable de su desarrollo? ¿Comprenden las ventajas competitivas de su plataforma de infraestructura?
Estas son preguntas que debemos hacernos constantemente. Si algo se puede externalizar a servicios de terceros, se debe hacer; si un servicio externo comienza a bloquear tu progreso, entonces hay que construir un sistema interno.
Así que, DevOps…
… es un sistema complejo que debe incluir:
- Un producto digital.
- Módulos de negocio que desarrollan este producto digital.
- Equipos de producto que escriben código.
- Prácticas de Entrega Continua.
- Plataformas como servicio.
- Infraestructura como servicio.
- Infraestructura como código.
- Prácticas individuales para mantener la confiabilidad, integradas en DevOps.
- Práctica de retroalimentación que describe todo esto.
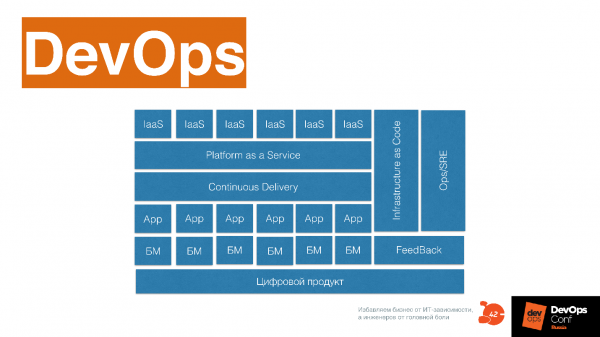
Puedes usar este esquema, resaltando lo que ya tienes en tu empresa de alguna manera: esto ha evolucionado o aún necesita desarrollarse.
En un par de semanas se llevará a cabo . como parte de RIT++. Ven a la conferencia, donde te esperan muchas charlas geniales sobre entrega continua, infraestructura como código y transformación DevOps. , el último plazo para precios es el 20 de mayo.
Fuente: habr.com
