

es un estándar (ISO, ITU-T, GOST) del lenguaje que describe información estructurada y las reglas para codificar esta información. Para mí, como programador, es simplemente otro formato de serialización y presentación de datos, al igual que JSON, XML, XDR y otros. Es extremadamente común en nuestra vida cotidiana y muchas personas se encuentran con él: en comunicaciones móviles, telefónicas, VoIP (UMTS, LTE, WiMAX, SS7, H.323), en protocolos de red (LDAP, SNMP, Kerberos), en todo lo relacionado con criptografía (X.509, CMS, estándares PKCS), en tarjetas bancarias y pasaportes biométricos, entre muchos otros.
Este artículo trata sobre : la biblioteca Python ASN.1 que se utiliza activamente en proyectos relacionados con la criptografía en .
En general, no se recomienda usar ASN.1 para tareas criptográficas: ASN.1 y sus códecs son complejos. Esto significa que el código no será sencillo, lo que siempre representa un vector de ataque adicional. Basta con mirar de vulnerabilidades en bibliotecas ASN.1. Bruce Schneier en su también desaconseja el uso de este estándar debido a su complejidad: «El codificador TLV más conocido es ASN.1, pero es increíblemente complejo y nos alejamos de él». Pero, desafortunadamente, hoy en día tenemos en los que se utilizan activamente , CRL, OCSP, TSP, protocolos CMP, , mensajes , y una multitud de estándares . Por lo tanto, es necesario saber trabajar con ASN.1 si estás involucrado en algo relacionado con la criptografía.
ASN.1 puede ser codificado de múltiples maneras/códecs:
- (Reglas de Codificación Básica)
- (Reglas de Codificación Canónica)
- (Reglas de Codificación Distinguida)
- (Reglas de Codificación de Cadenas Genéricas)
- (Reglas de Codificación JSON)
- LWER (Reglas de Codificación Ligera)
- (Reglas de Codificación de Octetos)
- (Reglas de Codificación Empacadas)
- SER (Reglas de Codificación específicas de Señalización)
- (Reglas de Codificación XML)
y otros varios. Sin embargo, en las tareas criptográficas se utilizan principalmente dos: BER y DER. Incluso en documentos XML firmados (, ) siempre habrá objetos ASN.1 DER codificados en Base64, así como en el protocolo orientado a JSON de Let's Encrypt. Es mejor comprender todos estos códecs y principios de codificación BER/CER/DER a través de artículos y libros: , , .
BER es un formato TLV binario orientado a bytes (por ejemplo, PER, popular en comunicaciones móviles — orientado a bits). Cada elemento se codifica en forma de: una etiqueta (Tag), que identifica el tipo del elemento codificado (número entero, cadena, fecha, etc.), longitud (Length) del contenido y el propio contenido (VEl valor). BER opcionalmente permite no especificar el valor de longitud, estableciendo un valor de longitud indefinida y finalizando el mensaje con una etiqueta End-Of-Octets. Además de la codificación de longitud, BER tiene mucha variabilidad en la forma de codificar los tipos de datos, como por ejemplo:
- INTEGER, IDENTIFICADOR DE OBJETO, BIT STRING y la longitud del elemento pueden estar desnormalizados (no codificados en la forma mínima);
- BOOLEAN es verdadero con cualquier contenido no nulo;
- BIT STRING puede contener bits nulos "extra";
- BIT STRING, OCTET STRING y todos sus tipos de cadena derivados, incluyendo fecha/hora, pueden ser fragmentados en trozos (chunk) de longitud variable, cuya longitud no es conocida de antemano durante la (de)codificación;
- UTCTime/GeneralizedTime pueden tener diferentes formas de especificar el desplazamiento de la zona horaria y "fracciones" de segundos nulos "extra";
- Los valores DEFAULT de SEQUENCE se pueden codificar o no;
- Los valores nombrados de los últimos bits en BIT STRING pueden no codificarse si se desea;
- SEQUENCE (OF)/SET (OF) pueden tener un orden arbitrario de elementos.
Debido a todo lo anterior, codificar datos de manera que sean idénticos a la forma original no siempre es posible. Por lo tanto, se ideó un subconjunto de reglas: DER - que regula estrictamente solo una forma válida de codificación, lo que es crítico para tareas criptográficas, donde, por ejemplo, cambiar un bit hará que la firma o el checksum sean inválidos. DER tiene una desventaja significativa: las longitudes de todos los elementos deben ser conocidas de antemano durante la codificación, lo que no permite serializar datos de manera secuencial. El códec CER carece de esta desventaja, garantizando de manera similar la representación única de los datos. Desafortunadamente (o afortunadamente porque no tenemos decodificadores aún más complejos?), no se popularizó. Por lo tanto, en la práctica encontramos un uso "mezclado" de datos codificados en BER y DER. Dado que tanto CER como DER son subconjuntos de BER, cualquier decodificador BER puede procesarlos.
Problemas con pyasn1
En el trabajo, escribimos muchos programas en Python relacionados con la criptografía. Hace varios años, prácticamente no había librerías libres para elegir: o eran librerías de muy bajo nivel, que solo permitían codificar/decodificar, por ejemplo, un número entero y el encabezado de una estructura, o era la librería . En ella vivimos varios años y al principio estábamos muy contentos, ya que permite trabajar con estructuras ASN.1 como si fueran objetos de alto nivel: por ejemplo, un objeto decodificado de un certificado X.509 permite acceder a sus campos a través de una interfaz de diccionario: cert[«tbsCertificate»][«serialNumber»] nos mostrará el número de serie de este certificado. De manera similar, se pueden "construir" objetos complejos trabajando con ellos como si fueran listas, diccionarios, y luego simplemente llamar a la función pyasn1.codec.der.encoder.encode y obtener una representación serializada del documento.
Sin embargo, se revelaron desventajas, problemas y limitaciones. En pyasn1 había y, lamentablemente, todavía hay errores: en el momento de escribir este artículo, uno de los tipos básicos en pyasn1 — GeneralizedTime, ni codifica correctamente.
En nuestros proyectos, para ahorrar espacio, a menudo solo almacenamos la ruta al archivo, el desplazamiento y la longitud en bytes del objeto al que queremos referirnos. Por ejemplo, un archivo firmado arbitrario seguramente estará dentro de la estructura ASN.1 CMS SignedData:
  0     [1,3,1018]  ContentInfo SEQUENCE
  4     [1,1,   9]   . contentType: ContentType OBJECT IDENTIFIER 1.2.840.113549.1.7.2 (id_signedData)
 19-4   [0,0,1003]   . content: [0] EXPLICIT [UNIV 16] ANY
 19     [1,3, 999]   . . DEFINED BY id_signedData: SignedData SEQUENCE
 23     [1,1,   1]   . . . version: CMSVersion INTEGER v3 (03)
 26     [1,1,  19]   . . . digestAlgorithms: DigestAlgorithmIdentifiers SET OF
                           [...]
 47     [1,3, 769]   . . . encapContentInfo: EncapsulatedContentInfo SEQUENCE
 51     [1,1,   8]   . . . . eContentType: ContentType OBJECT IDENTIFIER 1.3.6.1.5.5.7.12.2 (id_cct_PKIData)
 65-4   [1,3, 751]   . . . . eContent: [0] EXPLICIT OCTET STRING 751 bytes OPTIONAL

                 AQUÍ CONTENIDO DEL ARCHIVO FIRMA QUE MIDE 751 bytes

820     [1,2, 199]   . . . signerInfos: SignerInfos SET OF
823     [1,2, 196]   . . . . 0: SignerInfo SEQUENCE
826     [1,1,   1]   . . . . . version: CMSVersion INTEGER v3 (03)
829     [0,0,  22]   . . . . . sid: SignerIdentifier CHOICE subjectKeyIdentifier
                               [...]
956     [1,1,  64]   . . . . . signature: SignatureValue OCTET STRING 64 bytes
                     . . . . . . C1:B3:88:BA:F8:92:1C:E6:3E:41:9B:E0:D3:E9:AF:D8
                     . . . . . . 47:4A:8A:9D:94:5D:56:6B:F0:C1:20:38:D2:72:22:12
                     . . . . . . 9F:76:46:F6:51:5F:9A:8D:BF:D7:A6:9B:FD:C5:DA:D2
                     . . . . . . F3:6B:00:14:A4:9D:D7:B5:E1:A6:86:44:86:A7:E8:C9
y podemos obtener el archivo firmado original con un desplazamiento de 65 bytes, con una longitud de 751 bytes. pyasn1 no almacena esta información en sus objetos decodificados. Se creó una pequeña biblioteca llamada TLVSeeker que permite decodificar etiquetas y longitudes de objetos, en cuyo interfaz dábamos comandos como "ir a la siguiente etiqueta", "entrar en la etiqueta" (accedemos al objeto SEQUENCE), "ir a la siguiente etiqueta", "indicar tu offset y longitud del objeto donde estamos en ese momento". Era una navegación "manual" a través de datos serializados en ASN.1 DER. Pero no se podía trabajar así con datos serializados en BER, ya que, por ejemplo, la cadena de bytes OCTET STRING podría estar codificada en varios bloques.
Otra desventaja de pyasn1 para nuestras tareas es la imposibilidad de saber a partir de los objetos decodificados si un campo específico estaba presente en SEQUENCE o no. Por ejemplo, si la estructura contiene un campo Field SEQUENCE OF Smth OPTIONAL, podría estar completamente ausente en los datos recibidos (OPTIONAL) o podría estar presente, pero tener una longitud cero (lista vacía). En general, esto no se podía determinar. Y esto es necesario para una verificación rigurosa de la validez de los datos recibidos. ¡Imagínese que alguna autoridad certificadora emita un certificado con datos "no del todo" válidos desde el punto de vista del esquema ASN.1! Por ejemplo, la autoridad certificadora "TÜRKTRUST Elektronik Sertifika Hizmet Sağlayıcısı" en su certificado raíz se salió de los límites permitidos. los límites de longitud del componente subject — no se puede decodificar honestamente según el esquema. El códec DER requiere que un campo cuyo valor sea igual al valor DEFAULT no se codifique al ser transmitido; en la práctica, tales documentos existen, y la primera versión de PyDERASN incluso permitía conscientemente ese comportamiento no válido (desde el punto de vista de DER) por razones de compatibilidad hacia atrás.
Otra limitación es la dificultad de saber en qué formato (BER/DER) se ha codificado un objeto determinado en la estructura. Por ejemplo, el estándar CMS dice que el mensaje se codifica en BER, pero el campo signedAttrs, sobre el cual se genera la firma criptográfica, debe estar en DER. Si decodificamos usando DER, encontraremos problemas en el procesamiento del CMS, y si decodificamos en BER, no sabremos en qué formato estaba signedAttrs. Al final, tendremos que utilizar TLVSeeker (no hay análogo en pyasn1) para buscar la ubicación de cada uno de los campos signedAttrs y decodificarlo por separado, tomando de la representación serializada en DER.
Para nosotros, era muy deseable tener la capacidad de procesar automáticamente los campos DEFINED BY, los cuales aparecen con mucha frecuencia. Después de decodificar la estructura ASN.1, podemos quedarnos con muchos campos ANY, que deben ser procesados según el esquema elegido basado en el OBJECT IDENTIFIER especificado en el campo de la estructura. En el código Python, esto significa escribir un if y luego llamar al decodificador para el campo ANY.
Aparición de PyDERASN
En Atlas, regularmente, al encontrar problemas o al mejorar los programas de código abierto que utilizamos, enviamos parches hacia arriba. En pyasn1 hemos enviado mejoras varias veces, pero el código de pyasn1 no es el más sencillo de entender y, a veces, ha habido cambios incompatibles en la API que nos han afectado. Además, estamos acostumbrados a escribir pruebas con pruebas generativas, lo cual no existía en pyasn1.
Un buen día decidí que era suficiente y era hora de intentar escribir mi propia biblioteca con __slots__, offsets y blobs que se visualizaran perfectamente. Simplemente crear un códec ASN.1 no sería suficiente: había que migrar todos nuestros proyectos interdependientes hacia él, lo que significaba cientos de miles de líneas de código repletas de trabajo con estructuras ASN.1. Así que uno de los requisitos para ello era la facilidad de migrar el código actual de pyasn1. Gastando todas mis vacaciones, escribí esta biblioteca y trasladé todos los proyectos a ella. Dado que tienen prácticamente una cobertura del 100% con pruebas, eso también significaba que la biblioteca funcionaba completamente.
PyDERASN, de manera similar, tiene prácticamente una cobertura del 100% con pruebas. Se utiliza prueba generativa con una maravillosa biblioteca . También se realizó -en máquinas de 32 núcleos. A pesar de que prácticamente no nos queda código en Python2, PyDERASN sigue garantizando la compatibilidad con él y por eso tiene una única dependencia. Además, ha sido probado contra .
El principio de trabajo con él es similar a pyasn1 — trabajado con objetos de alto nivel de Python. La descripción de los esquemas ASN.1 es similar.
class TBSCertificate(Sequence):
    schema = (
        ("version", Version(expl=tag_ctxc(0), default="v1")),
        ("serialNumber", CertificateSerialNumber()),
        ("signature", AlgorithmIdentifier()),
        ("issuer", Name()),
        ("validity", Validity()),
        ("subject", Name()),
        ("subjectPublicKeyInfo", SubjectPublicKeyInfo()),
        ("issuerUniqueID", UniqueIdentifier(impl=tag_ctxp(1), optional=True)),
        ("subjectUniqueID", UniqueIdentifier(impl=tag_ctxp(2), optional=True)),
        ("extensions", Extensions(expl=tag_ctxc(3), optional=True)),
    )
Sin embargo, PyDERASN tiene similitudes con la tipificación estricta. En pyasn1, si un campo tenía el tipo CMSVersion(INTEGER), se podía asignar un int o INTEGER. PyDERASN exige estrictamente que el objeto asignado sea exactamente CMSVersion. Además de que escribimos código en Python3, usamos , por lo tanto, en nuestras funciones no tendremos argumentos confusos como def func(serial, contents), sino def func(serial: CertificateSerialNumber, contents: EncapsulatedContentInfo), y PyDERASN ayuda a mantener tal código.
Al mismo tiempo, en PyDERASN hay concesiones muy útiles en esta tipificación. pyasn1 no permitía asignar un objeto SubjectKeyIdentifier() al campo en SubjectKeyIdentifier().subtype(implicitTag=Tag(...)) (sin el TAG IMPLICIT necesario) y a menudo era necesario copiar y recrear objetos solo debido a cambios en las etiquetas IMPLICIT/EXPLICIT. PyDERASN solo vigila estrictamente el tipo base: las etiquetas las insertará automáticamente según el esquema existente de la estructura ASN.1. Esto simplifica enormemente el código de las aplicaciones.
Si ocurre un error durante la decodificación, en pyasn1 no es fácil entender dónde ocurrió exactamente. Por ejemplo, en el certificado turco mencionado anteriormente obtendremos el siguiente error: UTF8String (tbsCertificate:issuer:rdnSequence:3:0:value:DEFINED BY 2.5.4.10:utf8String) (en 138) límites insatisfechos: 1 ⇐ 77 ⇐ 64 Al escribir estructuras ASN.1, las personas pueden cometer errores, y esto ayuda a depurar aplicaciones o identificar problemas en documentos codificados de la parte opuesta.
En la primera versión de PyDERASN no había soporte para codificación BER. Apareció mucho después y aún no se admite el procesamiento de UTCTime/GeneralizedTime con zonas horarias. Esto llegará en el futuro, ya que el proyecto se desarrolla principalmente en el tiempo libre de trabajo.
En la primera versión tampoco había trabajo con los campos DEFINED BY. Después de unos meses, esta y comenzó a utilizarse activamente, reduciendo considerablemente el código de las aplicaciones; con una sola operación de decodificación se podía obtener toda la estructura desglosada hasta el más mínimo detalle. Para ello, en el esquema se especifica qué campos «definen» qué. Por ejemplo, la descripción del esquema CMS:
class ContentInfo(Sequence):
    schema = (
        ("contentType", ContentType(defines=((("content",), {
            id_authenticatedData: AuthenticatedData(),
            id_digestedData: DigestedData(),
            id_encryptedData: EncryptedData(),
            id_envelopedData: EnvelopedData(),
            id_signedData: SignedData(),
        }),))),
        ("content", Any(expl=tag_ctxc(0))),
    )
indica que si contentType contiene un OID con el valor id_signedData, entonces el campo content (que se encuentra en esta misma SEQUENCE) debe ser decodificado según el esquema SignedData. ¿Por qué tantas paréntesis? Un campo puede «definir» varios campos al mismo tiempo, como ocurre en las estructuras EnvelopedData. Los campos definidos se identifican por el llamado decode path: este especifica la ubicación exacta de cualquier elemento en todas las estructuras.
No siempre se desea o no siempre es posible incluir estos defines en el esquema de inmediato. Pueden haber casos específicos de la aplicación en los que los OID y las estructuras son conocidos solo en un proyecto externo. PyDERASN ofrece la posibilidad de definir estos defines en el momento de la decodificación de la estructura:
ContentInfo().decode(data, ctx={"defines_by_path": ((
    (
        "content", DecodePathDefBy(id_signedData),
        "certificates", any, "certificate", "tbsCertificate",
        "extensions", any, "extnID",
    ),
    ((("extnValue",), {
        id_ce_authorityKeyIdentifier: AuthorityKeyIdentifier(),
        id_ce_basicConstraints: BasicConstraints(),
        [...]
        id_ru_subjectSignTool: SubjectSignTool(),
    }),),
),)})
Aquí estamos diciendo que en CMS SignedData para todos los certificados adjuntos, decodificar todas sus extensiones (AuthorityKeyIdentifier, BasicConstraints, SubjectSignTool, etc.). Especificamos a través del decode path a qué elemento se le deben «suministrar» los defines, como si hubiera sido definido en el esquema.
Finalmente, PyDERASN tiene la capacidad de trabajar desde para decodificar archivos ASN.1 y tiene un rico . Se puede decodificar un ASN.1 arbitrario, o se puede definir un esquema específico y ver algo como esto:
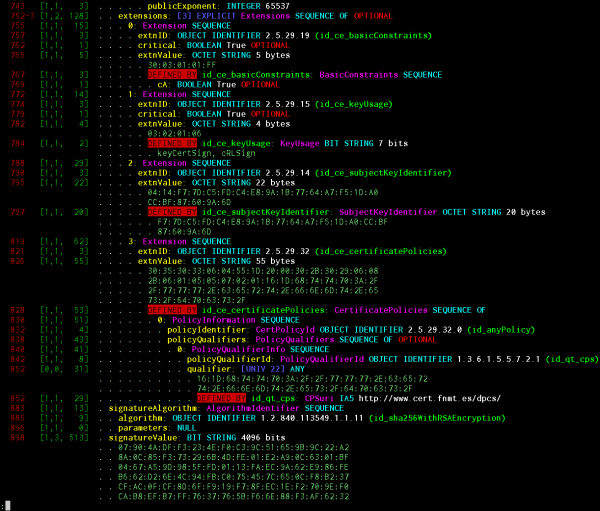
Información mostrada: desplazamiento del objeto, longitud de la etiqueta, longitud de contenido, longitud de contenido, presencia de EOC (fin de octetos), indicador de codificación BER, indicador de codificación de longitud indefinida, longitud y desplazamiento de la etiqueta EXPLICIT (si existe), profundidad de anidamiento del objeto en estructuras, valor de etiqueta IMPLICIT/EXPLICIT, nombre del objeto según el esquema, su tipo base ASN.1, número secuencial dentro de SEQUENCE/SET OF, valor de CHOICE (si existe), nombre legible por humanos INTEGER/ENUMERATED/BIT STRING según el esquema, valor de cualquier tipo básico, bandera DEFAULT/OPTIONAL del esquema, indicador de que el objeto fue decodificado automáticamente como DEFINED BY y a través de qué OID ocurrió, OID legible por humanos.
El sistema de impresión bonita está diseñado de tal manera que genera una secuencia de objetos PP, que son visualizados ya por medios separados. En la captura de pantalla se muestra un renderizador en texto colorido simple. También existen renderizadores en formato JSON/HTML, para que esto se pueda ver con resaltado en el navegador ASN.1 como en proyecto.
Otras bibliotecas
Este no era el objetivo, pero PyDERASN resultó ser significativamente que pyasn1. Por ejemplo, la decodificación de archivos CRL de tamaño megabyte puede llevar un tiempo tan prolongado que es necesario considerar formatos de almacenamiento de datos intermedios (rápidos) y cambiar la arquitectura de las aplicaciones. pyasn1 decodifica CRL en mi laptop en más de 20 minutos, mientras que PyDERASN lo hace en solo 28 segundos. Existe un proyecto , orientado a un trabajo rápido con estructuras criptográficas: decodifica (completamente, no de manera perezosa) el mismo CRL en 29 segundos, sin embargo, consume casi el doble de memoria RAM al ejecutarse bajo Python3 (983 MiB contra 498) y 3.5 veces más bajo Python2 (1677 contra 488), mientras que pyasn1 consume hasta 4.3 veces más (2093 contra 488).
asn1crypto, que mencioné, no lo examinamos porque el proyecto apenas comenzaba y no habíamos oído hablar de él. Ahora tampoco lo haría, ya que descubrí de inmediato que el mismo GeneralizedTime no acepta un formato arbitrario y al serializar silenciosamente elimina las fracciones de segundo. Esto es aceptable para trabajar con certificados X.509, pero en general no es adecuado.
En la actualidad, PyDERASN es el más estricto de los decodificadores DER gratuitos de Python/Go que conozco. En la biblioteca encoding/asn1 de mi querido Go IDENTIFICADOR DE OBJETO y la cadena UTCTime/GeneralizedTime. A veces, la rigidez puede ser un obstáculo (principalmente debido a la compatibilidad con aplicaciones antiguas que no serán arregladas), por lo que en PyDERASN se puede ajustar durante la decodificación. revisiones laxas.
El código del proyecto intenta ser lo más simple posible. Toda la biblioteca está en un solo archivo. El código está escrito con un enfoque en la facilidad de comprensión, sin optimizaciones excesivas de rendimiento ni código DRY. Como ya se mencionó, no tiene soporte completo para la decodificación BER de las cadenas UTCTime/GeneralizedTime, así como para los tipos de datos REAL, RELATIVE OID, EXTERNAL, INSTANCE OF, EMBEDDED PDV y CHARACTER STRING. En todos los demás casos, personalmente no veo sentido en usar otras bibliotecas en Python.
Como todos mis proyectos, tipo , , , , PyDERASN es completamente , distribuido bajo los términos de , y está disponible para descarga gratuita. Hay ejemplos de uso en y en .
, , miembro , desarrollador de Python/Go, especialista principal .
Fuente: habr.com
