

¡Hola de nuevo! El título del artículo habla por sí mismo. En la antesala del inicio del curso , ofrecemos aclarar quiénes son los ingenieros de datos. El artículo contiene muchos enlaces útiles. ¡Buen provecho en la lectura!
Una guía sencilla sobre cómo surfear la ola del Data Engineering y no ser arrastrado al abismo.
Da la impresión de que hoy en día cada uno quiere convertirse en científico de datos (Data Scientist). ¿Pero qué pasa con el Data Engineering? En esencia, es una especie de híbrido entre un analista de datos y un científico de datos; el ingeniero de datos generalmente se encarga de la gestión de flujos de trabajo, tuberías de procesamiento y procesos ETL.Dada la importancia de estas funciones, hoy en día se ha convertido en una jerga profesional muy popular que va ganando terreno.
Un alto salario y una demanda inmensa son solo una pequeña parte de lo que hace que este trabajo sea extremadamente atractivo. Si deseas unirte a las filas de los héroes, nunca es demasiado tarde para empezar a aprender. En esta publicación he recopilado toda la información necesaria para ayudarte a dar tus primeros pasos.
¡Así que comencemos!
¿Qué es el Data Engineering?
Honestamente, no hay mejor explicación que esta:
«Un científico puede descubrir una nueva estrella, pero no puede crearla. Tendrá que pedirle a un ingeniero que lo haga por él.»
–Gordon Lindsay Glegg
Por lo tanto, el papel del ingeniero de datos es bastante significativo.
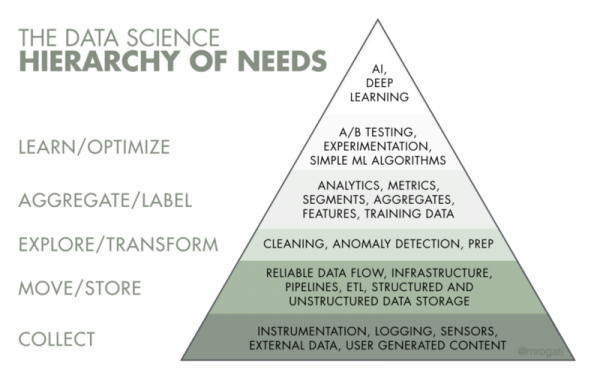
Como su nombre indica, el Data Engineering está relacionado con los datos, específicamente con su entrega, almacenamiento y procesamiento. En consecuencia, la tarea principal de los ingenieros es garantizar una infraestructura fiable para los datos. Si observamos la jerarquía de necesidades de la IA, el Data Engineering ocupa los primeros 2–3 niveles: recopilación, movimiento y almacenamiento, preparación de datos..
¿Qué hace un ingeniero de datos?
Con la aparición de grandes datos, el ámbito de responsabilidad ha cambiado drásticamente. Si antes estos expertos escribían grandes consultas SQL y transferían datos utilizando herramientas como Informatica ETL, Pentaho ETL, Talend, ahora las exigencias para los ingenieros de datos han aumentado.
La mayoría de las empresas con vacantes para ingenieros de datos tienen los siguientes requisitos:
- Excelentes conocimientos de SQL y Python.
- Experiencia en plataformas en la nube, en particular Amazon Web Services.
- Se prefiere el conocimiento de Java/Scala.
- Buena comprensión de las bases de datos SQL y NoSQL (modelado de datos, almacenamiento de datos).
Ten en cuenta que esto es solo lo más básico. De esta lista se puede inferir que los ingenieros de datos son especialistas en el desarrollo de software y en el backend.
Por ejemplo, si una empresa comienza a generar un gran volumen de datos de diferentes fuentes, tu tarea como ingeniero de datos es organizar la recopilación de información, su procesamiento y almacenamiento.
La lista de herramientas utilizadas en este caso puede variar, depende del volumen de estos datos, la velocidad de su llegada y su variabilidad. La mayoría de las empresas no se enfrentan a grandes datos, por lo que se puede utilizar una base de datos SQL (PostgreSQL, MySQL, etc.) como un almacén de datos centralizado con un pequeño conjunto de scripts que dirigen los datos al almacén.
Gigantes tecnológicos como Google, Amazon, Facebook o Dropbox tienen requisitos más altos: conocimiento de Python, Java o Scala.
- Experiencia con grandes datos: Hadoop, Spark, Kafka.
- Conocimiento de algoritmos y estructuras de datos.
- Comprensión de los fundamentos de los sistemas distribuidos.
- La experiencia con herramientas de visualización de datos, como Tableau o ElasticSearch, será un gran plus.
Es decir, hay un claro desplazamiento hacia los grandes datos, especialmente en su procesamiento bajo alta carga. Estas empresas tienen requisitos aumentados en términos de resistencia del sistema.
Ingenieros de datos Vs. científicos de datos
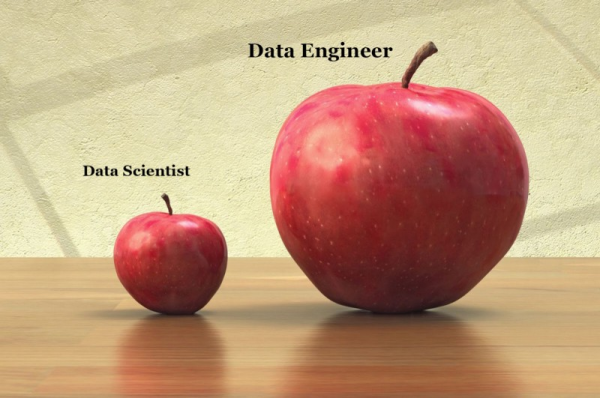
De acuerdo, esta fue una comparación simple y divertida (sin ofender), pero en realidad es mucho más complicado.
Primero, debes saber que hay bastante ambigüedad en la delimitación de roles y habilidades entre el científico de datos y el ingeniero de datos. Es decir, puedes fácilmente confundirte sobre qué habilidades son necesarias para ser un ingeniero de datos exitoso. Claro, hay ciertas habilidades que se superponen entre ambos roles. Pero también hay una serie de habilidades diametralmente opuestas.
La ciencia de datos es un asunto serio, pero nos dirigimos hacia un mundo con ciencia de datos funcional, donde los practicantes pueden hacer su propia analítica. Para habilitar los pipelines de datos y las estructuras de datos integradas, necesitas ingenieros de datos, no científicos.
¿Es el ingeniero de datos más demandado que el científico de datos?
— Sí, porque antes de que puedas hacer un pastel de zanahoria, primero necesitas cosechar, pelar y almacenar las zanahorias.
Un ingeniero de datos entiende de programación mejor que cualquier científico de datos, pero cuando se trata de estadísticas, todo es exactamente al revés.
Pero aquí está la ventaja del ingeniero de datos:
sin él/ella, el valor de un modelo prototipo, que suele ser un fragmento de código de mala calidad en un archivo de Python, proporcionado por un científico de datos y que de alguna manera produce resultados, tiende a cero.
Sin un ingeniero de datos, ese código nunca se convertirá en un proyecto y ningún problema empresarial se resolverá de manera efectiva. El ingeniero de datos intenta convertir todo esto en un producto.
Lo básico que debe saber un ingeniero de datos
Entonces, si este trabajo despierta en ti una luz y estás lleno de entusiasmo — puedes aprenderlo todo, puedes adquirir todas las habilidades necesarias y convertirte en una verdadera estrella de rock en el desarrollo de datos. Y sí, puedes lograrlo incluso sin habilidades de programación o conocimientos técnicos previos. Es difícil, ¡pero posible!
¿Cuáles son los primeros pasos?
Debes tener una comprensión general de lo que hay.
Primero que nada, la ingeniería de datos se relaciona con la informática. Específicamente, debes entender los algoritmos y estructuras de datos eficientes. En segundo lugar, dado que los ingenieros de datos trabajan con datos, es necesario entender los principios de funcionamiento de las bases de datos y las estructuras subyacentes.
Por ejemplo, las bases de datos SQL comunes B-tree se basan en la estructura de datos B-Tree, así como en los repositorios distribuidos modernos, LSM-Tree y otras modificaciones de tablas hash.
* Estos pasos se basan en un artículo impresionante . Así que si hablas ruso, apoya a este autor y lee .
1. Algoritmos y estructuras de datos
Usar la estructura de datos correcta puede mejorar significativamente el rendimiento del algoritmo. En un mundo ideal, todos deberíamos aprender sobre estructuras de datos y algoritmos en nuestras escuelas, pero rara vez se abordan. De todos modos, nunca es tarde para informarse.
Así que aquí están mis cursos gratuitos favoritos para aprender sobre estructuras de datos y algoritmos:
Además, no olvides el trabajo clásico sobre algoritmos de Thomas Cormen — . Este es un manual perfecto cuando necesitas refrescar tu memoria.
- Para mejorar tus habilidades, utiliza .
También puedes sumergirte en el mundo de las bases de datos con increíbles videos de la Universidad Carnegie Mellon en YouTube:
- .
- .
2. Aprender SQL
Toda nuestra vida son datos. Y para extraer estos datos de la base de datos, necesitas "hablar" con ellos en un mismo idioma.
SQL (Structured Query Language — Lenguaje de Consulta Estructurada) es el lenguaje de comunicación en el ámbito de los datos. Lo que sea que alguien diga, SQL ha vivido, vive y seguirá viviendo por mucho tiempo.
Si has estado en desarrollo por un tiempo, probablemente hayas notado que los rumores sobre la inminente muerte del SQL surgen periódicamente. El lenguaje fue desarrollado a principios de los años 70 y aún goza de una enorme popularidad entre analistas, desarrolladores y simplemente entusiastas.
Sin el conocimiento de SQL, no hay nada que hacer en ingeniería de datos, ya que inevitablemente tendrás que crear consultas para extraer datos. Todos los modernos almacenes de datos masivos soportan SQL:
- Amazon Redshift
- HP Vertica
- Oracle
- SQL Server
… y muchos más.
Para analizar grandes capas de datos almacenados en sistemas distribuidos como HDFS, se han inventado mecanismos SQL: Apache Hive, Impala, etc. Como puedes ver, no va a desaparecer.
¿Cómo aprender SQL? Simplemente hazlo en la práctica.
Para ello, recomendaría consultar un excelente tutorial que, por cierto, es gratuito, de .
Una característica distintiva de estos cursos es la presencia de un entorno interactivo donde puedes escribir y ejecutar consultas SQL directamente en el navegador. El recurso no estará de más. Y puedes aplicar estos conocimientos en en la sección de Bases de datos.
3. Programación en Python y Java/Scala
Ya he escrito sobre por qué deberías aprender el lenguaje de programación Python en el artículo . En lo que respecta a Java y Scala, la mayoría de las herramientas para almacenar y procesar enormes volúmenes de datos están escritas en estos lenguajes. Por ejemplo:
- Apache Kafka (Scala)
- Hadoop, HDFS (Java)
- Apache Spark (Scala)
- Apache Cassandra (Java)
- HBase (Java)
- Apache Hive (Java)
Para entender cómo funcionan estas herramientas, necesitas conocer los lenguajes en los que están escritas. El enfoque funcional de Scala permite abordar eficazmente los problemas de procesamiento paralelo de datos. Python, desafortunadamente, no puede presumir de velocidad y procesamiento paralelo. En general, conocer varios lenguajes y paradigmas de programación influye positivamente en la amplitud de enfoques para resolver problemas.
Para sumergirte en el lenguaje Scala, puedes leer del autor del lenguaje. Además, Twitter ha publicado una buena guía introductoria — .
En cuanto a Python, considero que es el mejor libro de nivel intermedio.
4. Herramientas para trabajar con grandes datos
Aquí tienes una lista de las herramientas más populares en el mundo de los grandes datos:
- Apache Spark
- Apache Kafka
- Apache Hadoop (HDFS, HBase, Hive)
- Apache Cassandra
Puedes encontrar más información sobre la construcción de grandes bloques de datos en este sorprendente . Las herramientas más populares son Spark y Kafka. Definitivamente vale la pena estudiarlas, preferiblemente entender cómo funcionan por dentro. Jay Kreps (coautor de Kafka) publicó en 2013 un trabajo monumental , por cierto, las ideas principales de este talmud se utilizaron para crear Apache Kafka.
- La introducción a Hadoop puede ser .
- Para mí, la guía más completa sobre Apache Spark es .
5. Plataformas en la nube
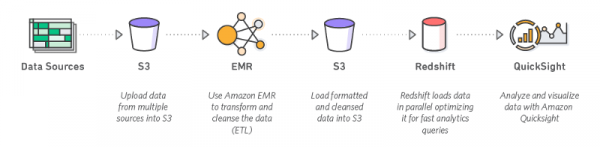
Conocer al menos una plataforma en la nube está en la lista de requisitos básicos para los solicitantes de empleo como ingenieros de datos. Los empleadores prefieren Amazon Web Services, en segundo lugar se encuentra la plataforma en la nube de Google, y en tercer lugar Microsoft Azure.
Debes tener un buen conocimiento de Amazon EC2, AWS Lambda, Amazon S3, DynamoDB.
6. Sistemas distribuidos
Trabajar con grandes datos implica la existencia de clústeres de computadoras que operan independientemente, cuyas conexiones se realizan a través de una red. Cuanto mayor es el clúster, mayor es la probabilidad de fallo de sus nodos miembros. Para convertirte en un experto destacado en el área de datos, necesitas profundizar en los problemas y soluciones existentes para sistemas distribuidos. Este campo es antiguo y complejo.
Andrew Tanenbaum es considerado un pionero en este campo. Para aquellos que no temen a la teoría, recomiendo su libro , para principiantes puede parecer complicado, pero realmente te ayudará a perfeccionar tus habilidades.
Yo creo que es el mejor libro introductorio. Por cierto, Martin tiene un maravilloso . Su trabajo ayudará a sistematizar el conocimiento sobre la construcción de infraestructura moderna para el almacenamiento y procesamiento de grandes datos.
Para aquellos que disfrutan ver videos, hay un curso en Youtube .
7. Canalizaciones de datos
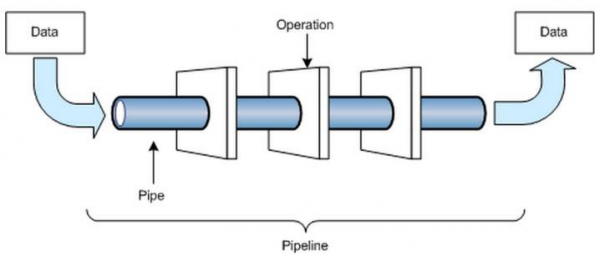
Las canalizaciones de datos son algo de lo que no puedes prescindir como ingeniero de datos.
La mayor parte del tiempo, el ingeniero de datos construye lo que se llama una canalización de datos, es decir, crea un proceso para transportar datos de un lugar a otro. Esto puede incluir flujos de usuario que se dirigen a la API de un servicio externo o realizan consultas SQL, complementan los datos y los colocan en un almacenamiento centralizado (almacenamiento de datos) o en un almacenamiento de datos no estructurados (lagos de datos).
En resumen: la lista de verificación principal para un ingeniero de datos
Para resumir, es necesario tener un buen entendimiento de lo siguiente:
- Sistemas de información;
- Desarrollo de software (Agile, DevOps, Técnicas de diseño, SOA);
- Sistemas distribuidos y programación paralela;
- Fundamentos de bases de datos — planificación, diseño, operación y solución de problemas;
- Diseño de experimentos — pruebas A/B para probar conceptos, determinar confiabilidad, rendimiento de sistemas, así como para desarrollar caminos fiables para la entrega oportuna de buenas soluciones.
Estos son solo algunos de los requisitos para convertirse en ingeniero de datos, así que estudia y familiarízate con sistemas de datos, sistemas de información, entrega continua/despliegue/integración, lenguajes de programación y otros temas de informática (no en todas las áreas temáticas).
Y, por último, pero no menos importante, lo que quiero decir.
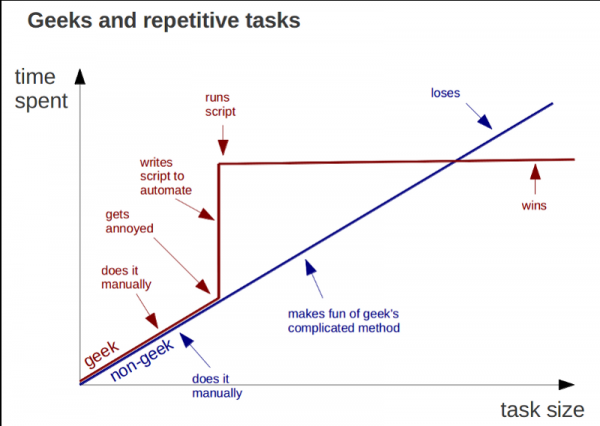
El camino para convertirse en Data Engineer no es tan sencillo como parece. No perdona, frustra, y debes estar preparado para ello. Algunos momentos en este viaje pueden llevarte a considerar todo dejar. Pero es un verdadero esfuerzo y un proceso de aprendizaje.
Simplemente no lo adores desde el principio. Todo el sentido del viaje es aprender lo más posible y estar preparado para nuevos desafíos.
Aquí hay una excelente imagen con la que me encontré, que ilustra bien este punto:
Y sí, no olvides evitar el agotamiento y descansar. También es muy importante. ¡Buena suerte!
¿Qué les parece el artículo, amigos? Los invitamos a , que se llevará a cabo hoy a las 20:00. En el marco del webinar, discutiremos cómo construir un sistema eficiente y escalable de procesamiento de datos para una pequeña empresa o startup con costos mínimos. Como práctica, nos familiarizaremos con las herramientas de procesamiento de datos de Google Cloud. ¡Hasta pronto!
Fuente: habr.com
