

En este momento, el tema de DevOps está en auge. La canalización de integración y entrega continua es implementada por todos los que pueden. Pero la mayoría no siempre presta la debida atención a garantizar la fiabilidad de los sistemas de información en las diferentes etapas del CI/CD Pipeline. En este artículo, me gustaría hablar sobre mi experiencia en la automatización de las verificaciones de calidad del software y en la implementación de posibles escenarios para su «autorreparación».
Trabajo como ingeniero en el departamento de gestión de servicios de TI en la empresa . Mi área de especialización es la implementación de diversos sistemas de monitoreo del rendimiento y la disponibilidad de aplicaciones. A menudo me comunico con clientes de TI de diferentes segmentos del mercado sobre cuestiones relevantes relacionadas con la supervisión de la calidad de sus servicios de TI. La tarea principal es minimizar el tiempo del ciclo de lanzamiento y aumentar la frecuencia de sus despliegues. Esto, por supuesto, suena bien: más lanzamientos, más nuevas funciones, más usuarios satisfechos, más ganancias. Pero en la práctica, no siempre todo resulta bien. Con tasas de implementación muy altas, surge inmediatamente la cuestión de la calidad de nuestros lanzamientos. Incluso con una canalización completamente automatizada, uno de los mayores problemas es la transición de los servicios de prueba a producción, sin afectar el tiempo de operación continua y la interacción de los usuarios con la aplicación.
A partir de numerosas conversaciones con los clientes, puedo decir que el control de calidad de los lanzamientos, la fiabilidad de la aplicación y la posibilidad de su «autorreparación» (por ejemplo, revertir a una versión estable) en varias etapas de la canalización CI/CD son algunos de los temas más preocupantes y relevantes.
Recientemente, trabajé del lado del cliente, en el servicio de soporte de software de un banco en línea. En la arquitectura de nuestra aplicación se utilizaba una gran cantidad de microservicios personalizados. Lo más triste es que no todos los desarrolladores se enfrentaban al ritmo acelerado de desarrollo; la calidad de algunos microservicios se veía afectada, lo que generó apodos graciosos para ellos y sus creadores. Aparecieron anécdotas sobre con qué materiales se crean estos productos.
«Planteamiento del problema»
La alta frecuencia de lanzamientos y el gran número de microservicios dificultan la comprensión del funcionamiento de la aplicación en su conjunto, tanto en la fase de pruebas como en la de explotación. Los cambios ocurren constantemente y controlar estos sin buenas herramientas de monitoreo es muy difícil. A menudo, después de un lanzamiento nocturno, por la mañana los desarrolladores se sientan como sobre un barril de pólvora, esperando que nada se rompa, aunque en la fase de pruebas todas las verificaciones fueron exitosas.
Hay otro aspecto a considerar. En la etapa de pruebas se verifica la funcionalidad del software: el cumplimiento de las funciones principales de la aplicación y la ausencia de errores. Las evaluaciones de calidad de rendimiento son escasas o no tienen en cuenta todos los aspectos del funcionamiento de la aplicación y la capa de integración. Algunas métricas pueden no ser verificadas en absoluto. Como resultado, cuando se produce una falla en el entorno productivo, el departamento de soporte técnico se entera únicamente cuando los usuarios reales comienzan a quejarse. Se desea minimizar el impacto del software de baja calidad en los usuarios finales.
Una de las soluciones es implementar procesos de verificación de calidad del software en varias etapas del Pipeline de CI/CD, añadiendo distintos escenarios para la recuperación del sistema en caso de fallos. También recordemos que tenemos DevOps. El negocio espera recibir el nuevo producto lo más rápido posible. Por lo tanto, todas nuestras verificaciones y escenarios deben ser automatizados.
La tarea se divide en dos componentes:
- control de calidad de las compilaciones en la fase de pruebas (automatizar el proceso de detección de compilaciones defectuosas);
- control de calidad del software en el entorno de producción (mecanismos de detección automática de problemas y posibles escenarios para su auto-reparación).
Herramienta para monitoreo y recopilación de métricas
Para realizar las tareas establecidas, se requiere un sistema de monitoreo capaz de detectar problemas y transmitirlos a los sistemas de automatización en las diferentes etapas del pipeline de CI/CD. También será positivo si este sistema proporciona métricas útiles para varios equipos: desarrollo, pruebas, explotación. Y sería aún mejor si también beneficia al negocio.
Para la recopilación de métricas, se puede utilizar una combinación de diferentes sistemas (Prometheus, ELK Stack, Zabbix, etc.), pero, en mi opinión, las soluciones de clase APM son las más adecuadas para estas tareas (), que pueden simplificar mucho su vida.
En el marco de mi trabajo en el servicio de soporte, comencé a desarrollar un proyecto similar utilizando la solución de clase APM de la empresa Dynatrace. Ahora, trabajando en un integrador, conozco bastante bien el mercado de sistemas de monitoreo. Mi opinión subjetiva: Dynatrace es la mejor opción para resolver tales problemas.
La solución de Dynatrace ofrece una representación horizontal de cada operación del usuario con un alto grado de detalle hasta el nivel de ejecución del código. Se puede rastrear toda la cadena de interacción entre diversos servicios de información: desde los niveles de aplicaciones web y móviles frontend, servidores de aplicaciones backend, hasta la bus de integración y la llamada específica a la base de datos.
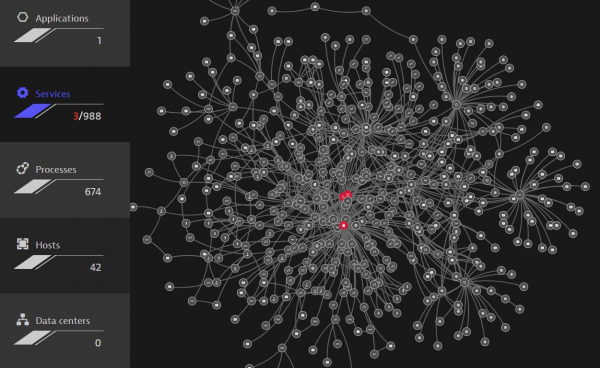 . Construcción automática de todas las dependencias entre los componentes del sistema
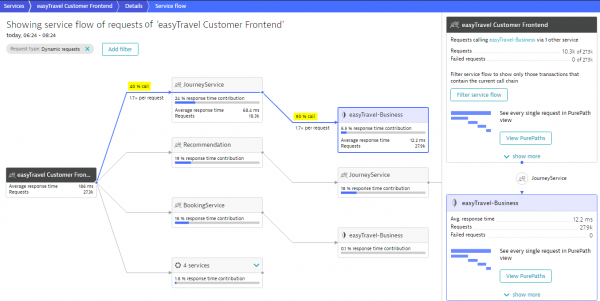 . Detección automática y construcción de la ruta de ejecución de la operación del servicio
También recordemos que es necesario integrarse con diversas herramientas de automatización. Aquí la solución cuenta con una API conveniente que permite enviar y recibir diferentes métricas y eventos.
A continuación, pasaremos a un análisis más detallado de cómo resolver las tareas planteadas utilizando el sistema Dynatrace.
Tarea 1. Automatización del control de calidad de las compilaciones en la etapa de pruebas
La primera tarea es identificar problemas lo antes posible en las etapas del pipeline de entrega de la aplicación. Solo las compilaciones "buenas" de código deben llegar al entorno de producción. Para ello, en su pipeline, en la etapa de pruebas, deben incluirse monitores adicionales para verificar la calidad de sus servicios.
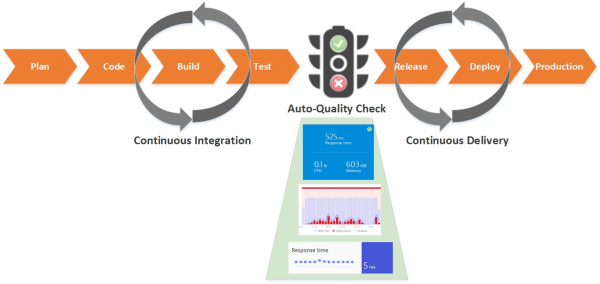
Veamos paso a paso cómo implementar y automatizar este proceso:
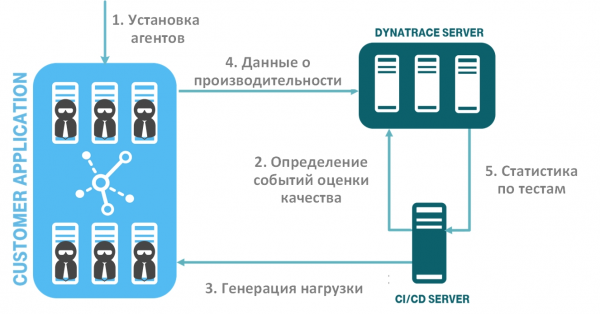
En la imagen se muestra el flujo de pasos automatizados para la verificación de la calidad del software:
- despliegue del sistema de monitoreo (instalación de agentes);
- definición de eventos de evaluación de calidad de su software (métricas y umbrales) y su transmisión al sistema de monitoreo;
- generación de carga y pruebas de rendimiento;
- recopilación de datos sobre rendimiento y disponibilidad en el sistema de monitoreo;
- transferencia de datos sobre pruebas basadas en eventos de evaluación de la calidad del software, del sistema de monitoreo al sistema CI/CD. Análisis automático de las compilaciones.
Paso 1. Despliegue del sistema de monitoreo
Primero, debe instalar agentes en su entorno de pruebas. La solución de Dynatrace tiene una característica agradable: utiliza un agente universal, OneAgent, que se instala en la instancia del sistema operativo (Windows, Linux, AIX), detecta automáticamente sus servicios y comienza a recopilar datos de monitoreo. No necesita configurar un agente separado para cada proceso. Lo mismo sucede con plataformas en la nube y contenedores. Además, puede automatizar el proceso de instalación de agentes. Dynatrace se integra perfectamente con el concepto de “infraestructura como código” (): ya hay scripts e instrucciones disponibles para todas las plataformas populares. Integra el agente en la configuración de su servicio, y al desplegarlo, obtiene inmediatamente un nuevo servicio con el agente en funcionamiento.
Paso 2. Definición de eventos de evaluación de la calidad de su software
Ahora debe determinar el listado de servicios y operaciones comerciales. Es importante considerar precisamente aquellas operaciones de los usuarios que son críticas para su servicio. Aquí recomiendo consultar con analistas de negocio y sistemas.
A continuación, debe definir qué métricas desea incluir en la verificación para cada uno de los niveles. Por ejemplo, esto puede incluir el tiempo de ejecución (con desglose en promedio, mediana, percentiles, etc.), errores (lógicos, de servicio, infraestructurales, etc.) y diversas métricas infraestructurales (memory heap, garbage collector, conteo de hilos, etc.).
Para automatización y facilidad de uso, aparece el concepto de “Monitoreo como código” para el equipo de DevOps. Lo que quiero decir con esto es que un desarrollador/tester puede escribir un simple archivo JSON que defina las métricas de evaluación de la calidad del software.
Veamos un ejemplo de tal archivo JSON. Se utilizan objetos de la API de Dynatrace como pares clave/valor (puede ver la descripción de la API aquí ).
{
    "timeseries": [
    {
      "timeseriesId": "service.ResponseTime",
      "aggregation": "avg",
      "tags": "Frontend",
      "severe": 250000,
      "warning": 1000000
    },
    {
      "timeseriesId": "service.ResponseTime ",
      "aggregation": "avg",
      "tags": "Backend",
      "severe": 4000000,
      "warning": 8000000
    },
    {
      "timeseriesId": "docker.Container.Cpu",
      "aggregation": "avg",
      "severe": 50,
      "warning": 70
    }
  ]
}
El archivo es un arreglo de definiciones de series de tiempo (timeseries):
- timeseriesId – métrica que se está monitoreando, por ejemplo, Tiempo de Respuesta, Conteo de Errores, Memoria Usada, etc.;
- aggregation — nivel de agregación de las métricas, en nuestro caso avg, pero puedes usar cualquier nivel que necesites (avg, min, max, sum, count, percentile);
- tags – etiqueta del objeto en el sistema de monitoreo, o puedes especificar un identificador específico del objeto;
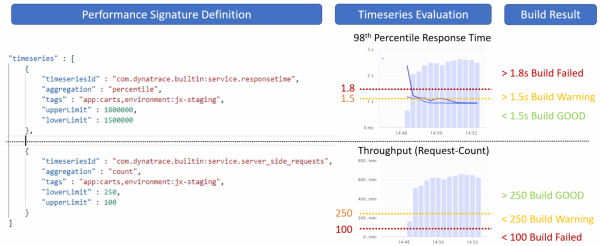
- severe y warning – estos indicadores regulan los valores umbrales de nuestras métricas; si el valor de las pruebas supera el umbral severe, entonces nuestra ejecución se marca como fallida.
En la siguiente imagen se presenta un ejemplo de uso de estos umbrales.
Paso 3. Generación de carga
Después de que se han definido los niveles de calidad de nuestro servicio, es necesario generar una carga de prueba. Puedes usar cualquiera de las herramientas de prueba que te resulten cómodas, como Jmeter, Selenium, Neotys, Gatling, etc.
El sistema de monitoreo Dynatrace permite capturar varios metadatos de tus pruebas y reconocer a qué ciclo de lanzamiento y servicio pertenece cada prueba. Se recomienda agregar encabezados adicionales a las solicitudes HTTP de la prueba.
En la siguiente imagen se presenta un ejemplo donde, mediante el encabezado adicional X-Dynatrace-Test, marcamos que esta prueba se refiere a la prueba de la operación de agregar un producto al carrito.
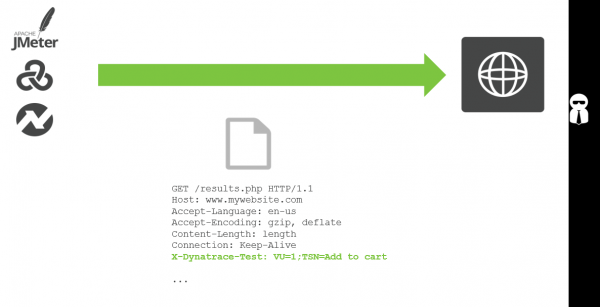
Al iniciar cada prueba de carga, envías información contextual adicional a Dynatrace mediante la API de eventos desde el servidor CI/CD. Así, el sistema puede diferenciar entre distintas pruebas.
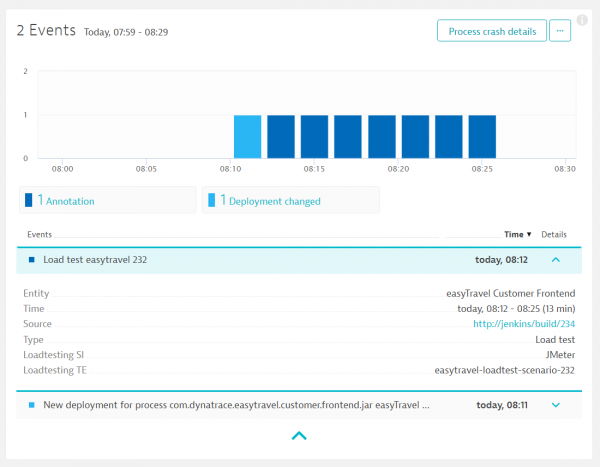 . Evento en el sistema de monitoreo sobre el inicio de la prueba de carga
Paso 4-5. Recolección de datos de rendimiento y envio de datos al sistema CI/CD
Junto con la prueba generada, se envía al sistema de monitoreo un evento sobre la necesidad de recolectar datos de revisión de los indicadores de calidad del servicio. También se especifica nuestro archivo JSON, en el que se definen las métricas clave.
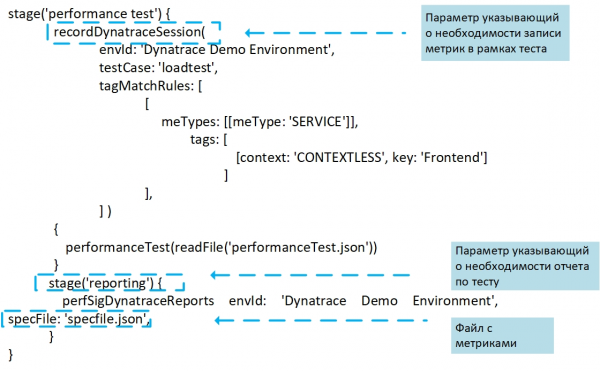 Un evento que indica la necesidad de verificar la calidad del software generado en el servidor CI/CD para enviarlo al sistema de monitoreo.
En nuestro ejemplo, el evento de verificación de calidad se llama perfSigDynatraceReport (Performance_Signature) – es una integración lista para ser utilizada con Jenkins, desarrollada por el equipo de T-Systems Multimedia Solutions. Cada evento de inicio de verificación contiene información sobre el servicio, el número de compilación y el tiempo de prueba. El complemento recopila los valores de rendimiento durante la compilación, los evalúa y compara el resultado con las compilaciones anteriores y los requisitos no funcionales.
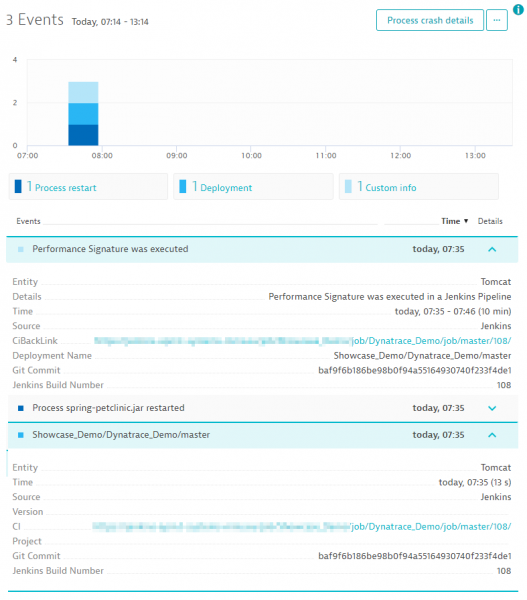 Evento en el sistema de monitoreo sobre el inicio de la verificación de calidad de la compilación.
Al finalizar la prueba, todas las métricas de evaluación de la calidad del software se envían de nuevo al sistema de integración continua, como Jenkins, que genera un informe sobre los resultados.
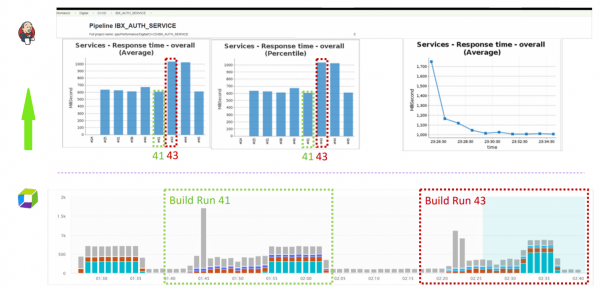 Resultado de la estadística de las compilaciones en el servidor CI/CD.
Para cada compilación individual, vemos estadísticas para cada métrica definida por nosotros durante la ejecución de toda la prueba. También podemos ver si hubo violaciones en ciertos valores de umbral (advertencias y umbrales críticos). Basado en estos indicadores, toda la compilación se clasifica como estable, inestable o fallida. Además, para mayor comodidad, se puede añadir al informe indicadores que comparen la compilación actual con la anterior.
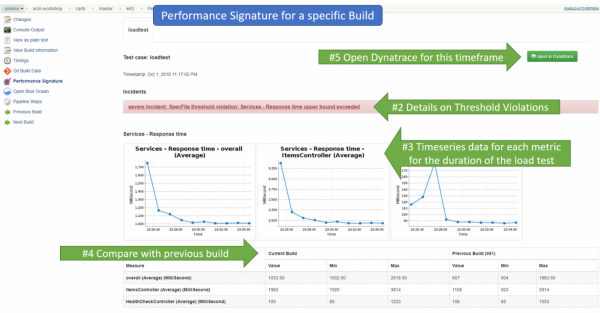 Visualización de estadísticas detalladas sobre las compilaciones en el servidor CI/CD.
Comparación detallada de dos compilaciones.
Si es necesario, se puede acceder a la interfaz de Dynatrace y allí revisar más detenidamente las estadísticas de cada compilación y compararlas entre sí.
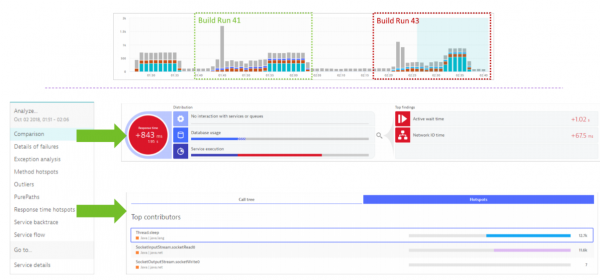 Comparación de estadísticas de compilaciones en Dynatrace.
Conclusiones
En consecuencia, obtenemos un servicio de 'monitoreo como servicio', automatizado en el flujo de integración continua. El desarrollador o tester solo necesita definir la lista de métricas en un archivo JSON, y todo lo demás ocurre automáticamente. Obtenemos un control de calidad transparente sobre los lanzamientos: todas las notificaciones sobre rendimiento, consumo de recursos o regresiones arquitectónicas.
Tarea 2. Automatización del control de calidad del software en un entorno de producción.
Así que hemos resuelto la tarea de cómo automatizar el proceso de monitoreo en la etapa de prueba en el Pipeline. De esta manera, minimizamos el porcentaje de compilaciones defectuosas que llegan al entorno de producción.
Pero, ¿qué hacer si un software defectuoso llega a producción, o si simplemente algo falla? En nuestra utopía, nos gustaría que existieran mecanismos de detección automática de problemas y que, si es posible, el sistema restaurara su funcionalidad por sí mismo, al menos durante la noche.
Para ello, necesitamos, de manera análoga a la sección anterior, prever controles automáticos de calidad del software en el entorno de producción y desarrollar para ellos escenarios de autorrecuperación del sistema.
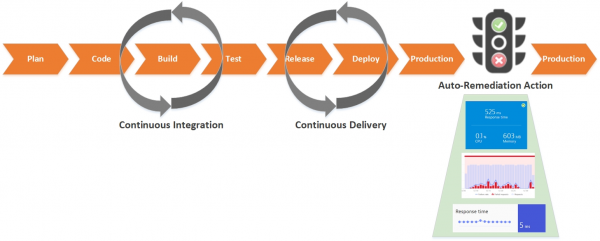
Autocorrección como código
En la mayoría de las empresas ya existe una base de conocimientos acumulada sobre diversos tipos de problemas comunes y una lista de acciones para su corrección, como reiniciar procesos, limpiar recursos, revertir versiones, restaurar cambios de configuración incorrectos, aumentar o disminuir la cantidad de componentes en el clúster, cambiar entre el entorno azul o verde, entre otros.
A pesar de que estas opciones han sido conocidas durante muchos años por muchos equipos con los que hablo, pocos han considerado y han invertido en su automatización.
Si lo pensamos, no hay nada de complejo en la implementación de procesos de autorrecuperación de la funcionalidad de la aplicación; es necesario presentar los escenarios de trabajo de sus administradores ya conocidos en forma de códigos (la concepción de «autocorrección como código»), que usted ha preparado previamente para cada caso específico. Los escenarios de corrección automática deben estar dirigidos a eliminar la causa raíz del problema. Usted establece las acciones correctas en respuesta al incidente.
Cualquier métrica de su sistema de monitoreo puede servir como desencadenante para iniciar el escenario, siempre y cuando estas métricas definan con precisión que algo está mal, ya que no querríamos tener falsas alarmas en el entorno de producción.
Puede utilizar cualquier sistema o una combinación de sistemas: Prometheus, ELK Stack, Zabbix, etc. Pero daré algunos ejemplos basados en la solución APM (nuevamente usaremos Dynatrace como ejemplo), que también ayudará a facilitar su trabajo.
En primer lugar, aquí está todo lo relacionado con la funcionalidad desde el punto de vista del funcionamiento de la aplicación. La solución ofrece cientos de métricas en varios niveles, que puede utilizar como desencadenantes:
- nivel de usuarios (navegadores, aplicaciones móviles, dispositivos IoT, comportamiento del usuario, conversión, etc.);
- nivel de servicio y operaciones (rendimiento, disponibilidad, errores, etc.);
- nivel de infraestructura de la aplicación (métricas del sistema operativo del host, JMX, MQ, servidor web, etc.);
- nivel de plataformas (virtualización, nube, contenedor, etc.).
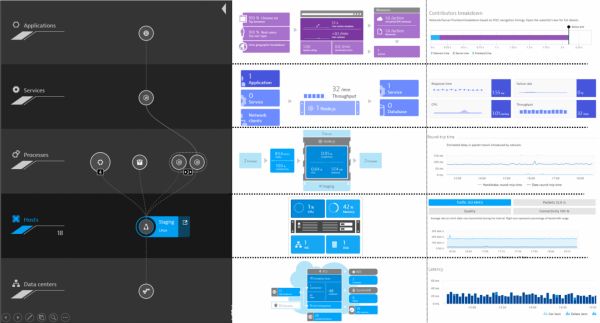 Niveles de monitoreo en Dynatrace.
En segundo lugar, como mencioné anteriormente, Dynatrace tiene una API abierta que permite integrarlo de manera muy conveniente con varios sistemas de terceros. Por ejemplo, enviar una notificación al sistema de automatización al exceder parámetros de control.
A continuación, se muestra un ejemplo de interacción con Ansible.
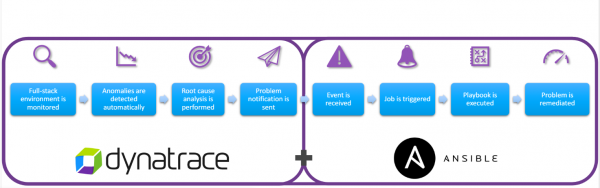
A continuación, daré algunos ejemplos de las automatizaciones que se pueden realizar. Esta es solo una parte de los casos, su lista en su entorno puede limitarse solo por su imaginación y las capacidades de sus herramientas de monitoreo.
1. Deploy fallido – revertir versión
Incluso si revisamos todo muy bien en el entorno de pruebas, siempre existe la posibilidad de que una nueva versión pueda afectar negativamente su aplicación en producción. El factor humano no se puede desestimar.
En la siguiente figura, vemos que hay un salto brusco en el tiempo de ejecución de las operaciones en el servicio. El inicio de este salto coincide con el momento del despliegue en la aplicación. Pasamos toda esta información como eventos al sistema de automatización. Si la funcionalidad del servicio no se normaliza después del tiempo que hemos establecido, se ejecuta automáticamente un script que revierte la versión a la anterior.
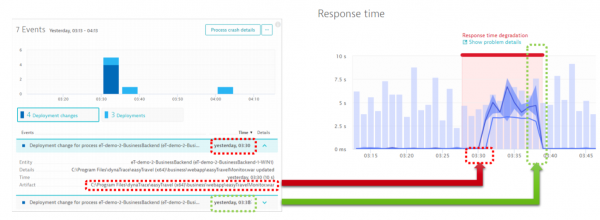 Degradación del rendimiento de las operaciones después del despliegue.
2. Carga de recursos al 100% – agregar nodo a la red
En el siguiente ejemplo, el sistema de monitoreo determina que uno de los componentes está mostrando una carga de CPU del 100%.
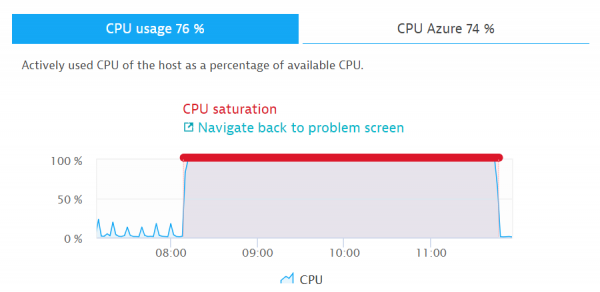 Carga de CPU del 100%
Para este evento pueden existir varios escenarios diferentes. Por ejemplo, el sistema de monitoreo verifica adicionalmente si la falta de recursos está relacionada con un aumento de carga en el servicio. Si es así, se ejecuta un script que agrega automáticamente un nodo a la red, restaurando así la funcionalidad del sistema en su conjunto.
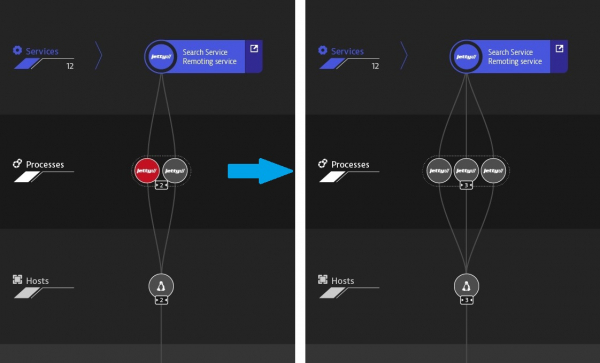 Escalamiento posterior a un incidente
3. Falta de espacio en el disco duro – limpieza del disco
Creo que muchos ya han automatizado estos procesos. Con APM también se puede supervisar el espacio libre en el subsistema de disco. En caso de falta de espacio o un rendimiento lento del disco, se puede ejecutar un script para limpiar o añadir espacio.
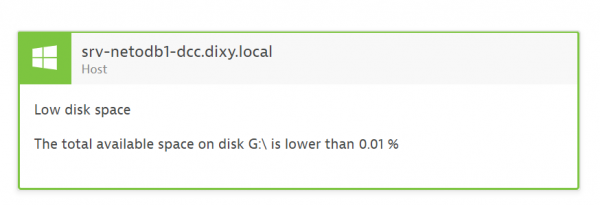
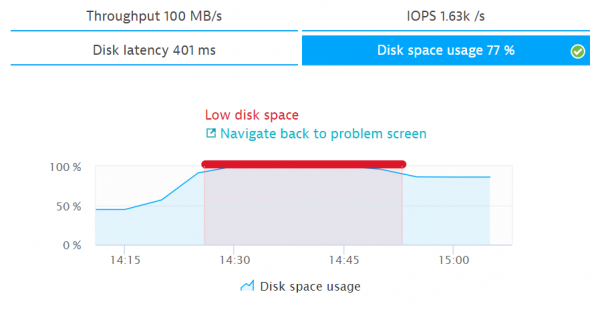 Uso del disco 100%
4. Baja actividad de los usuarios o baja conversión – cambio entre la rama azul y la verde
A menudo me encuentro con clientes que utilizan dos ramas (despliegue azul-verde) para aplicaciones en producción. Esto permite cambiar rápidamente entre ramas al implementar nuevas versiones. A menudo, después de un despliegue, pueden ocurrir cambios drásticos que no se notan de inmediato. Sin embargo, la degradación del rendimiento y la disponibilidad puede no ser observable. Para una respuesta rápida a tales cambios, es mejor utilizar diferentes métricas que reflejen el comportamiento de los usuarios (número de sesiones y acciones de los usuarios, conversión, tasa de rebote). En la siguiente imagen se muestra un ejemplo, donde al caer la conversión se produce un cambio entre las ramas de la aplicación.
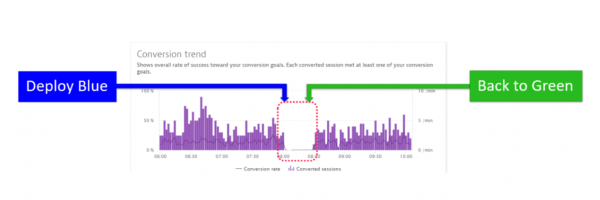 Caída de conversión tras el cambio entre ramas de la aplicación.
Mecanismos de detección automática de problemas
Al final, daré otro ejemplo de por qué me gusta tanto Dynatrace.
En la parte de mi discurso sobre la automatización de la verificación de calidad de las compilaciones en el entorno de prueba, todos los umbrales se definieron manualmente. Para un entorno de prueba, esto es normal; el tester determina los indicadores antes de cada verificación según la carga. En un entorno de producción, es deseable que los problemas se detecten automáticamente, teniendo en cuenta varios mecanismos de referencia.
Dynatrace cuenta con interesantes herramientas de inteligencia artificial integradas que, basándose en mecanismos de detección de métricas anómalas (baselining) y construyendo un mapa de interacción entre todos los componentes, comparando y correlacionando eventos entre sí, identifican anomalías en el funcionamiento de su servicio y proporcionan información detallada sobre cada problema y su causa raíz.
A través del análisis automático de las dependencias entre los componentes, Dynatrace no solo determina si el servicio problemático es la causa raíz, sino también su dependencia de otros servicios. En el ejemplo a continuación, Dynatrace realiza un seguimiento y evalúa automáticamente el rendimiento de cada servicio durante la ejecución de transacciones, identificando el servicio Golang como la causa principal.
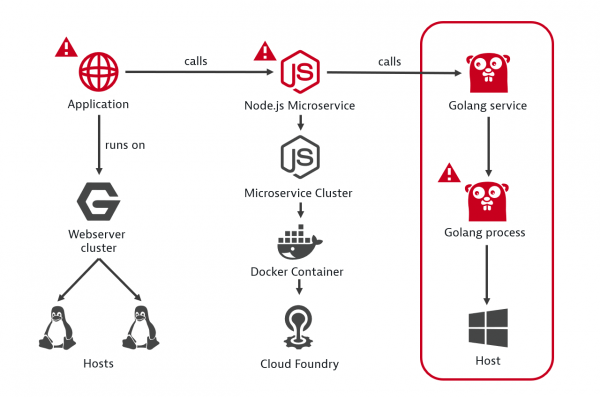 Ejemplo de identificación de la causa raíz de una falla.
En la siguiente figura se muestra el proceso de monitoreo de problemas con su aplicación desde el inicio del incidente.
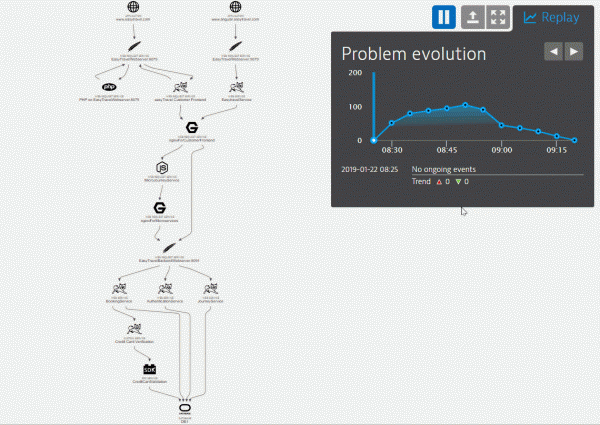 Visualización del problema que surge mostrando todos los componentes y los eventos sobre ellos.
El sistema de monitoreo recopiló una cronología completa de eventos relacionados con el problema. En la ventana debajo del gráfico temporal, vemos todos los eventos clave en cada uno de los componentes. Basado en estos eventos, puede establecer procedimientos para la corrección automática en forma de scripts de código.
Además, recomiendo integrar el sistema de monitoreo con Service Desk o un rastreador de errores. Cuando surja un problema, los desarrolladores obtienen rápidamente toda la información necesaria para su análisis a nivel de código en el entorno de producción.
Conclusión
Como resultado, tenemos un canal CI/CD con verificaciones de calidad de software automatizadas integradas en el Pipeline. Minimizamos la cantidad de versiones de baja calidad, mejoramos la confiabilidad del sistema en su conjunto y, si la operatividad del sistema se ve afectada, activamos mecanismos para su recuperación.
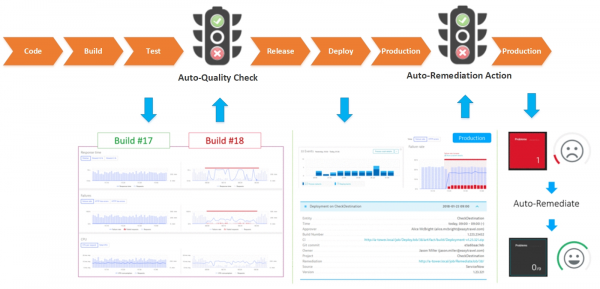
Definitivamente vale la pena invertir esfuerzos en la automatización del monitoreo de la calidad del software. No siempre es un proceso rápido, pero con el tiempo dará sus frutos. Recomiendo que, después de resolver un nuevo incidente en el entorno de producción, piense de inmediato en qué monitores agregar para revisiones en el entorno de prueba para evitar que una mala versión llegue a producción, así como elaborar un script para la corrección automática de esos problemas.
Espero que mis ejemplos les ayuden en sus esfuerzos. También me interesaría ver sus ejemplos de métricas utilizadas para implementar la autorrecuperación de la operatividad de los sistemas.
Fuente: habr.com
