

Hoy en día, se requiere una alta disponibilidad de servicios siempre y en todas partes, no solo en grandes proyectos costosos. Los sitios temporalmente fuera de servicio con el mensaje "Lo siento, estamos realizando mantenimiento técnico" todavía aparecen, pero generalmente provocan una sonrisa condescendiente. A esto se suma la vida en la nube, donde para iniciar un servidor adicional solo se necesita una llamada a la API, sin necesidad de preocuparse por la explotación "en hardware". Y ya no hay excusas para que un sistema crítico no se haga de manera confiable utilizando tecnologías de clúster y redundancia.
Compartiremos las soluciones que consideramos para garantizar la fiabilidad de las bases de datos en nuestros servicios y a qué conclusiones llegamos. Además, habrá una demostración con conclusiones de largo alcance.
Legado en la arquitectura de alta disponibilidad
Esto se ve aún mejor a través del desarrollo de varios sistemas de código abierto. Las soluciones antiguas tuvieron que agregar tecnologías de alta disponibilidad a medida que aumentaba la demanda. Y la calidad de estas fue variable. Las soluciones de nueva generación ponen la alta disponibilidad en el núcleo de su arquitectura. Por ejemplo, MongoDB posiciona el clúster como la opción principal de uso. El clúster se escala horizontalmente, lo que constituye una gran ventaja competitiva de esta base de datos.
Regresando a PostgreSQL. Este es uno de los proyectos de código abierto más antiguos y populares, cuyo primer lanzamiento se realizó en 1995. El equipo del proyecto durante mucho tiempo no consideró que la alta disponibilidad fuera una tarea que debía resolverse desde el sistema. Por ello, la tecnología de replicación para crear copias de datos solo se integró en la versión 8.2 en 2006, aunque era una replicación basada en archivos (log shipping). En 2010, la versión 9.0 introdujo la replicación en streaming, que es la base para crear diversos clústeres. Esto, de hecho, sorprende a las personas que se familiarizan con PostgreSQL después de Enterprise SQL o modernas NoSQL, ya que la solución estándar de la comunidad es simplemente un par de master-replica con replicación síncrona o asíncrona. Mientras tanto, en el stock, el cambio de maestro se realiza manualmente, y la cuestión del cambio de clientes también se sugiere resolver de forma independiente.
Cómo decidimos hacer un PostgreSQL confiable y qué elegimos para ello
Sin embargo, PostgreSQL no se habría vuelto tan popular si no fuera por la gran cantidad de proyectos y herramientas que ayudan a construir soluciones resilientes que no requieren atención constante. En la nube desde su lanzamiento, DBaaS ha ofrecido servidores individuales de PostgreSQL y pares de maestro-replicador con replicación asíncrona.
Por supuesto, queríamos simplificar la vida a todos y hacer accesible una instalación de PostgreSQL que pudiera servir como base para servicios de alta disponibilidad, sin necesidad de estar revisando constantemente y despertarse en medio de la noche para hacer un cambio. En este segmento hay tanto soluciones probadas como una nueva generación de utilidades que utilizan los últimos avances.
Hoy en día, el problema de alta disponibilidad no se centra en la redundancia (eso es obvio), sino en el consenso: el algoritmo de elección de líder. A menudo, las grandes fallas no ocurren por falta de servidores, sino por problemas de consenso: no se eligió un nuevo líder, hubo dos líderes en diferentes centros de datos, etc. Un ejemplo es la falla en el clúster MySQL de Github, que escribieron .
La base matemática de esta cuestión es muy sólida. Por un lado, existe la , que impone limitaciones teóricas sobre las posibilidades de construir soluciones de HA, y por otro lado, algoritmos matemáticamente probados para la determinación de consenso, tales como y . Basado en esto, existen sistemas DCS (sistemas de consenso descentralizado) bastante populares, como Zookeeper, etcd, Consul. Por lo tanto, si un sistema de toma de decisiones opera con un algoritmo propio, escrito de manera independiente, se debe tener mucho cuidado con él. Después de analizar una gran cantidad de sistemas, nos decidimos por Patroni, un sistema de código abierto, desarrollado en su mayoría por la empresa Zalando.
Como un pequeño desvío lírico, diré que también consideramos soluciones multi-master, es decir, clústeres que se pueden escalar horizontalmente en escritura. Sin embargo, decidimos no implementar tal clúster por dos razones principales. En primer lugar, tales soluciones tienen una alta complejidad y, en consecuencia, más puntos vulnerables. Será difícil crear una solución estable para todos los casos. En segundo lugar, en ese caso, PostgreSQL deja de ser puro (nativo), algunas funciones no estarán disponibles y algunas aplicaciones pueden experimentar errores ocultos durante su funcionamiento.
Patroni
Entonces, ¿cómo funciona Patroni? Los desarrolladores no se complicaron la vida y propusieron utilizar una de las soluciones DCS comprobadas como base. Se les encomiendan todas las cuestiones relacionadas con la sincronización de configuraciones, la elección de un líder y el quórum. Elegimos para ello etcd.
A continuación, Patroni se encarga de aplicar correctamente todas las configuraciones en PostgreSQL y de los ajustes de replicación, así como de la ejecución de comandos para switchover y failover (es decir, el cambio normal y el cambio de emergencia del maestro). Específicamente en la nube MCS, se puede crear un clúster con un maestro, una réplica síncrona y una o varias réplicas asíncronas. La presencia de una réplica síncrona garantiza la seguridad de los datos en al menos 2 servidores, y esta réplica será el principal "candidato a maestro".
Dado que etcd se despliega en los mismos servidores, se recomienda un número de 3 o 5 servidores para un valor óptimo de quórum. Este clúster se escala horizontalmente en lectura (ya escribí anteriormente sobre la escalabilidad en escritura). Sin embargo, se debe tener en cuenta que las réplicas asíncronas tienden a retrasarse, especialmente bajo altas cargas.
El uso de tales réplicas en lectura (hot standby) es válido para tareas de informes o análisis y descarga al servidor maestro.
Si desea crear un clúster de este tipo por su cuenta, necesitará:
- preparar 3 o más servidores, configurar la dirección IP y las reglas de firewall entre ellos;
- instalar paquetes para los servicios etcd, Patroni, PostgreSQL;
- configurar el clúster etcd;
- configurar el servicio patroni para trabajar con PostgreSQL.
Es decir, en total hay que elaborar correctamente una decena de archivos de configuración y no cometer errores. Para ello, definitivamente vale la pena usar una herramienta de gestión de configuración, como Ansible, por ejemplo. Sin embargo, aquí sigue faltando un balanceador TCP de alta disponibilidad. Hacerlo es un trabajo aparte.
Para aquellos que necesitan un clúster listo, pero no quieren lidiar con todo esto, nos esforzamos por simplificar la vida y creamos un clúster listo en Patroni en nuestra nube, que se puede probar gratis. Además del propio clúster, hemos creado:
- Un balanceador TCP; él siempre apunta al maestro actual a través de diferentes puertos, a la réplica sincrónica o asincrónica, respectivamente;
- Una API para cambiar el maestro activo de Patroni.
Se pueden conectar tanto a través de la API de la nube MCS como de la consola web.
Demo
Para probar las capacidades del clúster de PostgreSQL en la nube MCS, veamos cómo se comporta una aplicación en vivo al enfrentar problemas con la base de datos.
A continuación se presenta el código de la aplicación, que registrará eventos artificiales y los mostrará en pantalla. En caso de errores, lo comunicará y continuará funcionando en un ciclo, hasta que lo detengamos con la combinación Ctrl + C.
from __future__ import print_function

from datetime import datetime
from random import randint
from time import sleep
import psycopg2


def main():
    try:
        connection = psycopg2.connect(user = "admin",
                                      password = "P@ssw0rd",
                                      host = "89.208.87.38",
                                      port = "5432",
                                      database = "myproddb")

        cursor = connection.cursor()
        cursor.execute("SELECT version();")
        record = cursor.fetchone()
        print("Conexión establecida a", record[0])

        cursor.execute(
            "INSERT INTO log VALUES ({});".format(randint(1, 10000)))
        connection.commit()
        cursor.execute("SELECT COUNT(event_id) from log;")
        record = cursor.fetchone()
        print("Valor registrado, conteo total: {}".format(record[0]))
    except Exception as error:
        print ("Error al conectarse a PostgreSQL", error)
    finally:
        if connection:
            cursor.close()
            connection.close()
            print("Conexión cerrada")


if __name__ == '__main__':
    try:
        while True:
            try:
                print(datetime.now())
                main()
                sleep(3)
            except Exception as e:
                print("Error atrapado:n", e)
                sleep(1)
    except KeyboardInterrupt:
        print("salida")
La aplicación necesita PostgreSQL para funcionar. Crearemos un clúster en la nube MCS usando la API. En una terminal normal, donde la variable OS_TOKEN contiene el token de acceso a la API (se puede obtener con el comando openstack token issue), escribiremos los comandos:
Creando clúster:
cat < pgc10.json
{"cluster":{"name":"postgres10","allow_remote_access":true,"datastore":{"type":"postgresql","version":"10"},"databases":[{"name":"myproddb"}],"users":[{"databases":[{"name":"myproddb"}],"name":"admin","password":"P@ssw0rd"}],"instances":[{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}},{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}},{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}}]}}
EOF

curl -s -H "X-Auth-Token: $OS_TOKEN"
-H 'Accept: application/json'
-H 'Content-Type: application/json'
-d @pgc10.json https://infra.mail.ru:8779/v1.0/ce2a41bbd1434013b85bdf0ba07c770f/clusters
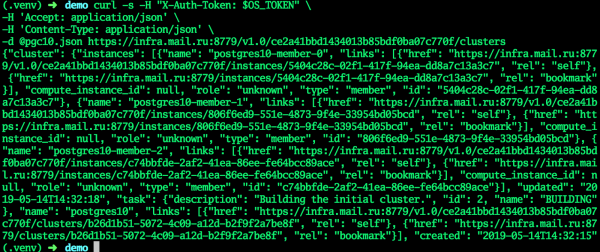
Cuando el clúster cambie a estado ACTIVO, todos los campos recibirán valores actualizados: el clúster estará listo.
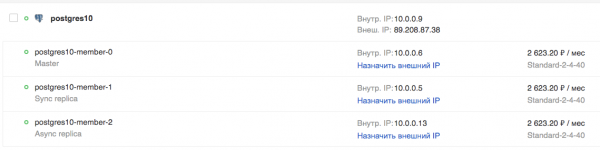
En la GUI:
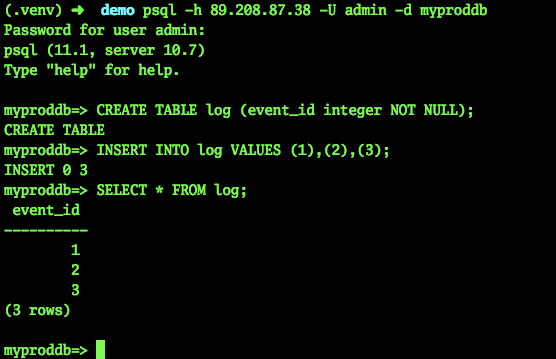
Intentaremos conectarnos y crear una tabla:
psql -h 89.208.87.38 -U admin -d myproddb
Contraseña para el usuario admin:
psql (11.1, servidor 10.7)
Escriba "help" para ayuda.

myproddb=> CREATE TABLE log (event_id integer NOT NULL);
CREATE TABLE
myproddb=> INSERT INTO log VALUES (1),(2),(3);
INSERT 0 3
myproddb=> SELECT * FROM log;
 event_id
----------
        1
        2
        3
(3 rows)

myproddb=>
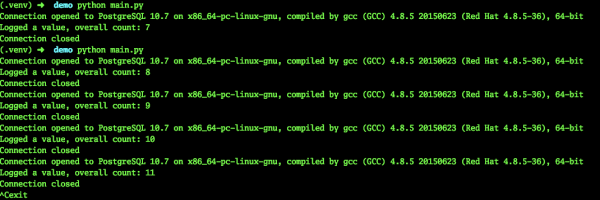
En la aplicación, especificaremos la configuración actual para la conexión a PostgreSQL. Indicaremos la dirección del balanceador de carga TCP, de esta manera no será necesario cambiar manualmente a la dirección del maestro. Iniciaremos el servicio. Como se puede ver, los eventos se registran correctamente en la base de datos.
Failover programado del maestro
Ahora probaremos el funcionamiento de nuestra aplicación durante el failover programado del maestro:
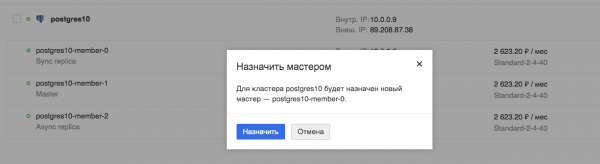
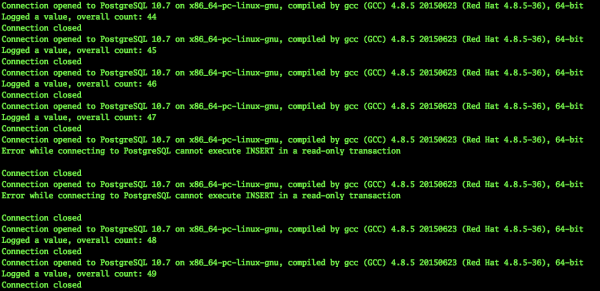
Observamos la aplicación. Vemos que el funcionamiento de la aplicación realmente se interrumpe, pero solo toma unos segundos, en este caso específico, un máximo de 9.
Caída de la máquina
Ahora intentaremos simular la caída de la máquina virtual, del actual maestro. Se podría simplemente apagar la máquina virtual a través de la interfaz de Horizon, pero eso sería un apagado normal. Este tipo de cambio será manejado por todos los servicios, incluido Patroni.
Lo que necesitamos es un apagado inesperado. Por lo tanto, le pedí a nuestros administradores que apagaran la máquina virtual —actual maestro— de manera no estándar para fines de prueba.
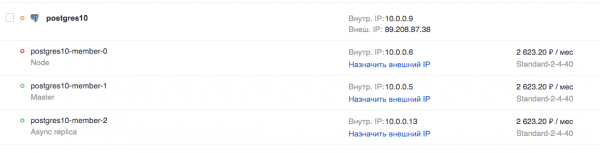
Mientras tanto, nuestra aplicación seguía funcionando. Naturalmente, este failover de emergencia del maestro no puede pasar desapercibido.
2019-03-29 10:45:56.071234
Conexión abierta a PostgreSQL 10.7 en x86_64-pc-linux-gnu, compilado por gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64 bits
Valor registrado, conteo total: 453
Conexión cerrada
2019-03-29 10:45:59.205463
Conexión abierta a PostgreSQL 10.7 en x86_64-pc-linux-gnu, compilado por gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64 bits
Valor registrado, conteo total: 454

Conexión cerrada
2019-03-29 10:46:02.661440
Error al conectar al servidor PostgreSQL, la conexión se cerró inesperadamente
        Esto probablemente significa que el servidor terminó de manera anormal
        antes o mientras procesaba la solicitud.

Error capturado:
 variable local 'connection' referenciada antes de la asignación
……………………………………………………….. - hay una cierta cantidad de errores
2019-03-29 10:46:30.930445
Error al conectar al servidor PostgreSQL, la conexión se cerró inesperadamente
        Esto probablemente significa que el servidor terminó de manera anormal
        antes o mientras procesaba la solicitud.

Error capturado:
 variable local 'connection' referenciada antes de la asignación
2019-03-29 10:46:31.954399
Conexión abierta a PostgreSQL 10.7 en x86_64-pc-linux-gnu, compilado por gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64 bits
Valor registrado, conteo total: 455
Conexión cerrada
2019-03-29 10:46:35.409800
Conexión abierta a PostgreSQL 10.7 en x86_64-pc-linux-gnu, compilado por gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64 bits
Valor registrado, conteo total: 456
Conexión cerrada
^Csalir
Como se puede ver, la aplicación pudo continuar funcionando en menos de 30 segundos. Sí, algunos usuarios del servicio podrían notar los problemas. Sin embargo, esta es una falla grave del servidor, algo que no ocurre con frecuencia. Al mismo tiempo, es poco probable que una persona (administrador) pudiera reaccionar tan rápidamente, a menos que estuviera en la consola lista con un script de conmutación.
Salida
A mi parecer, este clúster brinda una ventaja colosal para los administradores. En esencia, las fallas graves y los fallos de los servidores de bases de datos no serán notados por la aplicación y, por ende, por el usuario. No será necesario reparar nada con prisa ni conmutar a configuraciones temporales, servidores, etc. Y si se utiliza esta solución como un servicio listo en la nube, no será necesario perder tiempo en su preparación. Se podrá dedicar a cosas más interesantes.
Fuente: habr.com
