

El tema de los grandes accidentes en los modernos centros de datos suscita preguntas a las que no se dio respuesta en el primer artículo; decidimos desarrollarlo.
Si se cree en la estadística del Uptime Institute, la mayor parte de los incidentes en los centros de datos está relacionada con fallos en el suministro eléctrico, que representan el 39 % de los incidentes. Después está el factor humano, que suma otro 24 % de los accidentes. La tercera causa más significativa (15 %) fueron los fallos en los sistemas de climatización, y en cuarto lugar (12 %) se encuentran los desastres naturales. La suma de otros problemas representa solo el 10 %. Sin cuestionar los datos de esta organización respetada, señalaremos algo común en diferentes accidentes y trataremos de entender si se pudieron evitar. Spoiler: se pudieron evitar en la mayoría de los casos.
La ciencia de los contactos
Simplificando, hay solo dos problemas con la alimentación eléctrica: o no hay contacto donde debería haberlo, o lo hay donde no debería. Se puede discutir mucho sobre la fiabilidad de los modernos sistemas de suministro eléctrico ininterrumpido, pero no siempre logran salvar la situación. Tomemos, por ejemplo, el caso conocido del centro de procesamiento de datos utilizado por British Airways, que pertenece a la empresa matriz International Airlines Group. Cerca del aeropuerto de Heathrow se encuentran dos de estos centros: Boadicea House y Comet House. En el primero de ellos, el 27 de mayo de 2017, ocurrió un apagón accidental que provocó una sobrecarga y un fallo en el sistema de UPS. Como resultado, parte del equipo de TI sufrió daños físicos, y la recuperación de ese último accidente llevó tres días.
La aerolínea tuvo que cancelar o reprogramar más de mil vuelos, alrededor de 75,000 pasajeros no pudieron salir a tiempo. El pago de compensaciones ascendió a $128 millones, sin contar los costos necesarios para restaurar la operatividad de los centros de datos. La historia de las causas del apagón es confusa. Si se cree en los resultados de la investigación interna anunciados por el CEO de International Airlines Group, Willie Walsh, ocurrió debido a un error de los ingenieros. Sin embargo, el sistema de suministro eléctrico ininterrumpido debería haber soportado esa desconexión, para eso fue instalado. El centro de datos fue gestionado por especialistas de la empresa de externalización CBRE Managed Services, por lo que British Airways intentó reclamar la indemnización a través del tribunal de Londres.
Los cortes de energía siguen patrones similares: primero ocurre un apagón debido al proveedor de electricidad, a veces por mal tiempo o problemas internos (incluidos errores del personal), y luego el sistema de alimentación ininterrumpida no puede manejar la carga o una interrupción breve de la onda sinusoidal causa fallos en numerosos servicios, cuyo restablecimiento requiere mucho tiempo y dinero. ¿Es posible evitar tales incidentes? Sin duda. Si se diseña el sistema correctamente, aunque los creadores de grandes centros de datos tampoco están inmunes a los errores.
El factor humano
Cuando la causa inmediata del incidente son acciones incorrectas del personal del centro de datos, los problemas suelen (pero no siempre) afectar a la parte software de la infraestructura de TI. Estos incidentes ocurren incluso en grandes corporaciones. En febrero de 2017, debido a un error cometido por un miembro del grupo de explotación técnica de uno de los centros de datos, se desconectó una parte de los servidores de Amazon Web Services. El error ocurrió durante la depuración del proceso de facturación a los clientes del servicio de almacenamiento en la nube Amazon Simple Storage Service (S3). El empleado intentaba eliminar una cierta cantidad de servidores virtuales que la sistema de facturación estaba utilizando, pero afectó a un clúster más grande.
Como resultado del error del ingeniero, se eliminaron servidores que ejecutaban importantes módulos de software del almacenamiento en la nube de Amazon. En primer lugar, se vio afectado el subsistema de indexación, que contenía información sobre metadatos y ubicación de todos los objetos S3 en la región estadounidense US-EAST-1. También se vio afectado el subsistema utilizado para almacenar datos y gestionar el espacio de almacenamiento disponible. Después de eliminar las máquinas virtuales, estos dos subsistemas requirieron un reinicio completo, y a continuación, los ingenieros de Amazon se enfrentaron a una sorpresa: durante un tiempo prolongado, el almacenamiento en la nube público no pudo atender las solicitudes de los clientes.
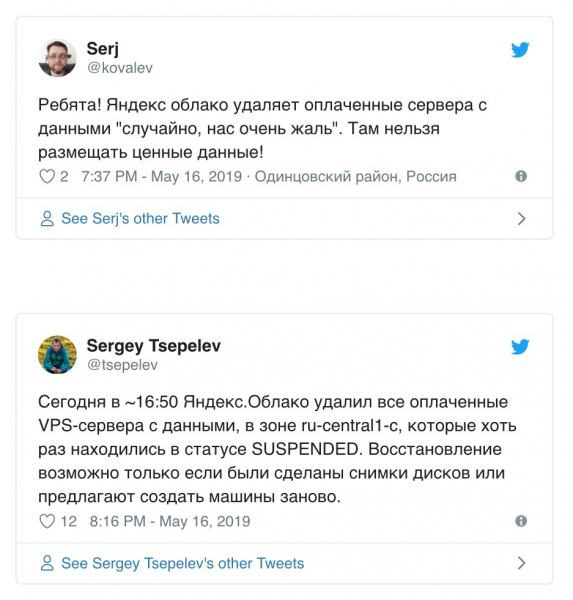
El efecto resultó ser amplio, ya que muchos grandes recursos utilizan Amazon S3. Las interrupciones afectaron a Trello, Coursera, IFTTT y, lo que es más preocupante, a los servicios de grandes socios de Amazon de la lista S&P 500. Es difícil cuantificar los daños en tales casos, pero se estiman en cientos de millones de dólares estadounidenses. Como puede ver, para desactivar el servicio de la mayor plataforma en la nube, basta con un solo comando erróneo. Este no es un caso aislado, el 16 de mayo de 2019, durante trabajos de mantenimiento, el servicio Yandex.Cloud máquinas virtuales de usuarios en la zona ru-central1-c, que alguna vez estuvieron en estado SUSPENDED. Aquí ya se han visto afectadas los datos de los clientes, parte de los cuales se han perdido de forma irrecuperable. Por supuesto, las personas no son perfectas, pero los sistemas modernos de seguridad de la información han sabido controlar las acciones de los usuarios privilegiados antes de ejecutar los comandos que han introducido. Si se implementaran tales soluciones en Yandex o Amazon, se podrían evitar incidentes similares.
Enfriamiento congelado
En enero de 2017, ocurrió un gran accidente en el centro de datos de la empresa "MegaFon" en Dmitrov. La temperatura en la región de Moscú bajó a -35 °C, lo que provocó la falla del sistema de refrigeración del objeto. El servicio de prensa del operador no se extendió mucho sobre las causas del incidente; las empresas rusas son muy reacias a hablar sobre los accidentes en sus instalaciones, en términos de publicidad, estamos muy rezagados respecto a Occidente. En las redes sociales circulaba la versión de que el fluido refrigerante se había congelado en las tuberías enterradas en la calle y que había filtraciones de etilenglicol. Si se le da crédito a esta versión, el servicio de operaciones no pudo obtener rápidamente 30 toneladas de refrigerante debido a las largas vacaciones y se las arregló utilizando medios improvisados, organizando un enfriamiento fraccional en violación de las reglas de operación del sistema. Las fuertes heladas empeoraron el problema; en enero repentinamente llegó el invierno a Rusia, aunque nadie lo esperaba. Al final, el personal tuvo que desconectar parte de los racks de servidores, lo que provocó que algunos servicios del operador fueran inaccesibles durante dos días.
Quizás aquí también se puede hablar de una anomalía climática, pero tales heladas no son algo inusual para la región metropolitana. La temperatura en invierno en la región de Moscú puede bajar a niveles aún más bajos, por lo que los centros de datos se construyen con la previsión de un funcionamiento sostenible a −42 °C. A menudo, los sistemas de refrigeración fallan en el frío debido a la concentración insuficientemente alta de glicoles y el exceso de agua en la solución del refrigerante. También pueden surgir problemas con la instalación de tuberías o con errores de cálculo en el diseño y las pruebas del sistema, principalmente relacionados con el deseo de ahorrar. Como resultado, ocurre un fallo serio que podría haberse evitado.
Desastres naturales
Con mayor frecuencia, tormentas y/o huracanes interrumpen el funcionamiento de la infraestructura del centro de datos, lo que lleva a la detención de servicios y/o a daños físicos en el equipo. Los incidentes provocados por el mal tiempo ocurren bastante a menudo. En 2012, el huracán Sandy, acompañado de intensas lluvias, azotó la costa oeste de Estados Unidos. El centro de datos Peer 1, ubicado en un rascacielos en el bajo Manhattan, , después de que el agua salada del mar inundara los sótanos. Los generadores de emergencia del edificio estaban colocados en el piso 18, y su reserva de combustible era limitada: las normas implementadas en Nueva York tras los ataques del 11 de septiembre prohíben almacenar grandes cantidades de combustible en pisos superiores.
La bomba de combustible también falló, por lo que el personal tuvo que transportar combustible diésel para los generadores a mano durante varios días. El heroísmo del equipo salvó al centro de datos de un grave accidente, pero ¿era realmente necesario? Vivimos en un planeta con una atmósfera de nitrógeno y oxígeno y una gran cantidad de agua. Las tormentas y los huracanes son algo habitual aquí (especialmente en áreas costeras). Los arquitectos probablemente deberían haber considerado los riesgos asociados y haber construido un sistema de suministro eléctrico ininterrumpido adecuado. O al menos elegir un lugar más apropiado para el centro de datos que un rascacielos en una isla.
Todo lo demás
En esta categoría, el Uptime Institute señala una variedad de incidentes, entre los cuales es difícil seleccionar uno típico. Robos de cables de cobre, invasiones en los centros de datos, torres de líneas eléctricas y estaciones transformadoras, automóviles, incendios que dañan la fibra óptica, excavadoras, roedores (ratas, conejos e incluso wombats, que en realidad son marsupiales), así como aficionados a practicar disparando a los cables — el menú es extenso. Los cortes de energía pueden ser provocados incluso por de marihuana que roba electricidad. En la mayoría de los casos, los responsables del incidente son personas concretas, es decir, nuevamente estamos tratando con el factor humano, cuando el problema tiene nombre y apellido. Incluso si a primera vista el accidente está relacionado con un fallo técnico o con desastres naturales, se puede evitar con un diseño adecuado del sitio y un correcto mantenimiento. Las excepciones son quizás los casos de daños críticos a la infraestructura del centro de datos o la destrucción de edificios y estructuras debido a una catástrofe natural. Estas son realmente circunstancias de fuerza mayor, mientras que todos los demás problemas son causados por la conexión entre la computadora y la silla — probablemente, esta sea la parte más poco confiable de cualquier sistema complejo.
Fuente: habr.com
