

La primera API de Mi Almacén apareció hace 10 años. Durante todo este tiempo hemos estado trabajando en las versiones existentes de la API y desarrollando nuevas. Ya hemos enterrado varias versiones de la API.
En este artículo encontrarás mucho: cómo se creó la API, por qué es necesaria para los servicios en la nube, qué beneficios ofrece a los usuarios, en qué tropiezos hemos caído y qué queremos hacer a continuación.
Me llamo Oleg Alekseev , soy el director técnico y cofundador de Mi Almacén.
¿Por qué hacer una API para el servicio?
Nuestros clientes, que son decenas de miles de emprendedores, utilizan activamente soluciones en la nube: banca, tiendas en línea, gestión de inventarios, CRM. Se conectan a una, y ya es difícil detenerse. Y así, el quinto, octavo, décimo servicio facilita el trabajo del emprendedor, pero los datos entre estos servicios en la nube los usuarios los trasladan manualmente. El trabajo se convierte en una pesadilla.
La solución obvia es dar a los usuarios la posibilidad de transferir datos entre servicios en la nube. Por ejemplo, importar y exportar datos como archivos, que luego se pueden cargar en el servicio necesario. Los archivos generalmente se modifican según el formato de cada servicio. Esto es un trabajo manual más o menos simple, pero a medida que aumenta la cantidad de estos servicios, se vuelve cada vez más difícil realizarlo.
Por lo tanto, el siguiente paso es la API. Con ella, el servicio en la nube se beneficia al conectar varios servicios en un solo punto. La aparición de un ecosistema así atrae nuevos clientes gracias a las capacidades adicionales. Un producto con nuevas funcionalidades se vuelve más rentable y útil.
Si se crean interfaces de programación propias, esto atrae a vendedores externos en forma de programadores que conocen su producto gracias a la API. Comienzan a construir soluciones basadas en la API ofrecida y ganan dinero automatizando las tareas de sus clientes.
El sistema de contabilidad de Mi Almacén se basa en procesos simples. Lo principal es trabajar con documentos primarios, poder recibir y enviar mercancías, obtener informes basados en los documentos primarios para el negocio. También hay transferencia de datos, por ejemplo, a la contabilidad en la nube, y su obtención de sistemas bancarios o puntos de venta. Además, trabajamos con tiendas en línea: obtenemos información sobre productos y enviamos datos sobre existencias.
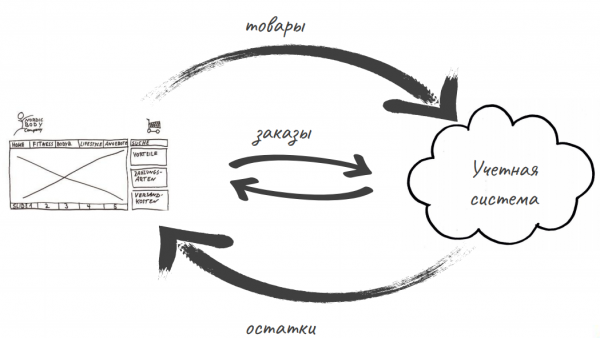
La primera API de Mi Almacén
A lo largo de los 10 años de trabajo de Mi Almacén con la API, hemos acumulado diversas integraciones que permiten intercambiar datos, trabajar con bancos, realizar pagos y utilizar telefonía externa.
En el primer año, habilitamos la posibilidad de exportar cualquier dato en formato XML. En ese entonces, a los usuarios les resultaba mucho más comprensible y habitual mantener los datos de manera offline, en lugar de en una nube, y les proporcionamos eso. La exportación se iniciaba mediante una exportación manual desde la interfaz. Así que no se podía llamar API en ese momento.
Ese mismo año comenzamos a colaborar con la empresa Rusagro: ellos ya utilizaban un ERP 'maduro' para la planificación de producción y ventas, mientras que en Mi Almacén automatizamos la carga de vagones en las fábricas. Así tuvimos los primeros indicios de una API real: el intercambio entre nuestro servicio y el ERP se realizaba al enviar un gran archivo con datos sobre todos los tipos de documentos.
Esta era una buena opción para el intercambio de datos por lotes, pero junto con los documentos, era necesario transmitir sus dependencias: información sobre productos, contrapartes y almacenes. Este tipo de acumulación no es difícil de generar en la exportación, pero resulta bastante complicado desglosar en la importación, ya que en un único paquete llegan todos los datos: tanto sobre nuevos documentos como sobre los ya existentes.
La primera API XML no duró mucho: después de dos años comenzamos su reconstrucción. Desde el inicio de su funcionamiento cometimos varios errores al construir la interfaz de programación.
Así se creó la API XML: ilustración de uno de nuestros arquitectos. Por cierto, esperen sus artículos.
Estos son nuestros principales errores:
- La marcación JAXB se realizó directamente sobre los entity beans. Para comunicarnos con la base de datos utilizamos Hibernate, y sobre esos mismos beans se hizo la marcación JAXB. Este error se evidenció casi de inmediato: cualquier actualización en la estructura de datos requería una urgente notificación a todos los que utilizan la API, o la construcción de parches que garantizaran la compatibilidad con la estructura de datos anterior.
- La API surgió como un complemento y, al principio, no definimos qué parte del producto representaba. No consideramos si la API era algo importante ni si debíamos mantener la compatibilidad hacia atrás para sus primeros clientes. En un momento, el número de usuarios de la API representaba alrededor del 5% del pequeño número total, y no se les prestó atención. La filtración universal que se llevó a cabo en su momento llevó a que nos comenzaran a usar como backend. Esta filtración no era exactamente GraphQL, sino algo parecido: funcionaba a través de una gran cantidad de parámetros en la cadena de consulta. Con una herramienta tan poderosa, a los usuarios les resultó difícil resistirse, y comenzaron a enviar solicitudes directamente desde la interfaz de usuario de sus tiendas en línea. La situación se convirtió en una desagradable sorpresa, ya que ofrecer tal servicio debería requerir un esquema de precios diferente y una comprensión completamente distinta de la API como producto.
- Debido a que la API no se desarrolló como producto principal, la documentación de la API se elaboró y publicó de manera residual, a través de ingeniería inversa. Este camino parece bastante simple y conveniente, pero contradice el trabajo contractual. Esto es cuando hay un componente con un esquema de funcionamiento preestablecido. El desarrollador lo implementa de acuerdo con este esquema y la tarea, el componente pasa pruebas, el cliente recibe un producto que coincide con la idea del analista. La ingeniería inversa, por otro lado, lanza al mercado un producto que simplemente existe: con parches, soluciones extrañas y bicicletas en lugar de la funcionalidad necesaria.
- Todo el flujo de solicitudes que llegaba a través de la API solo podía ser analizado como un registro de Nginx o del servidor de aplicaciones. Esto no permitía identificar áreas específicas, salvo dividir por usuarios y suscriptores. Si no hay forma de regular el registro de aplicaciones o clientes, se vuelve imposible analizar la situación. Este problema afectó en menor medida el desarrollo de la API; se trata más de entender su demanda y el contenido funcional que ofrece.
Intento número dos: REST API
En 2010, intentamos construir un sistema de intercambio con la contabilidad en línea — BuchSoft. No funcionó. Sin embargo, durante el proceso de integración, se desarrolló una API completa: un servicio REST de intercambio, donde no había libertades como las llamadas a operaciones en forma de invocaciones RPC. Toda la comunicación con la API se ajustó al modo estándar para REST: en la cadena de solicitud se incluye el nombre de la entidad, y la operación que se realiza con ella se establece mediante el método HTTP. Añadimos filtrado por el momento de actualización de entidades, y ahora los usuarios tienen la posibilidad de construir replicación con sus sistemas.
Ese mismo año, se lanzó la API para la exportación de existencias y mercancías. A través de la API, las partes más valiosas del sistema se hicieron accesibles para los usuarios: el intercambio de documentos primarios y los datos de cálculo sobre existencias y costos de las mercancías.
En diciembre de 2015, RetailCRM publicó la primera biblioteca de tercero para acceder a nuestra API. Esta se empezó a utilizar de manera bastante activa, y al mismo tiempo creció la popularidad del servicio en general, la carga en la API aumentó más rápido que la carga en la interfaz web. Una vez, el crecimiento se convirtió en un salto de carga.
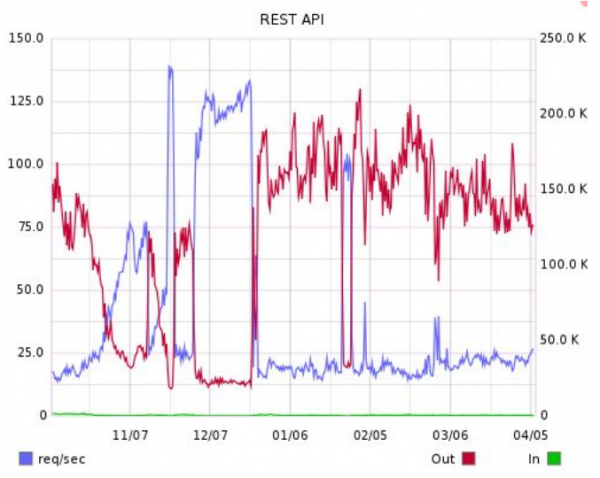
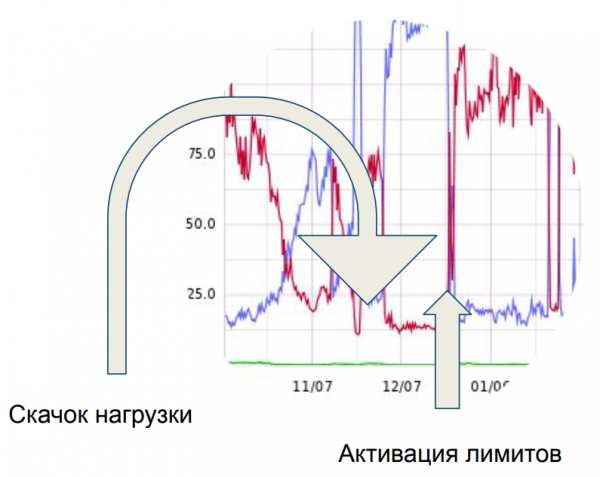
Y este salto, al que apunta la flecha de la izquierda, dejó completamente asombrado al servidor que atiende nuestra API. Pasamos una semana averiguando qué generaba exactamente esa carga. Resultó que eran esas mismas solicitudes que se transmitían a nuestra API desde los frontales de los clientes. Alrededor de 50 clientes fueron responsables. En ese momento entendimos uno de nuestros errores: la total ausencia de límites.
Como resultado, introdujimos un límite en el número de solicitudes simultáneas. Desde una cuenta, ahora se pueden abrir no más de dos solicitudes al mismo tiempo. Esto es suficiente para trabajar en modo de replicación para el intercambio de datos en modo por lotes. Aquellos que querían utilizarlo como backend, a partir de ahora, tendrían que ajustarse más a las tarifas, ya que introdujimos el uso de múltiples cuentas en sus herramientas de software.
Ordenando
Desde 2014, la demanda de la API existente se convirtió en una parte importante del negocio, y la propia API generaba el mayor volumen de datos en el intercambio de información con los clientes. En 2015, lanzamos un proyecto para poner en orden la API. Elegimos el formato JSON en lugar de XML y comenzamos a construirlo sobre la base de las características que identificamos al implementar la versión anterior:
- La capacidad de gestionar versiones. La versionado permite desarrollar una nueva versión sin afectar la aplicación existente ni interrumpir a los usuarios.
- La posibilidad de que el usuario vea los metadatos en la respuesta que recibe.
- La posibilidad de intercambiar grandes documentos. Si procesamos un documento con más de 4-5 mil ítems, esto se convierte en un problema para el servidor: transacciones largas, solicitudes http largas. Se construyó un mecanismo especial que permite actualizar documentos en partes y gestionar ítems individuales de ese documento, enviándolos al servidor.
- Herramientas para la replicación — estaban en la versión anterior.
- Límites de carga — como legado de los errores cometidos en la versión anterior. Se introdujeron límites en el número de solicitudes en un periodo de tiempo, el número de solicitudes paralelas y solicitudes desde una misma dirección IP.
Desde entonces hemos lanzado dos versiones menores de la API y hemos puesto en marcha varias APIs especializadas, pero en general el enfoque ha permanecido sin cambios. El formato de intercambio actualizado y la nueva arquitectura han permitido corregir las deficiencias de la API mucho más rápido.
API de MiAlmacén hoy
Hoy, la API de MiAlmacén resuelve muchas tareas:
- intercambio de datos con tiendas en línea, sistemas contables, bancos;
- obtención de datos de cálculo, informes;
- uso como backend para aplicaciones de clientes — nuestras aplicaciones móviles y el punto de venta de escritorio funcionan a través de la API
- envío de notificaciones sobre cambios en los datos de MiAlmacén — webhooks;
- telefonía;
- sistemas de lealtad.
Basado en la API, nuestro director general Askar Rakhimberdiev en cuatro horas escribió un bot de telegram que obtiene a través de la API los saldos:
Ahora cifras secas.
Aquí están nuestras estadísticas sobre la antigua API REST:
- 400 empresas;
- 600 usuarios;
- 2 millones de solicitudes al día;
- 200 Gb/día de tráfico saliente.
Y aquí estamos con todas las API de MiAlmacén:
- más de 70 integraciones (parte de ellas se pueden ver aquí );
- 8500 empresas;
- 12,000 usuarios;
- 46 millones de solicitudes al día;
- 2 Tb/día de tráfico saliente.
¿Qué sigue?
Los planes de desarrollo de la API están en discusión activa. Nos esforzamos por tener en cuenta la experiencia operativa que nos proporcionan los usuarios. No siempre podemos hacerlo todo de inmediato, pero se acerca una nueva versión de la API con metadatos más convenientes y una estructura menos compleja, así como OAuth para la autenticación y una API para integrar en las aplicaciones de interfaz.
Puedes seguir las noticias en un sitio especial para desarrolladores que integran con MiAlmacén: .
Fuente: habr.com
