

Cuando hablamos de esteganografía, la gente imagina terroristas, pedófilos, espías, o en el mejor de los casos, criptoanarquistas y otros científicos. Y en efecto, ¿quién más podría necesitar por defecto el subdominio «www» y agregar un mecanismo algo a cubierto de miradas externas? ¿Qué utilidad podría tener esto para una persona común?
Resulta que sí tiene alguna. Por eso hoy comprimiremos datos utilizando métodos de esteganografía. Al final, el lector incluso podrá utilizar sus valiosos archivos de fotos en JPEG para aumentar la cantidad de gigabytes libres en el sistema de archivos.
¿Qué?
Si el lector recuerda, la esteganografía son esos algoritmos extraños que permiten ocultar la existencia de una información dentro de otra. En términos más simples: imagen + archivo == aproximadamente la misma imagen, pero no del todo (en lugar de imágenes, puede ser cualquier cosa, pero generalmente es más claro). No debería haber una manera sencilla de determinar si hay algo dentro o no.
Pero si no se puede distinguir una cosa de la otra, ¿hay realmente alguna diferencia? Desde el punto de vista del consumidor, al usuario no le preocupa la precisión matemática (reflejada en un conjunto concreto de bits), solo lo que percibe.
Por ejemplo, veamos tres imágenes de un adorable perro:
¡Cuidado, JPEG!
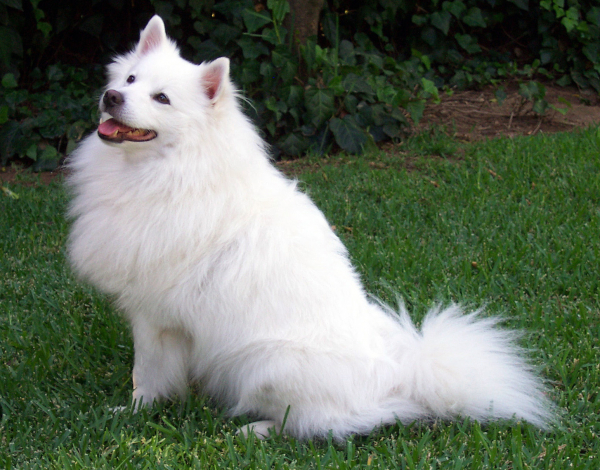
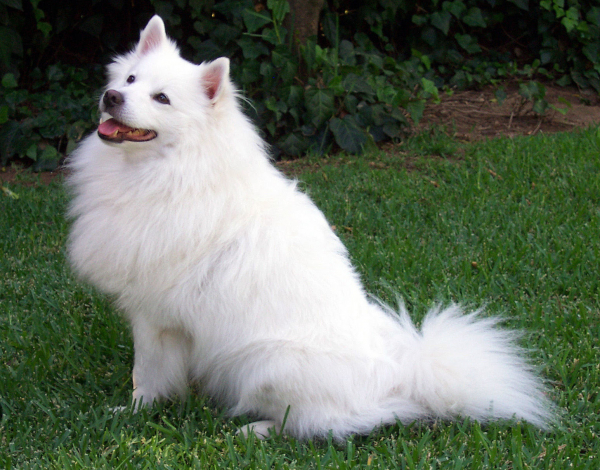
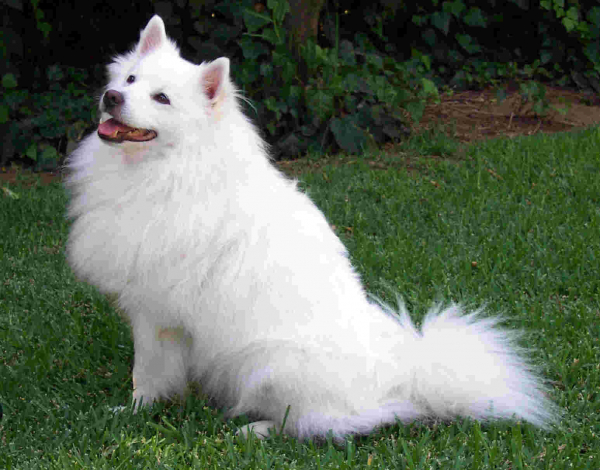
A pesar de la colosal diferencia en tamaño, pocos elegirían la tercera versión. Por otro lado, la diferencia entre las dos primeras fotos no es tan notable, y la cantidad de información en ellas (desde mi perspectiva) podría ser equivalente.
El principio mismo es ya viejo y ha sido explotado durante muchos años con métodos de compresión de información con pérdida. Pero romper no es construir, nos interesa el aspecto más avanzado de la cuestión. ¿Se puede incrustar información adicional de tamaño N en un archivo de manera que su tamaño aumente en M < N, y los cambios no sean perceptibles para el usuario?
Por supuesto, se puede. Pero debo hacer un par de aclaraciones de inmediato:
- En primer lugar, el método debe ser universal y dar un resultado positivo en la mayoría de los datos de entrada. Es decir, en promedio, para entradas arbitrarias, debería haber una reducción efectiva de la cantidad de información almacenada. "En promedio" significa que pueden ocurrir casos opuestos, pero no deberían prevalecer.
- En segundo lugar, el tamaño del contenedor comprimido antes de incrustar información debe ser mayor que el tamaño comprimido de su modificación de manera similar. Simplemente incrustar un montón de bits en una imagen BMP mediante el método LSB no es compresión esteganográfica, ya que, cuando se ejecuta a través de algún DEFLATE, es probable que la imagen original sea notablemente más pequeña.
- En tercer lugar, es necesario realizar y comparar el resultado en relación con los datos ya comprimidos mediante métodos clásicos. Esto permitirá eliminar el efecto probabilístico de la diferencia en su redundancia y realizar una compresión más efectiva en general.
¿Dónde?
El uso de la esteganografía implica que, además de la información comprimida, necesitaremos contenedores en los que se incrustará. La cantidad máxima de información que se puede incrustar depende en gran medida de propiedades individuales, pero es mucho más fácil escalar con su cantidad. Por lo tanto, el formato de los contenedores debe ser común, de modo que el usuario tenga suficiente cantidad para obtener algún beneficio del proceso de "compresión".
En este contexto, los buenos candidatos son archivos gráficos, de audio y de video. Sin embargo, debido a la diversidad de formatos, códecs, etc., en la práctica nos queda elegir entre un número no tan grande de opciones.
Teniendo todo esto en cuenta, elegí JPEG. Prácticamente todos lo tienen, se utiliza ampliamente tanto para fines personales como comerciales, siendo casi el formato de facto para la mayoría de las imágenes.
¿C̶u̶á̶n̶do̶ Cómo?
A continuación vienen diagramas técnicos y descripciones sin explicaciones especiales, por lo que los interesados pueden saltarse esta parte y avanzar a la sección de "Alta Tecnología".
Características Generales
Para incrustar datos en algún lugar, primero hay que determinar dónde. En el sistema de archivos puede haber una cantidad infinita de fotografías diferentes, entre las cuales el usuario puede querer utilizar solo algunas. Este conjunto deseado de contenedores lo llamaremos biblioteca.
Se forma en dos casos: antes de la compresión y antes de la descompresión. En el primer caso, se puede simplemente usar un conjunto de nombres (o mejor, una expresión regular para ellos) de archivos, pero en el segundo se requiere algo más confiable: el usuario puede copiarlos y moverlos dentro del sistema de archivos, dificultando así su identificación correcta. Por lo tanto, se requiere almacenar sus hashes (md5 es suficiente) después de realizar todas las modificaciones.
La búsqueda inicial mediante una expresión regular no tiene sentido realizarla en todo el sistema de archivos, basta con indicar un directorio raíz específico. En él se guardará un archivo-archivo especial, donde estarán esos hashes, junto con otra información meta necesaria para la posterior recuperación de la información comprimida.
Todo esto es aplicable en igual medida a cualquier implementación de cualquier algoritmo de compresión de datos esteganográfica. Los propios procesos de compresión y recuperación de datos se pueden denominar empaquetado y desempaquetado.
F5
Ahora que se ha aclarado qué estamos haciendo y por qué, queda por describir el propio algoritmo para alcanzar el objetivo. Recordemos el proceso de codificación de un archivo JPEG (gracias a la wiki de la biblioteca nacional Bauman):
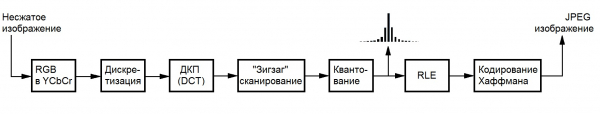
Al mirarlo, es mejor hacer algunas observaciones de inmediato:
- El tamaño de un archivo JPEG se puede considerar óptimo, incluso sin intentar comprimirlo con algún WinRAR;
- Solo se puede modificar la información almacenada (la que está en la salida de la transformación discreta del coseno, DCT) para garantizar un rendimiento aceptable.
- Para no perder datos en escalas industriales notables para el usuario, se requiere hacer un mínimo de modificaciones en cada imagen individual;
Bajo estas condiciones, se adapta toda una familia de algoritmos, con la que se puede familiarizar . El más avanzado de ellos es el algoritmo del autor Andreas Westfeld, que trabaja con los coeficientes DCT del componente de brillo (el ojo humano es menos sensible precisamente a estos cambios). Su esquema general al trabajar con un archivo JPEG existente se representa en el siguiente diagrama:
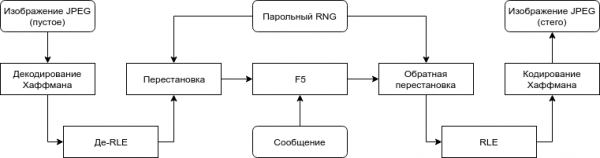
El bloque F5 utiliza una técnica avanzada de inserción basada en la codificación de matrices. Los lectores pueden encontrar más información sobre esto y el algoritmo en el enlace anterior; sin embargo, lo que nos interesa principalmente es el hecho de que, gracias a este método, se pueden realizar menos cambios al insertar la misma cantidad de información, a medida que aumenta el tamaño del contenedor utilizado. Además, para llevar a cabo el algoritmo solo se requieren operaciones simples de (de)codificación de Huffman y RLE.
Los cambios en sí se realizan sobre los coeficientes enteros y se reducen a disminuir su valor absoluto en uno, lo que permite, en términos generales, utilizar F5 para la compresión de datos. La razón es que un coeficiente reducido en valor absoluto ocupará, probablemente, menos bits después de aplicar la codificación de Huffman debido a la distribución estadística de los valores en JPEG.
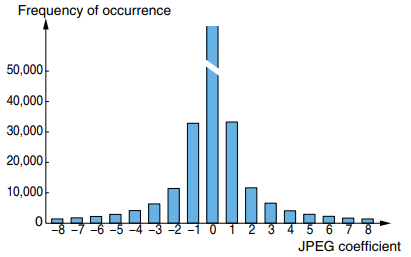
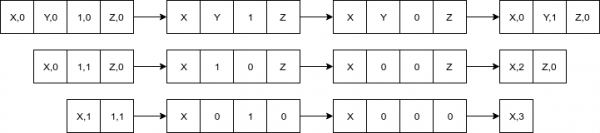
En caso de que se forme un cero (conocido como reducción), la cantidad de información almacenada se reducirá en su tamaño, ya que el coeficiente que antes era independiente se convertirá en parte de la secuencia de ceros codificada en RLE:
Modificaciones
La protección de datos y su compresión son tareas ortogonales, por lo que se puede prescindir de la permutación secreta de contraseñas del algoritmo original. Además, necesitamos saber exactamente cómo extraer los datos, por lo que toda la información necesaria (qué contenedores se utilizaron, en qué orden, etc.) debe registrarse en un archivo separado y estar disponible para su lectura libre por el descompresor.
El algoritmo original está diseñado para la transmisión de mensajes secretos, por lo que solo trabaja con un contenedor a la vez, asumiendo que el usuario se encargará de dividirlo en partes si es necesario, si es que surge esa necesidad. Además, al insertar de forma independiente en cada contenedor, es necesario saber de antemano cuántos bits de datos se deben colocar en cada uno. Por lo tanto, los coeficientes de cada elemento de la biblioteca deben combinarse en un único gran abstracto y trabajar con ello según el algoritmo original.
Dado que el F5 original permite utilizar hasta el 12% del tamaño del contenedor, esta modificación también incrementará la capacidad máxima: «hasta el 12%» del tamaño total de la biblioteca es mayor o igual a la suma de «hasta el 12%» de cada uno de sus elementos.
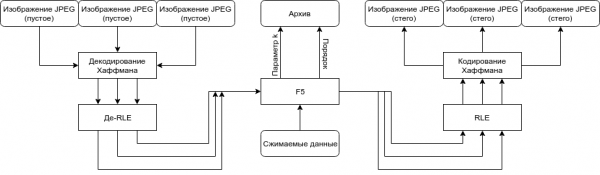
El esquema general codificado es el siguiente:
El algoritmo mismo
Ahora es el momento de describir el algoritmo en su totalidad, para que el lector no quede en la oscuridad:
- El usuario define los datos binarios comprimibles M y la biblioteca L mediante una expresión regular y el directorio raíz de búsqueda;
- En el orden correspondiente en el FS, los elementos de la biblioteca forman MC:
- De los datos del archivo se decodifica una serie de coeficientes C;
- MC <- MC | C;
- Se determina el parámetro k a partir de la terrible desigualdad:
|M| * 8 / (count_full(MC) + count_ones(MC) * k_rate(k)) < k / ((1 << k) - 1); - Se toma sucesivamente
n = (1 << k) - 1los bits menos significativos de los elementos no nulos de MC y se registran ena:- Se considera la función hash mágica
f, que mapea una palabra de n bitsaen k bitss; - Si
s == 0, entonces no hay necesidad de modificar nada y el algoritmo continúa con los siguientes coeficientes; - Reducir el valor absoluto del coeficiente correspondiente al
s-ésimo bit en la palabraa; - Si como resultado de la reducción se produjo una disminución (el coeficiente se hizo 0), entonces se repite el paso desde el principio;
- Se considera la función hash mágica
- Todos los coeficientes se codifican en RLE y Huffman, se registran en archivos de origen;
- Se registra el parámetro k en el archivo de archivo;
- De cada archivo L, en el orden de su aparición original, se calcula el hash MD5 y se registra en el archivo de archivo.
Alta tecnología
La forma naíf del algoritmo y su implementación en otros lenguajes de alto nivel (especialmente los que tienen recolección de basura) darían un rendimiento horrible, así que implementé todas estas complejidades en C puro y realicé una serie de optimizaciones tanto en la velocidad de ejecución como en la memoria (no se imagina cuánto pesan estas imágenes sin compresión incluso hasta DCT). Pero incluso así, al principio, la velocidad de ejecución dejaba mucho que desear, por lo que no describiré todo el proceso y los métodos utilizados.
La multiplataforma se logró utilizando una combinación de bibliotecas libjpeg, pcre y tinydir, por lo que les estoy agradecido. Por defecto, todo se compila a través del común make, por lo que los usuarios de Windows querrán instalar un Cygwin o lidiar con Visual Studio y las bibliotecas por su cuenta.
La implementación está disponible en forma de utilidad de consola y biblioteca. Aquellos que deseen aprender más sobre el uso de la última pueden consultar el README en el repositorio de GitHub, cuyo enlace anexaré al final de la publicación. Ahora pasemos a la descripción y demostración del funcionamiento.
¿Cómo usarlo?
Con precaución. Las imágenes utilizadas pueden ser movidas, renombradas y copiadas a voluntad. Sin embargo, hay que tener mucho cuidado y no modificar su contenido. Cambiar un solo bit resultará en la alteración del hash y en la imposibilidad de recuperar la información.
Supongamos que después de la compilación obtuvimos un archivo ejecutable f5ar. Podemos analizar el tamaño de la biblioteca para calcular las capacidades de su uso con la bandera -a: .\/f5ar -a [carpeta de búsqueda] [expresión regular compatible con Perl]. La compresión se realiza con el comando .\/f5ar -p [carpeta de búsqueda] [expresión regular compatible con Perl] [archivo a comprimir] [nombre del archivo comprimido], y la descompresión con .\/f5ar -u [archivo comprimido] [nombre del archivo restaurado].
Demostración del funcionamiento
Para mostrar la efectividad del método, he subido una colección de 225 fotos de perros totalmente gratuitas de un servicio . Cada una de ellas tiene una calidad ligeramente superior a la de las fotos de usuario comunes, pero en cualquier caso. Cada una fue recodificada con libjpeg para mitigar el impacto de las particularidades de codificación de la biblioteca en el tamaño total. Para ilustrar el peor ejemplo de datos comprimibles, se generó un archivo aleatorio de 36 metros (un poco más del 5% del tamaño total) de distribución uniforme utilizando dd.
El proceso de prueba es bastante simple:
$ ls
binary_data dogs f5ar
$ du -sh dogs\/
633M dogs\/
$ du -h binary_data
36M binary_data

$ .\/f5ar -p dogs\/ .*jpg binary_data dogs.f5ar
Leyendo archivo de compresión... ok
Inicializando el archivo comprimido... ok
Analizando capacitaciones de la biblioteca... completado en 16.8s
Capacidad garantizada detectada de 48439359 bytes
Capacidad posible detectada de hasta 102618787 bytes
Comprimiendo... completado en 32.6s
Guardando el archivo comprimido... ok

$ .\/f5ar -u dogs\/dogs.f5ar unpacked
Inicializando el archivo comprimido... ok
Leyendo el archivo comprimido... ok
Rellenando el archivo comprimido con archivos... completado en 1.2s
Descomprimiendo... completado en 17.5s
Escribiendo datos extraídos... ok

$ sha1sum binary_data unpacked
ba7ade4bc77881ab463121e77bbd4d41ee181ae9 binary_data
ba7ade4bc77881ab463121e77bbd4d41ee181ae9 unpacked
$ du -sh dogs\/
563M dogs\/
O un captura de pantalla para los aficionados
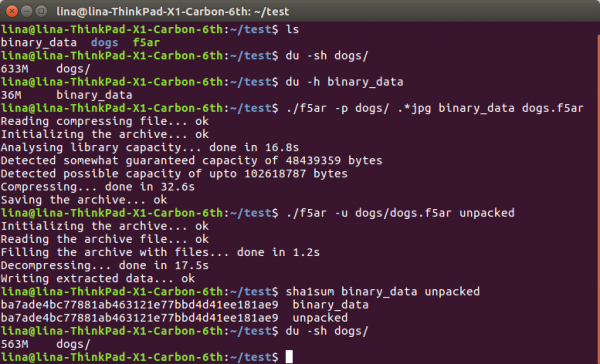
Como se puede ver, de los datos originales de 633 + 36 = 669 megabytes en el disco duro, hemos llegado a unos agradables 563, lo que nos da un coeficiente de compresión de aproximadamente 1.188. Esta drástica diferencia se explica por las muy pequeñas pérdidas, similares a las obtenidas al optimizar archivos JPEG con métodos clásicos (como tinyjpg). Naturalmente, al utilizar la compresión esteganográfica, la información no simplemente se "pierde", sino que se utiliza para codificar otros datos. Además, la cantidad de coeficientes "optimizados" mediante el uso de F5 es mucho menor en comparación con la optimización tradicional.
Cualesquiera que sean las modificaciones, no son absolutamente perceptibles a simple vista. Bajo el spoiler a continuación, el lector puede apreciar la diferencia tanto visualmente como deduciendo los valores de la componente modificada a partir de la original (cuanto más apagado sea el color, menor será la diferencia):
Enlaces a imágenes que no encajaron en habrastorage
Original —
Modificado —
Diferencia —
En conclusión
Espero haber podido convencer al lector de que tales métodos son posibles y tienen derecho a existir. Sin embargo, comprar un disco duro o un canal adicional (para la transmisión en red) puede parecer una salida mucho más simple que intentar ahorrar de esta manera. Por un lado, es cierto, el desarrollo extensivo a menudo es más simple y confiable. Pero por otro, no debemos olvidar el desarrollo intensivo. Pues no hay garantías de que mañana se pueda ir a la tienda y comprar otro disco duro de mil terabytes, mientras que se puede utilizar lo que ya se tiene en casa siempre.
->
Fuente: habr.com
