

¡Feliz viernes a todos! Amigos, hoy continuamos con la serie de publicaciones dedicadas al curso , ya que las clases en el nuevo grupo del curso comienzan a finales de la próxima semana. ¡Así que empecemos!
El monitoreo es simplemente. Es un hecho conocido. Levanta Nagios, ejecuta NRPE en el sistema remoto, configura Nagios en el puerto TCP NRPE 5666 y tendrás monitoreo.
Es tan fácil que no es interesante. Ahora tienes las métricas básicas sobre el tiempo de CPU, el subsistema de discos, la memoria RAM, que vienen por defecto en Nagios y NRPE. Pero en realidad, esto no es "monitoreo" tal como se entiende. Esto es solo el comienzo.
(Normalmente se instala PNP4Nagios, RRDtool y Thruk, se configuran notificaciones en Slack y se va directamente a nagiosexchange, pero por ahora dejemos eso de lado).
Un buen monitoreo en realidad es bastante complicado, realmente necesitas conocer los entresijos de la aplicación que estás monitoreando.
¿Es complicado el monitoreo?
Cualquier servidor, ya sea Linux o Windows, servirá a algún propósito por definición. Apache, Samba, Tomcat, almacenamiento de archivos, LDAP: todos estos servicios son más o menos únicos en uno o varios aspectos. Cada uno tiene su propia función, sus particularidades. Existen diferentes maneras de obtener métricas, KPI (indicadores clave de rendimiento) que te interesen cuando el servidor esté bajo carga.
Autor de la foto en
(me gustaría que mis paneles estuvieran pintados de colores azul neón — suspirando soñadoramente —… hm…)
Cualquier software que ofrezca servicios debe tener un mecanismo para recopilar métricas. Apache tiene un módulo mod-status, que muestra la página de estado del servidor. En Nginx — stub_status. Tomcat tiene JMX o aplicaciones web específicas que muestran métricas clave. En MySQL hay el comando "show global status" y etcétera.
¿Entonces por qué los desarrolladores no integran estos mecanismos en las aplicaciones que crean?
¿Solo los desarrolladores lo hacen?
Cierto nivel de indiferencia hacia la integración de métricas no se limita a los desarrolladores. He trabajado en empresas que desarrollaron aplicaciones usando Tomcat y no proporcionaron ninguna métrica de su parte, ningún registro de actividad del servicio, excepto los registros generales de errores de Tomcat. Algunos desarrolladores generan una abundancia de registros que no significan nada para el administrador del sistema que tiene la mala suerte de leerlos a las 3:15 de la mañana.
Autor de la foto en
Los ingenieros de sistemas que permiten que estos productos se lancen también deben asumir cierta responsabilidad por la situación. Pocos ingenieros de sistemas tienen tiempo y se preocupan por intentar obtener métricas significativas de los registros, sin el contexto de estas métricas y la capacidad de interpretarlas a la luz de la actividad de la aplicación. Algunos no entienden qué beneficios pueden obtener de esto, además de indicadores como 'algo actualmente (o pronto) no está bien'.
El cambio de mentalidad en relación con la necesidad de métricas debe ocurrir no solo entre los desarrolladores, sino también entre los ingenieros de sistemas.
Para cualquier ingeniero de sistemas que necesita no solo reaccionar a eventos críticos, sino también garantizar que no ocurran, la falta de métricas suele ser un obstáculo para ello.
Sin embargo, los ingenieros de sistemas generalmente no se adentran en el código, ganando dinero para su empresa. Necesitan desarrolladores líderes que comprendan la importancia de la responsabilidad del ingeniero de sistemas en la detección de problemas, la concienciación sobre problemas de rendimiento y similares.
Esta cosa de devops
La mentalidad devops describe la sinergia entre el pensamiento de desarrollo (dev) y operaciones (ops). Cualquier empresa que afirme que 'hacen devops' debe:
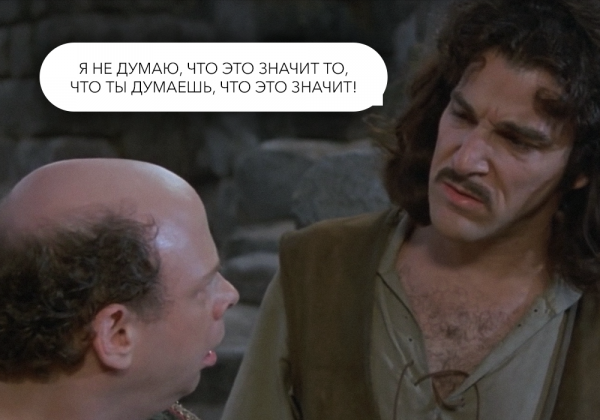
- decir lo que probablemente no están haciendo (una referencia a un meme de la película 'La Princesa Prometida' — '¡No creo que eso signifique lo que tú piensas que significa!')
- fomentar una postura de mejora continua del producto.
No puedes mejorar un producto y saber que ha sido mejorado si no entiendes cómo funciona actualmente. No podrás entender cómo funciona el producto si no comprendes cómo funcionan sus componentes, los servicios de los que depende, sus principales puntos de dolor y cuellos de botella.
Si no estás observando los posibles cuellos de botella, no podrás seguir la técnica de 'Los cinco porqués' al redactar un postmortem. No podrás reunir todo en una pantalla para ver cómo funciona el producto o saber cómo se ve 'normal y feliz'.
Desplazamiento a la izquierda, A LA IZQUIERDA, DIJE, ¡IZQUIERDAAAAA—!
Para mí, uno de los principios clave de Devops es el 'Desplazamiento a la izquierda' (shift left). El desplazamiento a la izquierda en este contexto significa desplazar la capacidad (no la responsabilidad, y solo las posibilidades) hacer lo que normalmente se preocupa ingenieros de sistemas, como crear métricas de rendimiento, utilizar los registros de manera más eficiente, etc., hacia la izquierda en el ciclo de vida de entrega de software (Software Delivery Life Cycle).
Autor de la foto en
Los desarrolladores de software deben tener la capacidad de utilizar y conocer las herramientas de monitoreo que utiliza la empresa para supervisar en todas sus formas, métricas, registros, interfaces de monitoreo y, lo que es más importante, observar cómo su producto funciona en producción. No puede obligar a los desarrolladores a invertir tiempo y esfuerzo en la supervisión, hasta que puedan ver las métricas e influir en cómo se presentan, cómo su propietario de producto las presentará a su CTO en la próxima reunión, etc.
En resumen
- Lleva al caballo al agua. Muéstrales a los desarrolladores cuántos problemas podrán evitar, ayúdalos a identificar los KPI y métricas correctos para sus aplicaciones, para que haya menos gritos del propietario del producto, al que grita el director técnico (CTO). Sácalos a la luz, con calma y suavidad. Si no funciona, entonces compra, amenaza y persuade ya sea a ellos o al propietario del producto para implementar lo más rápido posible la obtención de estas métricas desde las aplicaciones, y luego dibuja los diagramas. Esto será difícil, ya que no se considerará una prioridad, y en la hoja de ruta del producto habrá muchos proyectos en espera de implementación que generan ingresos. Por lo tanto, necesitarás un justificante económico para justificar el tiempo y los recursos gastados en implementar la supervisión en el producto.
- Ayuda a los ingenieros de sistemas a dormir mejor. Demuéstrales que utilizar una lista de verificación de 'lanzamiento de versión' para cualquier producto lanzado es positivo. Además, verificar que todas las aplicaciones en producción estén cubiertas con métricas ayudará a tener un sueño reparador por las noches, permitiendo que los desarrolladores vean qué no funciona y dónde. No obstante, la forma correcta de molestar y frustrar a cualquier desarrollador, propietario de producto o director técnico es obstinadamente entorpecer las cosas y resistirse. Tal comportamiento afectará la fecha de lanzamiento de cualquier producto, si se espera hasta el último minuto nuevamente, así que nuevamente realicen un desplazamiento a la izquierda e incluyan estas preocupaciones en el plan del proyecto lo antes posible. Si es necesario, infiltrarse en reuniones sobre el producto. Usa un bigote falso y un sombrero de fieltro o algo por el estilo, eso nunca falla. Reporta tus problemas, muestra las ventajas evidentes y evangeliza.
- Asegúrate de que tanto los desarrolladores (dev) como los operadores (ops) comprendan la importancia y las consecuencias de que las métricas del producto pasen a la 'zona roja'. No dejes que los operadores sean los únicos guardianes del funcionamiento del producto, asegúrate de que los desarrolladores también participen en esto (#productsquads).
- Los registros son algo excelente, pero las métricas también lo son. Combínalos y no dejes que tus registros se conviertan en basura en una inmensa esfera ardiente de inutilidad. Explica y muestra a los desarrolladores por qué nadie más que ellos podrá entender sus registros, muéstrales cómo es ver registros inútiles a las 3:15 de la mañana.
Autor de la foto en
Eso es todo. El nuevo material saldrá la próxima semana. Si deseas saber más sobre el curso, te invitamos a , que se llevará a cabo el lunes. Y ahora, tradicionalmente, esperamos tus comentarios.
Fuente: habr.com
