

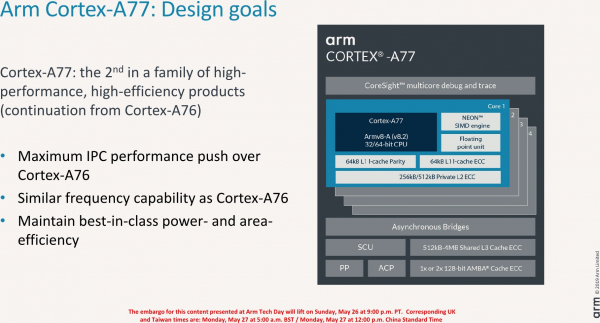
ARM ha presentado su nuevo diseño de procesador: Cortex-A77. Al igual que el Cortex-A76 del año pasado, este núcleo está destinado a tareas de alto rendimiento en smartphones y una variedad de dispositivos. El desarrollador se centra en aumentar la cantidad de instrucciones ejecutadas por ciclo (IPC). Las frecuencias de reloj y el consumo de energía se han mantenido aproximadamente al nivel del Cortex-A76.
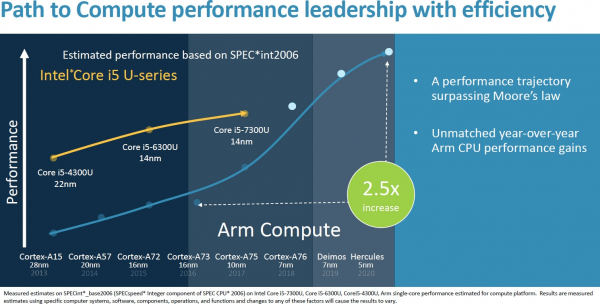
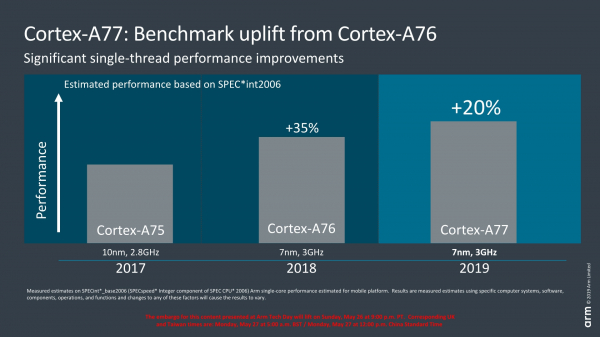
Actualmente, ARM se está enfocando en aumentar rápidamente el rendimiento de sus núcleos. Según sus planes, desde el Cortex-A73 de 2016 hasta el diseño Hercules de 2020, la empresa pretende aumentar la potencia de la CPU en 2.5 veces. Las transiciones de 16 nm a 10 nm y luego a 7 nm ya han permitido incrementar la frecuencia de reloj, y junto con la arquitectura Cortex-A75 y luego Cortex-A76, ARM estima que se ha logrado hasta ahora un aumento del rendimiento de 1.8 veces. Ahora, el núcleo Cortex-A77 permitirá, gracias al aumento del IPC, incrementar el rendimiento en un 20% manteniendo la misma frecuencia de reloj. Por lo tanto, un aumento de 2.5 veces en 2020 se vuelve totalmente viable.
A pesar del aumento del IPC del 20%, ARM estima que el consumo de energía del A77 no ha aumentado. El compromiso aquí es que el área del chip A77 es aproximadamente un 17% mayor que la del A76 bajo las mismas normas tecnológicas. Como resultado, el costo de un núcleo individual aumentará ligeramente. Si comparamos los logros de ARM con los líderes de la industria, vale la pena mencionar que AMD en Zen 2 logró un aumento del IPC del 15% en comparación con Zen+, mientras que el IPC de los núcleos Intel ha permanecido en torno al mismo nivel durante muchos años.
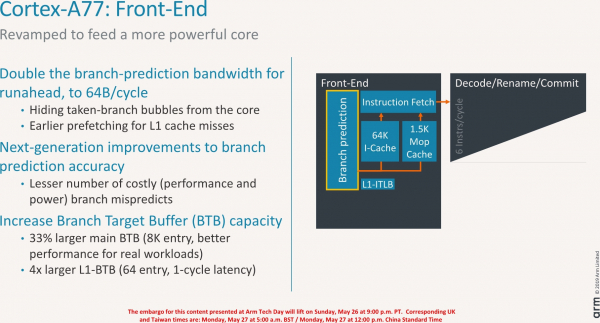
El tamaño de la ventana de ejecución con reordenamiento de instrucciones se ha aumentado en un 25%, hasta 160 unidades, lo que permite al núcleo aumentar el paralelismo en los cálculos. Incluso en el Cortex-A76 había un gran búfer de direcciones de salto (Branch Target Buffer), y en el Cortex-A77 se ha incrementado en un 33%, hasta 8 KB, lo que permite que el bloque de predicción de saltos maneje eficazmente el aumento en la cantidad de instrucciones paralelas.
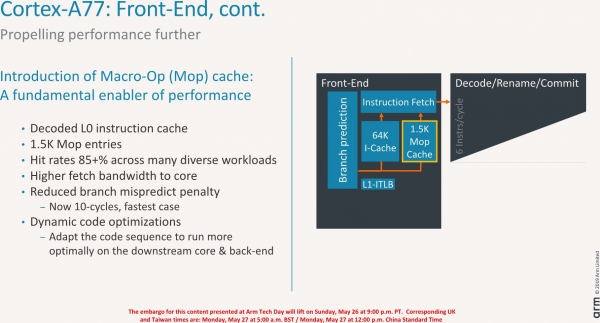
Una de las innovaciones más interesantes es la nueva caché de 1.5 KB, donde se almacenan las macroórdenes (MOP) devueltas del módulo de decodificación. La arquitectura del procesador ARM decodifica instrucciones de la aplicación de usuario en macroórdenes más pequeñas, y luego las descompone en microórdenes, que se transmiten al núcleo de ejecución. La caché MOP se utiliza para reducir el impacto de las ramas perdidas y los restablecimientos, ya que ahora las macroórdenes se almacenan en un bloque separado y no requieren volver a ser decodificadas, aumentando así el ancho de banda general del núcleo. En algunas cargas de trabajo, este nuevo bloque es un complemento extremadamente útil para la caché de instrucciones estándar.
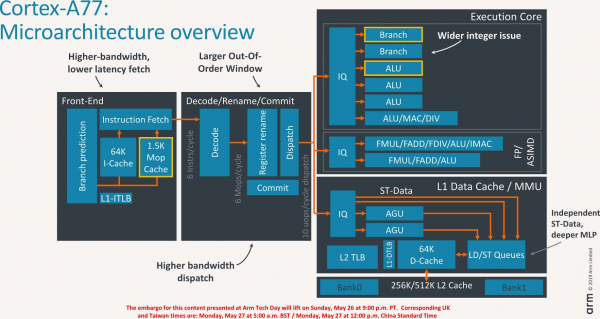
Se ha añadido un cuarto bloque ALU y un segundo bloque de bifurcación en el núcleo de ejecución. El cuarto ALU aumenta el ancho de banda general del procesador en 1.5 veces gracias a la capacidad de ejecutar instrucciones de un ciclo (como ADD y SUB) y operaciones enteras de dos ciclos como la multiplicación. Los otros dos ALU solo pueden procesar instrucciones básicas de un ciclo, mientras que el último bloque se encarga de operaciones matemáticas más complejas, como la división, multiplicación acumulativa, etc. El segundo bloque de bifurcación dentro del núcleo de ejecución duplica la cantidad de transiciones de bifurcación simultáneas que el núcleo puede manejar, lo que es útil en casos donde dos de las seis instrucciones enviadas son transiciones de bifurcación. Las pruebas internas en ARM mostraron una mejora en el rendimiento gracias al uso de este segundo bloque de transiciones.
Entre otros cambios en el núcleo, se ha añadido un segundo pipeline de cifrado AES, se ha aumentado el ancho de banda de la memoria y se ha mejorado el mecanismo de prefetching de datos de nueva generación, lo que permite mejorar la eficiencia energética y, al mismo tiempo, aumentar el ancho de banda del sistema DRAM, optimizaciones en la función de la caché, etc.
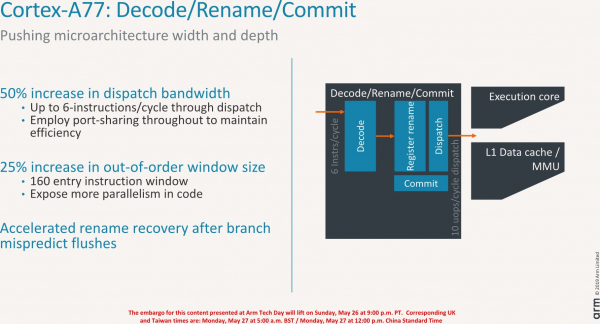
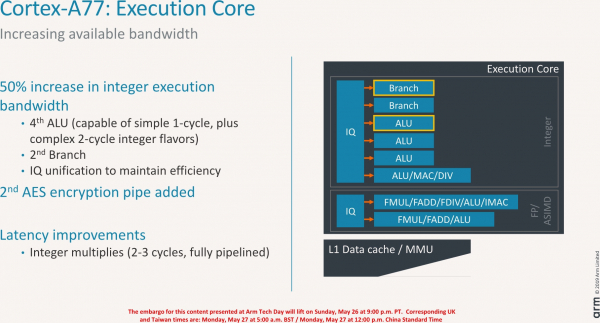
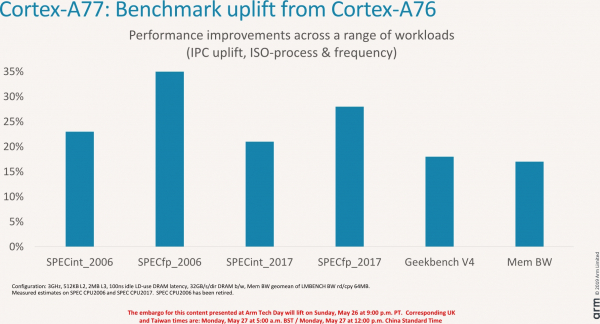
El mayor aumento se observa en Cortex-A77 en operaciones enteras y cálculos de punto flotante. Esto se confirma con las pruebas internas de ARM en SPEC, que mostraron un aumento de rendimiento del 20% y del 35% en operaciones enteras y cálculos de punto flotante, respectivamente. Las mejoras en el ancho de banda de la memoria están en un rango del 15 al 20%. En general, las optimizaciones y cambios en A77 proporcionan un crecimiento promedio del 20% en el rendimiento en comparación con la generación anterior. Gracias a normas tecnológicas más recientes como los 7 nm ULV, podemos obtener ventajas adicionales en los chips finales.
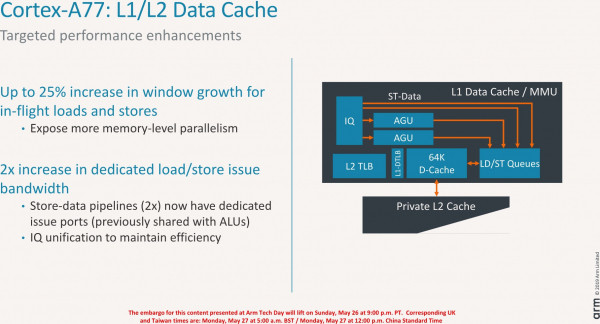
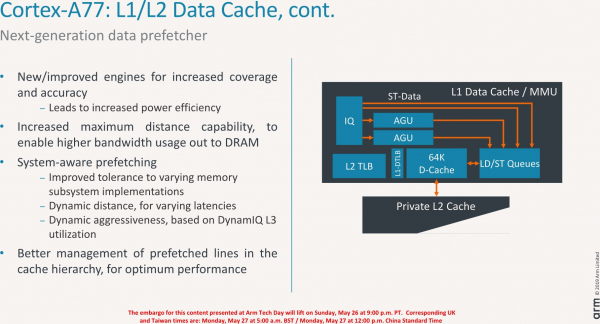
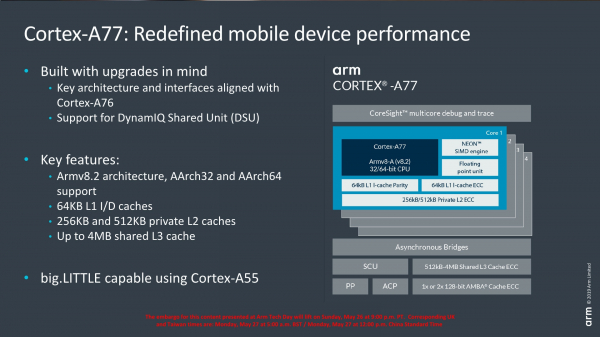
ARM diseñó Cortex-A77 para funcionar en conjunto 4+4 big.LITTLE (4 núcleos potentes y 4 núcleos simples y eficientes en energía). Sin embargo, debido al área aumentada de la nueva arquitectura, muchos fabricantes por motivos de ahorro pueden presentar configuraciones 1+3+4 o 2+2+4, que ya se están utilizando activamente, donde solo uno o dos núcleos serán A77 completos sin recortes.
Fuente: 3dnews.ru
