

Hola a todos. Soy administrador de sistemas principal en OK y soy responsable del funcionamiento estable del portal. Quiero contarles cómo establecimos el proceso de reemplazo automático de discos y luego cómo excluimos al administrador de este proceso y lo reemplazamos con un bot.
Este artículo es una especie de transliteración en HighLoad+ 2018
Construcción del proceso de reemplazo de discos
Primero, un poco de cifras
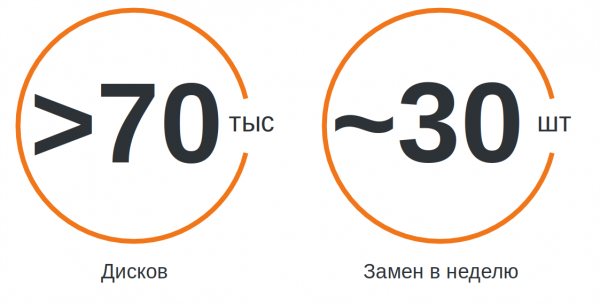
OK es un servicio gigantesco que utilizan millones de personas. Se opera con aproximadamente 7,000 servidores ubicados en 4 diferentes centros de datos. En los servidores hay más de 70,000 discos. Si los apilamos, tendríamos una torre de más de 1 km de altura.
Los discos duros son el componente del servidor que más falla. Con estos volúmenes, tenemos que reemplazar alrededor de 30 discos a la semana, y este procedimiento se ha convertido en una rutina no muy agradable.
Incidentes
En nuestra empresa hemos implementado una gestión de incidentes completa. Cada incidente lo registramos en Jira, lo resolvemos y lo analizamos. Si un incidente afectó a los usuarios, definitivamente nos reunimos y pensamos en cómo reaccionar más rápido en tales casos, cómo reducir el impacto y, por supuesto, cómo prevenir que suceda de nuevo.
Los discos no son una excepción. Su estado es supervisado por Zabbix. Monitoreamos los mensajes en Syslog en busca de errores de lectura/escritura, analizamos el estado de los arreglos HW/SW, y seguimos SMART; para SSD, calculamos el desgaste.
Cómo se cambiaban los discos antes
Cuando se activa algún desencadenador en Zabbix, se crea un incidente en Jira y se asigna automáticamente a los ingenieros correspondientes en los centros de datos. Hacemos esto con todos los incidentes de hardware, es decir, aquellos que requieren algún tipo de trabajo físico con el equipo en el centro de datos.
El ingeniero de centro de datos es la persona que resuelve problemas relacionados con el hardware, es responsable de la instalación, mantenimiento y desmontaje de servidores. Al recibir un ticket, el ingeniero comienza a trabajar. En las estanterías, cambia los discos por sí mismo. Pero si no tiene acceso al dispositivo necesario, el ingeniero se dirige a los administradores de sistemas de guardia por ayuda. Primero, es necesario sacar el disco de rotación. Para ello, hay que realizar los cambios necesarios en el servidor, detener las aplicaciones y desmontar el disco.
El administrador del sistema de guardia es responsable del funcionamiento de todo el portal durante su turno laboral. Investiga incidentes, realiza reparaciones y ayuda a los desarrolladores con pequeñas tareas. Sin embargo, no se encarga de los discos duros.
Anteriormente, los ingenieros del centro de datos se comunicaban con el administrador del sistema a través de un chat. Los ingenieros enviaban enlaces a tickets de Jira, el administrador los revisaba y mantenía un registro de trabajos en alguna libreta. Pero este método no era conveniente para tales tareas: la información no está estructurada y se pierde rápidamente. Además, el administrador podía alejarse del ordenador y no responder durante un tiempo mientras el ingeniero estaba en el servidor con un montón de discos esperando.
Pero lo peor era que los administradores no tenían una visión completa: no sabían qué incidentes relacionados con discos existían ni dónde podría surgir un problema potencial. Esto se debe a que todos los incidentes de hardware los asignamos a los ingenieros. Sí, se podría mostrar todos los incidentes en el tablero del administrador. Pero son demasiados, y el administrador solo era involucrado en algunos de ellos.
Además, el ingeniero no podía priorizar correctamente, ya que no sabía nada sobre la finalidad de los servidores específicos ni sobre la distribución de información en los dispositivos de almacenamiento.
Nuevo procedimiento para el reemplazo
Lo primero que hicimos fue separar todos los incidentes de discos en un tipo diferente llamado "HW-disco" y añadirle los campos "nombre del dispositivo de bloques", "tamaño" y "tipo de disco", para que esta información se guardara en el ticket y no tuviéramos que intercambiarla constantemente en el chat.
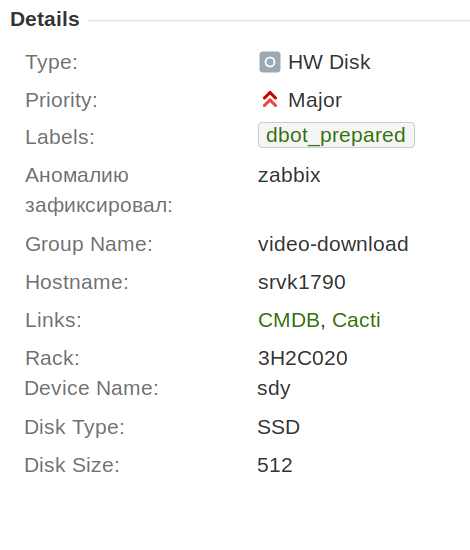
También acordamos que, en un mismo incidente, solo cambiaríamos un disco. Esto simplificó considerablemente el proceso de automatización, la recopilación de estadísticas y el trabajo en el futuro.
Además de esto, se añadió un campo "administrador responsable". Ahí se asigna automáticamente el administrador de guardia. Esto es muy conveniente, porque ahora el ingeniero siempre ve quién es el responsable. No es necesario ir al calendario y buscar. Precisamente este campo permitió que se mostraran en el tablero del administrador los tickets en los que podría necesitar su ayuda.
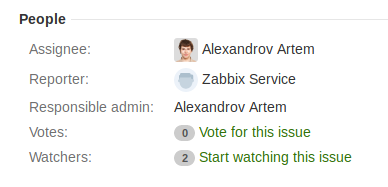
Para que todos los participantes obtengan el máximo beneficio de las innovaciones, creamos filtros y paneles, y se los explicamos a los chicos. Cuando las personas entienden los cambios, no se distancian de ellos como si fueran algo innecesario. Es importante para un ingeniero conocer el número de la estantería donde se encuentra el servidor, así como el tamaño y tipo de disco. Un administrador necesita entender, en primer lugar, qué grupo de servidores es y qué efecto puede tener el reemplazo del disco.
Tener campos y su visualización es práctico, pero no nos ha liberado de la necesidad de utilizar chats. Para ello, tuvimos que cambiar el flujo de trabajo.
Antes era así:
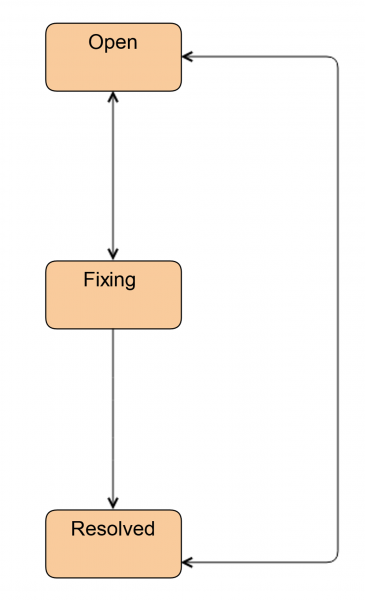
Hoy en día, así siguen trabajando los ingenieros cuando no necesitan la ayuda de un administrador.
Lo primero que hicimos fue introducir un nuevo estado Investigar. En este estado, el ticket se encuentra cuando el ingeniero aún no ha decidido si necesita o no un administrador. A través de este estado, el ingeniero puede transferir el ticket al administrador. Además, usamos este estado para marcar los tickets cuando se requiere el reemplazo del disco, pero el disco mismo no está disponible en el sitio. Esto ocurre en el caso de CDN y sitios remotos.
También agregamos el estado Listo. El ticket se transfiere a este estado después de cambiar el disco. Es decir, todo ya está hecho, pero el HW/SW RAID en el servidor se está sincronizando. Esto puede llevar bastante tiempo.
Si se involucra a un administrador, el esquema se complica un poco.
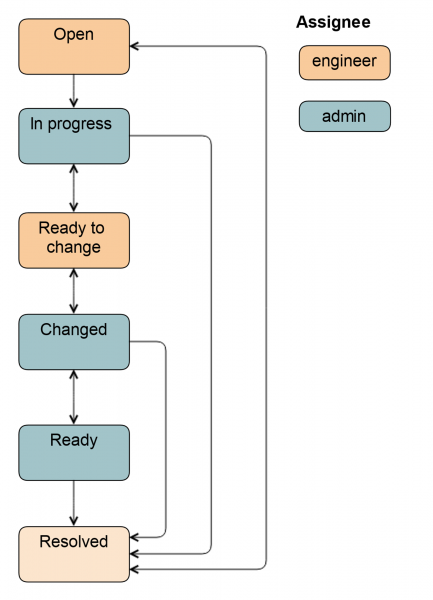
Desde el estado Abrir el ticket puede ser transferido tanto por el administrador del sistema como por el ingeniero. En el estado En progreso el administrador saca el disco de la rotación para que el ingeniero pueda extraerlo fácilmente: activa la luz, desmonta el disco, detiene las aplicaciones, dependiendo del grupo específico de servidores.
Luego el ticket se transfiere a Listo para cambiar: esto es una señal para el ingeniero de que el disco se puede retirar. Todos los campos en Jira ya están completados, el ingeniero sabe qué tipo y tamaño de disco es. Esta información se completa ya sea automáticamente en el estado anterior o por el administrador.
Después de cambiar el disco, el ticket se transfiere al estado Cambiado. Se verifica que se haya insertado el disco correcto, se hace la partición, se inicia la aplicación y algunas tareas de recuperación de datos. Además, el ticket puede ser transferido al estado Listo, en este caso el responsable seguirá siendo el administrador, ya que fue él quien introdujo el disco en rotación. El esquema completo se ve así.
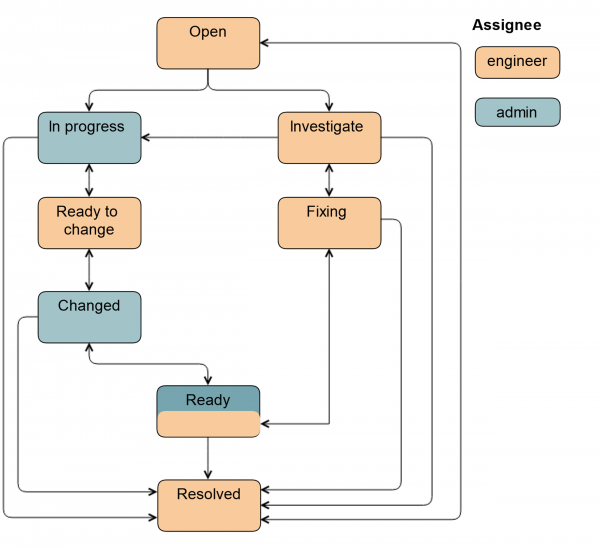
La adición de nuevos campos nos ha facilitado mucho la vida. El equipo ahora trabaja con información estructurada, lo que hace claro qué y en qué etapa se debe hacer. Las prioridades son mucho más relevantes, ya que ahora las establece el administrador.
Ya no es necesario hablar por chat. Por supuesto, el administrador puede escribir al ingeniero "aquí es necesario cambiarlo más rápido", o "ya es tarde, ¿podrás realizar el cambio?". Pero ya no nos comunicamos a diario en chats sobre estos temas.
Los discos se están cambiando en lotes. Si el administrador llega al trabajo un poco antes, tiene tiempo libre y no ha ocurrido nada, puede preparar varios servidores para el cambio: asignar campos, sacar discos de rotación y pasar la tarea al ingeniero. Un poco más tarde, el ingeniero llega al centro de datos, ve la tarea, recoge los dispositivos necesarios del almacén y hace el cambio. Como resultado, la velocidad de reemplazo ha aumentado.
Experiencia adquirida en la creación de Workflow.
- Al construir el procedimiento, es necesario recopilar información de diferentes fuentes.
Algunos de nuestros administradores no sabían que el ingeniero cambia los discos por su cuenta. Algunos pensaban que la sincronización de MD RAID era monitoreada por ingenieros, aunque algunos de ellos ni siquiera tenían acceso para hacerlo. Algunos ingenieros séniores lo hacían, pero no siempre, porque el proceso no estaba descrito en ninguna parte. - El procedimiento debe ser simple y claro.
Es difícil para una persona recordar muchos pasos. Los estados más importantes en Jira deben mostrarse en la pantalla principal. Se pueden renombrar, por ejemplo, In progress lo llamamos Ready to change. Y los demás estados se pueden ocultar en un menú desplegable, para que no distraigan. Pero es mejor no limitar a las personas, permitir que hagan la transición.
Explicar el valor de las innovaciones. Cuando las personas entienden, aceptan mejor el nuevo procedimiento. Para nosotros fue muy importante que las personas no solo hicieran clic en todo el proceso, sino que lo siguieran. Luego construimos la automatización sobre esa base. - Esperar, analizar, comprender.
Nos llevó aproximadamente un mes construir el procedimiento, la implementación técnica, realizar reuniones y discusiones. Y la implementación duró más de tres meses. Vi cómo la gente lentamente comenzó a utilizar la nueva función. En las primeras etapas hubo mucha negatividad. Pero no dependía en absoluto del procedimiento en sí ni de su implementación técnica. Por ejemplo, un administrador utilizaba no Jira, sino un complemento de Jira en Confluence, y algunas cosas no estaban disponibles para él. Le mostramos Jira, y la productividad del administrador mejoró tanto en tareas generales como en el reemplazo de discos.
Automatización del reemplazo de discos
Nos acercamos a la automatización del reemplazo de discos varias veces. Ya teníamos ciertos desarrollos, scripts, pero todos funcionaban ya sea en modo interactivo o manual y requerían ser iniciados. Y solo después de implementar el nuevo procedimiento nos dimos cuenta de que precisamente eso nos hacía falta.
Como ahora el proceso de reemplazo está dividido en etapas, con un responsable y una lista de acciones para cada una, podemos incorporar la automatización por etapas, en lugar de hacerlo todo de una vez. Por ejemplo, la etapa más simple - Ready (verificación de la sincronización RAID/datos) puede delegarse fácilmente a un bot. Cuando el bot aprenda un poco, podemos asignarle una tarea más responsable: introducir el disco en rotación, etc.
Un zoológico de configuraciones
Antes de hablar del bot, hagamos una pequeña excursión a nuestro zoológico de instalaciones. En primer lugar, esto se debe al tamaño gigantesco de nuestra infraestructura. En segundo lugar, para cada servicio tratamos de seleccionar la configuración óptima del hardware. Tenemos alrededor de 20 modelos de RAID de hardware, principalmente LSI y Adaptec, pero también hay HP y DELL de varias versiones. Cada controlador RAID tiene su propia utilidad de gestión. El conjunto de comandos y la salida pueden variar de versión a versión en cada controlador RAID. Allí donde no se utilizan HW-RAID, puede haber mdraid.
Prácticamente todas las nuevas instalaciones las hacemos sin redundancia de discos. Tratamos de no utilizar más RAID de hardware y software, ya que respaldamos nuestros sistemas a nivel de centros de datos y no de servidores. Pero, por supuesto, hay muchos servidores heredados que necesitan mantenimiento.
En algunos casos, los discos en los controladores RAID se conectan como dispositivos en bruto, mientras que en otros se utilizan JBOD. Existen configuraciones con un solo disco del sistema en el servidor, y si es necesario reemplazarlo, se tiene que reinstalar el servidor con la instalación del sistema operativo y las aplicaciones, incluyendo las mismas versiones, luego agregar los archivos de configuración y ejecutar las aplicaciones. También hay muchos grupos de servidores donde la redundancia no se realiza a nivel de subsistema de disco, sino directamente en las propias aplicaciones.
En total, tenemos más de 400 grupos únicos de servidores que ejecutan alrededor de 100 aplicaciones diferentes. Para cubrir una cantidad tan enorme de opciones, necesitábamos una herramienta de automatización multifuncional. Preferiblemente con un DSL simple, de modo que no solo pudiera ser mantenida por quien la escribió.
Elegimos Ansible porque es sin agente: no había necesidad de preparar la infraestructura, es de inicio rápido. Además, está escrito en Python, que es el estándar en el equipo.
Esquema general
Veamos un esquema general de automatización utilizando un ejemplo de un incidente. Zabbix detecta que el disco sdb ha fallado, se activa un disparador y se crea un ticket en Jira. El administrador lo revisa, se da cuenta de que no es un duplicado ni un falso positivo, es decir, que es necesario cambiar el disco, y mueve el ticket a En progreso.
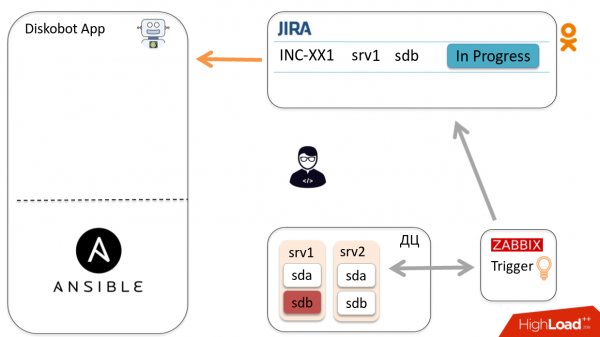
La aplicación DiskoBot, escrita en Python, consulta periódicamente Jira en busca de nuevos tickets. Observa que hay un nuevo ticket en progreso, se activa el hilo correspondiente que ejecuta el playbook en Ansible (esto se hace para cada estado en Jira). En este caso, se ejecuta Prepare2change.
Ansible se envía al host, saca el disco de rotación e informa el estado a la aplicación a través de Callbacks.
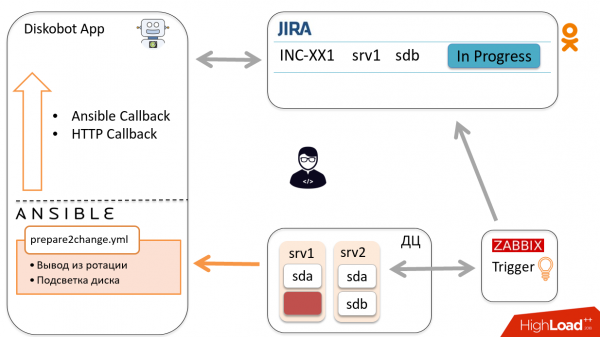
Como resultado, el bot mueve automáticamente el ticket a Listo para cambiar. El ingeniero recibe una notificación y se dirige a cambiar el disco, después de lo cual mueve el ticket a Cambiado.
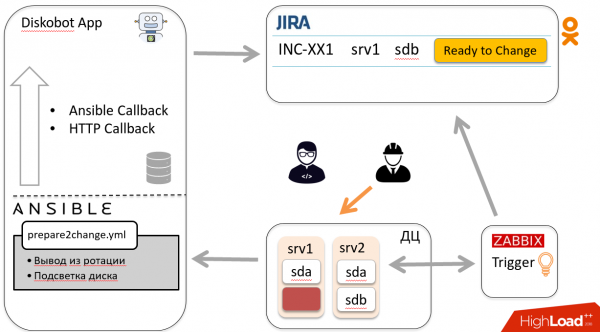
Siguiendo el esquema descrito, el ticket regresa al bot, que ejecuta otro playbook, accede al host y pone el disco de nuevo en rotación. El bot cierra el ticket. ¡Hurra!
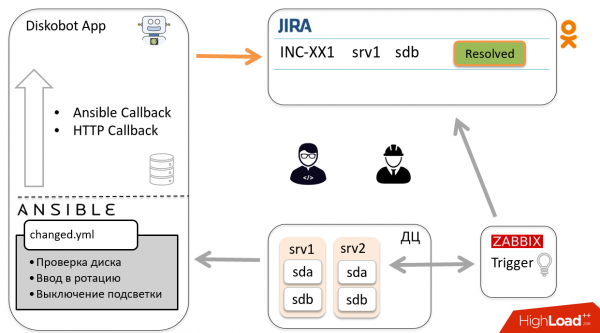
Ahora hablemos de algunos componentes del sistema.
Diskobot
Esta aplicación está escrita en Python. Selecciona tickets de Jira de acuerdo con JQL. Dependiendo del estado del ticket, este se asigna al manejador correspondiente, que a su vez ejecuta el playbook de Ansible correspondiente al estado.
JQL y los intervalos de encuesta se definen en el archivo de configuración de la aplicación.
jira_states:
  investigate:
    jql: '… status = Open and "Disk Size" is EMPTY'
    interval: 180

  inprogress:
    jql: '…  and "Disk Size" is not EMPTY and "Device Name" is not EMPTY'

  ready:
    jql: '… and (labels not in ("dbot_ignore") or labels is EMPTY)'
    interval: 7200
Por ejemplo, entre los tickets en estado En progreso, se seleccionan solo aquellos cuyos campos Disk size y Device name están completos. Device name es el nombre del dispositivo de bloque necesario para ejecutar el playbook. Disk size es necesario para que el ingeniero sepa qué tamaño de disco se requiere.
Y entre los tickets con estado Listo se filtran los tickets con la etiqueta dbot_ignore. Cabe mencionar que utilizamos las etiquetas de Jira tanto para este tipo de filtrado como para marcar tickets duplicados y recopilar estadísticas.
En caso de fallo del playbook, Jira asigna la etiqueta dbot_failed para que se pueda investigar posteriormente.
Interacción con Ansible
La aplicación interactúa con Ansible a través de . En el playbook_executor pasamos el nombre del archivo y un conjunto de variables. Esto permite mantener el proyecto de Ansible en forma de archivos yml comunes, en lugar de describirlo en código Python.
Además, en Ansible se pasan a través de *extra_vars* el nombre del dispositivo de bloque, el estado del ticket y el callback_url, en el que está incrustado el issue key, que se utiliza para el callback en HTTP.
Para cada ejecución se genera un inventario temporal, que consiste en un solo host y un grupo que incluye este host, para que se apliquen group_vars.
Aquí hay un ejemplo de tarea en la que se implementa el callback HTTP.
Los resultados de la ejecución de los playbooks los obtenemos a través de callback(-s). Hay dos tipos:
- , proporciona datos sobre los resultados de la ejecución del playbook. Describe las tareas que se han iniciado, ejecutadas con éxito o fallidas. Este callback se llama al finalizar la ejecución del playbook.
- Callback HTTP para obtener información durante la ejecución del playbook. En la tarea de Ansible hacemos una solicitud POST/GET hacia nuestra aplicación.
A través de callbacks HTTP se pasan las variables que se definieron durante la ejecución del playbook y que queremos guardar y utilizar en ejecuciones posteriores. Estos datos los escribimos en sqlite.
También a través del callback HTTP dejamos comentarios y cambiamos el estado del ticket.
Callback HTTP
# Make callback to Diskobot App
# Variables:
#    callback_post_body: # A dict with follow keys. All keys are optional
#       msg: If exist it would be posted to Jira as comment
#       data: If exist it would be saved in Incident.variables
#       desire_state: Set desire_state for incident
#       status: If exist Proceed issue to that status

  - name: Callback to Diskobot app (jira comment/status)
    uri:
      url: "{{ callback_url }}/{{ devname }}"
      user: "{{ diskobot_user }}"
      password: "{{ diskobot_pass }}"
      force_basic_auth: True
      method: POST
      body: "{{ callback_post_body | to_json }}"
      body_format: json
    delegate_to: 127.0.0.1
Al igual que muchas tareas similares, lo sacamos a un archivo común y lo incluimos cuando es necesario, para no repetir constantemente en los playbooks. Aquí aparece el callback_url, que contiene la clave del issue y el nombre del host. Cuando Ansible realiza esta solicitud POST, el bot entiende que ha llegado en el marco de tal incidente.
Aquí hay un ejemplo de un playbook en el que sacamos el disco de un dispositivo MD:
  # Save mdadm configuration
  - include: common/callback.yml
    vars:
      callback_post_body:
        status: 'Ready to change'
        msg: "Removed disk from mdraid {{ mdadm_remove_disk.msg | comment_jira }}"
        data:
          mdadm_data: "{{ mdadm_remove_disk.removed }}"
          parted_info: "{{ parted_info | default() }}"
    when:
      - mdadm_remove_disk | changed
      - mdadm_remove_disk.removed
Esta tarea cambia el estado del ticket de Jira a "Listo para cambiar" y añade un comentario. También, en la variable mdam_data se guarda la lista de dispositivos md de los cuales se ha eliminado el disco, y en parted_info — un volcado de la partición desde parted.
Cuando el ingeniero inserte un nuevo disco, podremos utilizar estas variables para restaurar el volcado de las particiones, así como registrar el disco en aquellos dispositivos md de los que fue eliminado.
Modo de verificación de Ansible
Activar la automatización era aterrador. Por lo tanto, decidimos ejecutar todos los playbooks en modo
, en el que Ansible no realiza ninguna acción en los servidores, solo las emula.
Este inicio se ejecuta a través de un módulo de callback separado, y guardamos el resultado de la ejecución del playbook en Jira como un comentario.
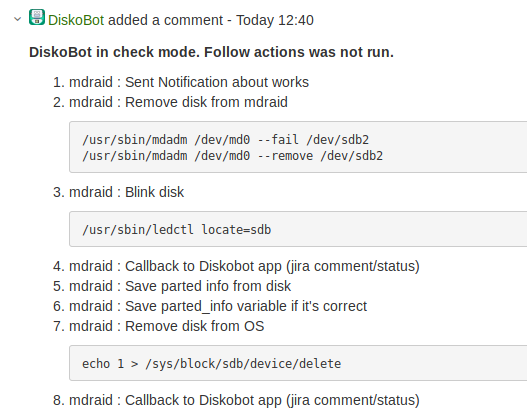
En primer lugar, esto permitió validar el funcionamiento del bot y los playbooks. En segundo lugar, aumentó la confianza de los administradores en el bot.
Cuando pasamos la validación y entendimos que se podía ejecutar Ansible no solo en modo de prueba, creamos en Jira un botón "Ejecutar Diskobot" para lanzar el mismo playbook con las mismas variables en el mismo host, pero en modo normal.
Además, el botón se utiliza para reiniciar el playbook en caso de que falle.
Estructura de los Playbooks
Ya mencioné que, dependiendo del estado del ticket de Jira, el bot ejecuta diferentes playbooks.
En primer lugar, es mucho más fácil organizar la entrada.
En segundo lugar, en algunos casos, es simplemente necesario.
Por ejemplo, al reemplazar el disco del sistema, primero hay que ir al sistema de despliegue, crear una tarea, y después de un despliegue correcto, el servidor estará disponible por ssh, y se podrá implementar la aplicación. Si hiciéramos todo esto en un solo playbook, Ansible no podría ejecutarlo debido a la inaccesibilidad del host.
Utilizamos roles de Ansible para cada grupo de servidores. Aquí se puede ver cómo están organizados los playbook(s) en uno de ellos.
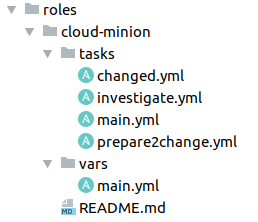
Es conveniente porque se puede ver de inmediato dónde están ubicadas las tareas. En main.yml, que es la entrada para el rol de Ansible, podemos tener simplemente un include según el estado del ticket o tareas generales necesarias para todos, como la identificación o la obtención de un token.
Investigation.yml
Se ejecuta para tickets en estado de Investigación y Abierto. Lo más importante para este playbook es el nombre del dispositivo de bloque. Esta información no siempre está disponible.
Para obtenerla, analizamos el resumen de Jira, el último valor del trigger de Zabbix. Puede contener el nombre del dispositivo de bloque — si tenemos suerte. También puede contener un punto de montaje; entonces, es necesario ir al servidor, analizar y calcular el disco necesario. Además, el trigger puede transmitir la dirección SCSI o alguna otra información. Pero a veces no hay ninguna pista y hay que analizar.
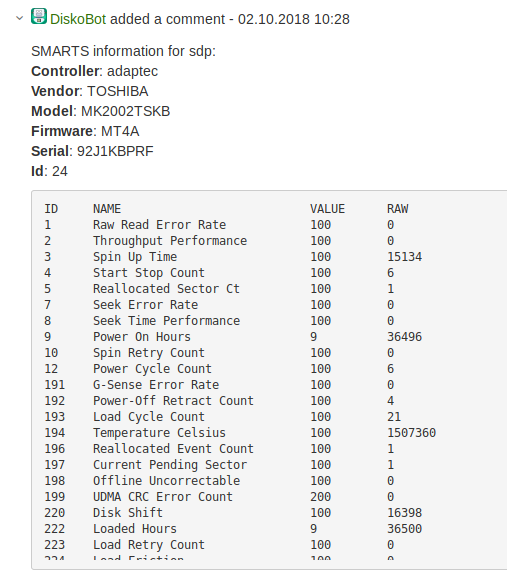
Una vez que tenemos el nombre del dispositivo de bloque, recopilamos información sobre el tipo y tamaño del disco para llenar los campos en Jira. También recolectamos información sobre el vendedor, modelo, firmware, ID, SMART, y todo esto lo insertamos en el comentario del ticket de Jira. Así, el administrador y el ingeniero no necesitan buscar esta información. 🙂
prepare2change.yml
Sacar el disco de la rotación, preparándose para el reemplazo. Es la etapa más difícil y crucial. Aquí es donde se puede detener la aplicación cuando no se puede detener. O extraer el disco que no tenía suficientes réplicas, afectando así a los usuarios y perdiendo algunos datos. Aquí tenemos la mayor cantidad de verificaciones y notificaciones en el chat.
En el caso más simple, se trata de eliminar el disco del RAID HW/MD.
En situaciones más complejas (en nuestros sistemas de almacenamiento), cuando la redundancia se realiza a nivel de aplicación, es necesario comunicarse con la aplicación a través de la API, informar sobre la desconexión del disco, desactivarlo y comenzar la recuperación.
Estamos migrando masivamente a , y si el servidor es en la nube, Diskobot se comunica con la API de la nube, indica que va a trabajar con este minion — el servidor donde se ejecutan los contenedores — y pide 'migrar todos los contenedores de este minion'. Y además activa la iluminación del disco para que el ingeniero vea de inmediato cuál necesita ser extraído.
changed.yml
Después de reemplazar el disco, primero verificamos su disponibilidad.
Los ingenieros no siempre instalan discos nuevos, por lo que añadimos una verificación de los valores SMART que nos satisfacen.
¿Qué atributos estamos observando?Cuenta de Sectores Reasignados (5) < 100
Cuenta de Sectores Pendientes Actuales (107) == 0
Si el disco no pasa la verificación, se informa al ingeniero para su reemplazo. Si todo está bien, se apaga la luz indicadora, se marca y se introduce el disco en rotación.
ready.yml
El caso más sencillo: verificar la sincronización de RAID HW/SW o la finalización de la sincronización de datos en la aplicación.
API de aplicaciones
He mencionado varias veces que el bot a menudo se conecta a la API de aplicaciones. Claro, no todas las aplicaciones tenían los métodos necesarios, por lo que tuvimos que desarrollarlos. Aquí están los métodos más importantes que usamos:
- Estado. El estado del clúster o del disco para entender si se puede trabajar con él;
- Iniciar/detener. Activar/desactivar disco;
- Migrar/restaurar. Migración y recuperación de datos durante y después del reemplazo.
Experiencia adquirida sobre Ansible
Me encanta Ansible. Pero a menudo, cuando miro diferentes proyectos de código abierto y veo cómo la gente escribe playbooks, me asusta un poco. Enredos lógicos complejos de when/loop, falta de flexibilidad e idempotencia debido al uso frecuente de shell/command.
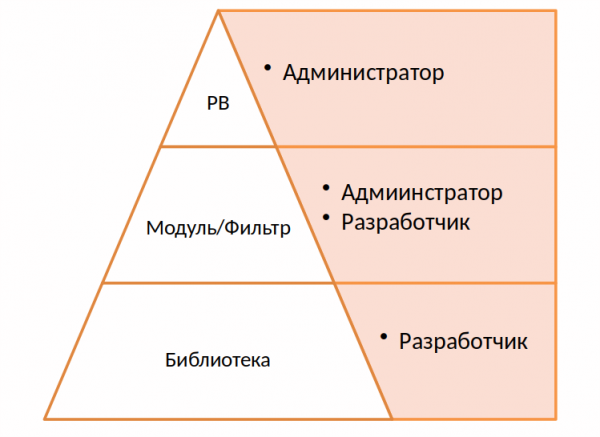
Decidimos simplificar todo lo posible, aprovechando la ventaja de Ansible: la modularidad. En el nivel más alto están los playbooks, que puede escribir cualquier administrador o desarrollador externo que sepa un poco de Ansible.
- name: Parpadear disco
  become: True
  register: locate_action
  disk_locate:
      locate: '{{ locate }}'
      devname: '{{ devname }}'
      ids: '{{ locate_ids | default(pd_id) | default(omit) }}'
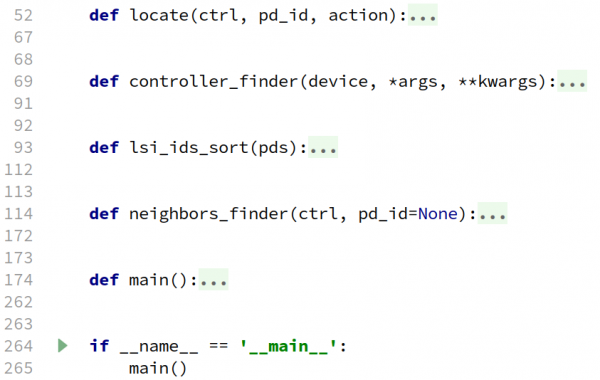
Si alguna lógica es difícil de implementar en los playbooks, la llevamos a un módulo o filtro de Ansible. Los scripts pueden escribirse tanto en Python como en cualquier otro lenguaje.
Son fáciles y rápidos de escribir. Por ejemplo, el módulo para hacer parpadear el disco, cuyo ejemplo de uso se presenta arriba, consta de 265 líneas.
En el nivel más bajo se encuentra la biblioteca. Para este proyecto, escribimos una aplicación separada, una especie de abstracción sobre RAID de hardware y software, que realiza las solicitudes adecuadas.
Las mayores fortalezas de Ansible son la simplicidad y los playbooks claros. Creo que se debe aprovechar esto y no generar horribles archivos yaml y una gran cantidad de condiciones, código shell y loops.
Si deseas replicar nuestra experiencia con la API de Ansible, ten en cuenta dos cosas:
- No se puede pasar un tiempo de espera a Playbook_executor y, en general, a playbook. Hay un tiempo de espera en sesiones SSH, pero no hay un tiempo de espera para el playbook. Si intentamos desmontar un disco que ya no existe en el sistema, el playbook seguirá ejecutándose indefinidamente, por lo que tuvimos que envolver su ejecución en un wrapper separado y detenerlo por tiempo de espera.
- Ansible funciona sobre la base de procesos fork, por lo que su API no es segura para múltiples hilos. Ejecutamos todos nuestros playbooks en un solo hilo.
Como resultado, logramos automatizar la sustitución de aproximadamente el 80% de los discos. En general, la velocidad de reemplazo se ha duplicado. Hoy en día, el administrador solo observa el incidente y decide si debe cambiar el disco o no, y luego hace un solo clic.
Pero ahora empezamos a enfrentarnos a otro problema: algunos de los nuevos administradores no saben cómo cambiar discos. 🙂
Fuente: habr.com
