

El componente ETL del almacén de datos a menudo queda en la sombra del propio almacén y se le presta menos atención que a la base de datos principal o al componente frontal, BI, y la generación de informes. Sin embargo, desde la perspectiva de la mecánica de llenado del almacén con datos, ETL juega un papel clave y requiere no menos atención por parte de los administradores que los otros componentes. Me llamo Alexander, actualmente administro ETL en Rostelecom, y en este artículo intentaré compartir un poco de lo que enfrenta un administrador de uno de los sistemas ETL más conocidos en un gran almacén de datos de la empresa Rostelecom.
Si los respetados lectores ya están familiarizados en general con nuestro proyecto de almacén de datos y con el producto Informatica PowerCenter, pueden saltar directamente a la siguiente sección.
Hace unos años, se gestó y comenzó a materializarse en Rostelecom la idea de un almacén de datos corporativo unificado. Se habían creado una serie de almacenes que resolvían tareas específicas, pero el número de escenarios estaba creciendo, los costos de mantenimiento también aumentaban, y se hizo evidente que el futuro pertenecía a la centralización. Arquitectónicamente, este almacén consiste en varias capas, realizado sobre Hadoop y GreenPlum, bases de datos auxiliares, mecanismos ETL y BI.
Debido a la gran cantidad de fuentes de datos distribuidas territorialmente y heterogéneas, se creó un mecanismo especial de extracción de datos, cuya operación es gestionada por Informatica. Como resultado, los paquetes de datos llegan a la zona de interfaz de Hadoop, tras lo cual comienzan los procesos de carga de datos a través de las capas del almacén, en Hadoop y GreenPlum, que son gestionados por el llamado mecanismo controlador ETL, implementado en Informatica. Así, el sistema Informatica se convierte en uno de los elementos clave que aseguran el funcionamiento del almacén.
Se hablará más en detalle sobre nuestro almacén en una de las próximas publicaciones.
Informatica PowerCenter/Big Data Management se considera actualmente el software líder en el ámbito de las herramientas de integración de datos. Este es un producto de la empresa estadounidense Informatica, que es uno de los actores más fuertes en ETL (Extract Transform Load), gestión de calidad de datos, MDM (Master Data Management), ILM (Information Lifecycle Management) y más.
El PowerCenter que utilizamos es un servidor de aplicaciones Tomcat integrado, en el que funcionan las aplicaciones de Informatica que implementan sus servicios:
Dominio, que en esencia es la base para todo lo demás, dentro del dominio funcionan los servicios, los usuarios y los componentes GRID.
Consola de Administrador, una herramienta web de gestión y monitoreo, además del cliente Informatica Developer, que es la herramienta principal para interactuar con el producto.
MRS, Servicio de Repositorio de Modelos, un almacén de metadatos, sirve como intermediario entre la base de datos donde se almacenan físicamente los metadatos y el cliente Informatica Developer, en el que se lleva a cabo el desarrollo. Los repositorios almacenan tanto la descripción de los datos como otra información, incluyendo para varios otros servicios de Informatica, como por ejemplo, la programación de ejecuciones de trabajos (Schedules) o datos de monitoreo, así como conjuntos de parámetros de aplicaciones, que permiten usar la misma aplicación para trabajar con diversas fuentes y receptores de datos.
DIS, Servicio de Integración de Datos, este es el servicio en el que ocurren los procesos funcionales principales, donde operan las aplicaciones y se llevan a cabo los lanzamientos de Workflows (descripciones de secuencias de mappings y su interacción) y Mappings (transformaciones, bloques en los que ocurren las propias transformaciones y procesamiento de datos).
Configuración GRID – esencialmente, es una opción de construir un complejo utilizando varios servidores, donde la carga, llevada a cabo por el DIS, se distribuye entre nodos (es decir, servidores que forman parte del dominio). En este tipo de configuración, además de la distribución de la carga en el DIS a través de una capa adicional de abstracción GRID, que une varios nodos, en la que opera el DIS en lugar de funcionar en un nodo específico, también se pueden crear instancias de MRS adicionales para respaldo. Se puede incluso implementar alta disponibilidad, donde las solicitudes externas pueden realizarse a través de nodos de respaldo en caso de falla del nodo principal. Hemos decidido no seguir este tipo de construcción por ahora.
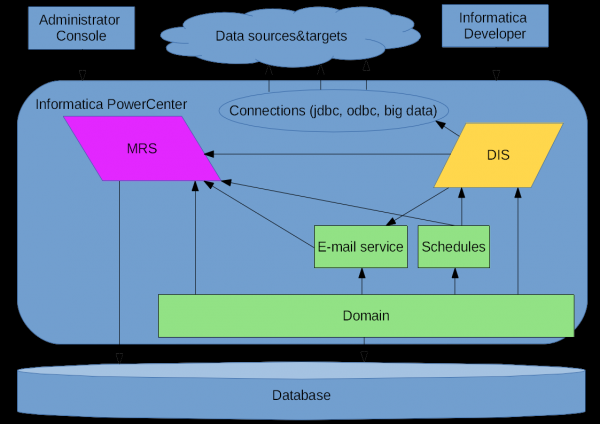
Informatica PowerCenter, esquemáticamente
En las primeras etapas de trabajo dentro de la cadena de suministro de datos, surgieron regularmente problemas, algunos de ellos debido al funcionamiento inestable de Informatica en ese momento. Voy a compartir algunos de los momentos memorables de esta saga: el aprendizaje de Informatica 10.
El antiguo logotipo de Informatica
El ámbito de responsabilidad de nuestra área también incluye otros entornos de Informatica, los cuales tienen sus propias especificaciones debido a diferentes cargas; por ahora, recordaré cómo ha evolucionado Informatica como componente ETL del propio almacén de datos.
¿Cómo ocurrió esto?
En 2016, cuando empezamos a encargarnos de la operación de Informatica, ya había alcanzado la versión 10.0 y, para los colegas optimistas que tomaron la decisión de utilizar un producto con una versión menor .0, todo parecía obvio: ¡era necesario usar la nueva versión! Desde el punto de vista de recursos de hardware, todo estaba en excelente estado en ese momento.
Desde la primavera de 2016, un contratista se hizo responsable de la operación de Informatica, y según las palabras de unos pocos usuarios del sistema, "funcionaba un par de veces por semana". Es necesario aclarar que el almacén estaba de facto en la etapa de PoC, no había administradores en el equipo y el sistema caía constantemente por diversas razones, después de lo cual el ingeniero del contratista lo reiniciaba.
En otoño, se unieron al equipo tres administradores, quienes repartieron las áreas de responsabilidad, comenzando a establecer un funcionamiento normal para la explotación de los sistemas en el proyecto, incluida Informatica. Es importante mencionar que este producto no es ampliamente utilizado y no tiene una gran comunidad donde se puedan encontrar respuestas a todas las preguntas y resolver cualquier problema. Por lo tanto, el soporte técnico integral del socio ruso de Informatica se volvió crucial, ya que ayudó a corregir todos nuestros errores y los errores de la entonces joven Informatica 10.
Lo primero que tuvimos que hacer para los desarrolladores de nuestro equipo y el contratista fue estabilizar el funcionamiento de la propia Informatica, logrando que la consola web de administración (Informatica Administrator) funcionara correctamente.
Así fue como los desarrolladores de Informatica nos encontraron con frecuencia.
Dejando de lado el propio proceso de averiguación de las causas, la principal razón de las caídas fue el esquema de interacción del software Informatica con la base de datos del repositorio, que se encontraba en un servidor relativamente remoto, desde la perspectiva del paisaje de red. Esto provocaba retrasos y afectaba el funcionamiento de los mecanismos que aseguraban el control del estado del dominio Informatica. Tras un cierto ajuste de la base de datos, y la modificación de los parámetros de Informatica para hacerla más tolerante a los retrasos de la base de datos, y, finalmente, después de actualizar la versión de Informatica a 10.1 y trasladar la base de datos desde el servidor anterior a uno más cercano a Informatica, el problema perdió relevancia, y desde entonces no hemos observado caídas de este tipo.
Uno de los intentos de hacer funcionar Informatica Monitor
La situación con la consola de administración también era crítica. Dado que se estaba llevando a cabo un desarrollo activo directamente en un entorno que se consideraba productivo, los colegas tenían constantemente la necesidad de analizar el funcionamiento de los mappings y workflows ‘sobre la marcha’. En la nueva Informatica, en el Data Integration Service no hay una herramienta separada para dicho monitoreo, pero en la consola web de administración ha aparecido una sección de monitoreo (Informatica Administrator Monitor), donde se puede observar el funcionamiento de las aplicaciones, workflows y mappings, así como los inicios y logs. Periódicamente, la consola se volvía completamente inaccesible, o dejaban de actualizarse los datos sobre los procesos actuales en DIS, o surgían errores al cargar las páginas.
Ajuste de parámetros de java para estabilizar el funcionamiento
La corrección del problema se abordó por múltiples caminos: se realizaron experimentos modificando parámetros, se recopilaron logs, jstack, se enviaron al soporte, y paralelamente se realizaba una búsqueda activa en Google y simplemente se hacía observación.
En primer lugar, se creó un MRS separado para el monitoreo, que después resultó ser uno de los principales consumidores de recursos en nuestros entornos, ya que los lanzamientos de mappings ocurren de manera muy intensa. Se modificaron los parámetros relacionados con el heap de java y otros varios.
Como resultado, para la siguiente actualización de Informatica 10.1.1 se logró estabilizar el funcionamiento de la consola y el monitor, los desarrolladores comenzaron a trabajar de manera más eficiente, y los procesos regulares se volvían cada vez más regulares.
La experiencia de la interacción entre desarrollo y administración puede resultar interesante. La comprensión general de cómo funciona todo, qué se puede hacer y qué no, siempre es importante al trabajar con sistemas complejos. Por lo tanto, es recomendable capacitar primero al equipo de administradores en cómo se debe gestionar el software, y al equipo de desarrolladores en cómo escribir código y diseñar procesos en el sistema, y solo después enviar a ambos grupos a trabajar en resultados. Esto es realmente importante cuando el tiempo no es un recurso infinito. Muchos problemas pueden resolverse incluso mediante pruebas aleatorias, pero a veces algunos requieren conocimientos previos; nuestro caso confirma la importancia de entender este axioma.
Por ejemplo, al intentar activar la versionación en MRS (como resultó ser, necesitábamos otra versión de SVN), tras un tiempo alarmante, descubrimos que el tiempo de reinicio del sistema había aumentado a varios minutos. Al identificar la causa de la demora en el arranque y desactivar la versionación, todo volvió a funcionar bien.
Un obstáculo notable relacionado con Informatica fue la épica batalla con los crecientes hilos de Java. En algún momento llegó la hora de la replicación, es decir, extender los procesos establecidos a un gran número de sistemas fuente. Sin embargo, resultó que no todos los procesos en 10.1.1 funcionaban correctamente, y después de un tiempo DIS dejaba de ser operativo. Se encontraban decenas de miles de hilos, y su número aumentaba especialmente durante el procedimiento de despliegue de aplicaciones. A veces hubo que reiniciar varias veces al día para restaurar la funcionalidad.
Aquí debemos agradecer al soporte, ya que los problemas fueron localizados y corregidos relativamente rápido con la ayuda de EBF (Emergency Bug Fix); después de esto, todos tuvieron la sensación de que la herramienta realmente funcionaba.
¡Todavía funciona!
Al inicio del trabajo en modo objetivo, Informatica se veía de la siguiente manera. Versión de Informatica 10.1.1HF1 (HF1 es HotFix1, una compilación del proveedor del conjunto de EBF) con EBF adicionales instalados, que solucionaban nuestros problemas de escalabilidad y algunos otros, en un servidor de los tres incluidos en la GRID, 20 núcleos x86_64 y almacenamiento en un enorme y lento conjunto de discos locales — esto es configuración del servidor para el clúster de Hadoop. En otro servidor similar, se encuentra la base de datos Oracle con la cual trabaja el dominio de Informatica y el mecanismo de gestión ETL. Todo esto se monitorea con herramientas de monitoreo estándar utilizadas en el equipo (Zabbix + Grafana), desde dos perspectivas: tanto Informatica y sus servicios, como los procesos de carga que entran en ella. En este momento, tanto el rendimiento como la estabilidad de la operación, sin tener en cuenta factores externos, dependen de las configuraciones que limitan la carga.
Se puede comentar por separado sobre GRID. El entorno se construyó sobre tres nodos, con la posibilidad de equilibrar la carga. Sin embargo, durante las pruebas se descubrió que, debido a problemas de interacción entre las instancias de nuestras aplicaciones que se ejecutaban, esta configuración no funcionó como se esperaba, y temporalmente decidimos renunciar a este esquema de construcción, sacando dos de los tres nodos del dominio. Sin embargo, el esquema en sí se mantuvo, y ahora es un servicio GRID, aunque reducido a un nodo.
En este momento, permanece la complejidad relacionada con la caída del rendimiento durante la limpieza regular del esquema del monitor; cuando hay procesos en paralelo en el CHN y la limpieza se inicia, pueden surgir fallas en el funcionamiento del mecanismo de gestión ETL. Por ahora, se resuelve de manera 'improvisada' — limpieza manual del esquema del monitor, perdiendo todos sus datos anteriores. Esto no es demasiado crítico para la productividad, en condiciones de funcionamiento normal, pero todavía se busca una solución adecuada.
De esta situación también surge otro problema: a veces ocurren múltiples lanzamientos de nuestro mecanismo de gestión.
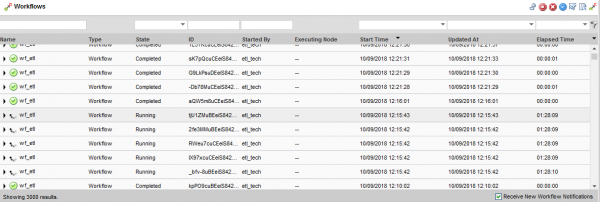
Múltiples lanzamientos de la aplicación que llevan a la falla del mecanismo.
Al ejecutarse según un horario, en momentos de alta carga en el sistema, a veces ocurren situaciones que provocan la falla del mecanismo. Hasta ahora, el problema se corrige manualmente, y se está buscando una solución permanente.
En general, se puede resumir que, con una alta carga, es muy importante proporcionar recursos adecuados para ello, lo que se aplica tanto a los recursos hardware para Informatica como a su base de datos, así como asegurar configuraciones óptimas para ambos. Además, queda abierta la cuestión de cuál esquema de colocación de la base de datos es mejor: en un host separado o en el mismo donde opera el software Informatica. Por un lado, tener todo en un solo servidor resulta más económico, y al combinar se elimina prácticamente el problema posible de la interacción en red; por otro lado, la carga del host por parte de la base de datos se ve complementada por la carga de Informatica.
Como en cualquier producto serio, en Informatica también hay momentos curiosos.
Una vez, al investigar algún accidente, noté que en los logs de MRS estaba extraño marcado el tiempo de los eventos.
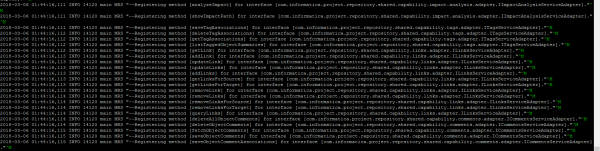
Dualidad temporal en los logs de MRS “por diseño”
Resultó que las marcas de tiempo se escriben en un formato de 12 horas, sin indicar AM/PM, es decir, antes o después del mediodía. Incluso se abrió un ticket al respecto y se obtuvo una respuesta oficial: así estaba diseñado, las marcas en los logs de MRS se escriben precisamente en ese formato. Es decir, a veces queda cierto misterio respecto a la hora de ocurrencia de algún ERROR…
Aspirar a lo mejor
Hoy en día, Informatica es una herramienta bastante estable, cómoda para administradores y usuarios, y extremadamente poderosa en términos de capacidades actuales y potencial. Supera con creces nuestras necesidades funcionales y, de facto, actualmente se utiliza en el proyecto de una manera no muy común y típica. Las dificultades se deben en parte a cómo funcionan los mecanismos: la especificidad es que en un corto período de tiempo se inician una gran cantidad de hilos que actualizan intensamente los parameterset y trabajan con la base de datos del repositorio, al mismo tiempo que los recursos hardware del servidor son prácticamente completamente utilizados por la CPU.
Actualmente estamos a punto de migrar a Informatica 10.2.1 o 10.2.2, en las cuales se han reescrito algunos mecanismos internos, y el soporte promete la ausencia de una serie de problemas de rendimiento y funcionamiento que actualmente tenemos. Además, desde el punto de vista hardware, se esperan servidores con una configuración óptima para nosotros, teniendo en cuenta la reserva para el próximo tiempo debido al crecimiento y desarrollo del almacenamiento.
Por supuesto, se realizarán pruebas, verificación de compatibilidad, y posiblemente, cambios arquitectónicos en la parte de HA GRID. El desarrollo en el marco de Informatica continuará, ya que a corto plazo no podemos reemplazar el sistema.
Y aquellos que en el futuro sean responsables de este sistema, seguramente lograrán llevarlo a los niveles requeridos de confiabilidad y rendimiento exigidos por los clientes.
Este artículo fue preparado por el equipo de gestión de datos de «Rostelecom»
Logotipo actual de Informatica
Fuente: habr.com
