

¡Lo logramos!
«El objetivo de este curso es prepararte para tu futuro técnico.»
 Hola, Habr. ¿Recuerdas aquel increíble artículo? (+219, 2588 en favoritos, 429k lecturas)?
Así que, sobre los códigos de Hamming (sí, sí, los autorreguladores y autocorrectores ) hay todo un , escrito basado en sus conferencias. Lo estamos traduciendo, porque el tipo sabe de lo que habla.
Este libro no es solo sobre TI, es un libro sobre el estilo de pensamiento de personas increíblemente geniales. «No es solo una carga de pensamiento positivo; describe las condiciones que aumentan las posibilidades de hacer un gran trabajo.»
Gracias a Andrey Pakhomov por la traducción.
La Teoría de la Información fue desarrollada por C. E. Shannon a finales de 1940. La dirección de Bell Labs insistió en que la llamara 'Teoría de la Comunicación', ya que es un nombre mucho más preciso. Por razones obvias, el nombre 'Teoría de la Información' tiene un impacto significativamente mayor en el público, por lo que Shannon eligió este nombre, y es así como se conoce hasta el día de hoy. El propio nombre implica que la teoría trata sobre información, lo que la hace importante, ya que nos adentramos cada vez más en la era de la información. En este capítulo, haré algunas conclusiones fundamentales de esta teoría, proporcionaré pruebas no estrictas, sino más bien intuitivas de algunas proposiciones individuales de esta teoría, para que entiendan qué es realmente la 'Teoría de la Información', dónde pueden aplicarla y dónde no.
Primero que todo, ¿qué es la 'información'? Shannon identifica la información con la incertidumbre. Elegió el logaritmo negativo de la probabilidad de un evento como medida cuantitativa de la información que recibes al ocurrir un evento con probabilidad p. Por ejemplo, si te digo que en Los Ángeles hay niebla, entonces p está cerca de 1, lo que en gran medida no nos da mucha información. Pero si te digo que en junio llueve en Monterrey, entonces esa declaración tendrá incertidumbre y contendrá más información. Un evento seguro no contiene información, ya que log 1 = 0.
Detengámonos en esto con más detalle. Shannon creía que la medida cuantitativa de la información debía ser una función continua de la probabilidad del evento p, y que para eventos independientes debería ser aditiva: la cantidad de información obtenida a raíz de la realización de dos eventos independientes debería ser igual a la cantidad de información obtenida a través de la realización de un evento conjunto. Por ejemplo, el resultado de lanzar un dado y una moneda se considera normalmente como eventos independientes. Traduzcamos lo anterior al lenguaje matemático. Si I (p) es la cantidad de información contenida en un evento con probabilidad p, entonces, para un evento conjunto compuesto de dos eventos independientes x con probabilidad p1 y y con probabilidad p2 obtenemos
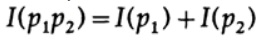
(x e y son eventos independientes)
Esta es la ecuación funcional de Cauchy, que es verdadera para todos los p1 y p2. Para resolver esta ecuación funcional, supongamos que
p1 = p2 = p,
esto da
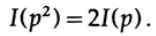
Si p1 = p2 y p2 = p, entonces
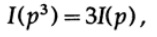
y así sucesivamente. Extendiendo este proceso, utilizando el método estándar para exponentes, para todos los números racionales m / n, se cumple lo siguiente
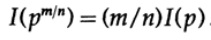
De la supuesta continuidad de la medida informativa, se deduce que la función logarítmica es la única solución continua a la ecuación funcional de Cauchy.
En teoría de la información, se acepta que la base del logaritmo es 2, por lo tanto, una elección binaria contiene exactamente 1 bit de información. Por consiguiente, la información se mide con la fórmula
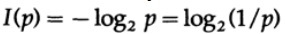
Detengámonos y analicemos qué sucedió anteriormente. En primer lugar, no hemos dado una definición del concepto de 'información'; simplemente hemos definido la fórmula para su medida cuantitativa.
En segundo lugar, esta medida depende de la incertidumbre y, aunque es suficientemente adecuada para máquinas —por ejemplo, sistemas telefónicos, radio, televisión, computadoras, etc.— no refleja la relación normal del ser humano con la información.
En tercer lugar, es una medida relativa; depende del estado actual de tu conocimiento. Si miras una secuencia de 'números aleatorios' de un generador de números aleatorios, asumes que cada número siguiente es incierto, pero si conoces la fórmula para calcular los 'números aleatorios', el siguiente número será conocido y, por ende, no contendrá información.
Así, la definición dada por Shannon para información, en muchos casos, se aplica a las máquinas, pero parece no corresponder con la comprensión humana de esta palabra. Por esta razón, "La Teoría de la Información" debería haber sido llamada "Teoría de la Comunicación". Sin embargo, ya es demasiado tarde para cambiar las definiciones (que son las que le dieron a la teoría su popularidad original, y que todavía llevan a las personas a pensar que esta teoría se ocupa de "información"), por lo que debemos aceptarlas, pero al mismo tiempo, usted debe comprender claramente cuán lejos está la definición de información dada por Shannon de su significado común. La información de Shannon se ocupa de algo completamente diferente, a saber, la incertidumbre.
Esto es lo que se debe considerar al proponer cualquier terminología. ¿Qué tan coherente es la definición propuesta, por ejemplo, la definición de información dada por Shannon, con su idea original y cuán diferente es? Hay muy pocos términos que reflejan exactamente su visión previa del concepto, pero al final, la terminología utilizada refleja el sentido del concepto, por lo que la formalización de algo mediante definiciones claras siempre introduce algo de ruido.
Consideremos un sistema cuyo alfabeto consiste en símbolos q con probabilidades pi. En este caso, la cantidad promedio de información en el sistema (su valor esperado) es igual a:
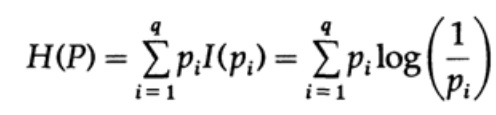
Esto se llama la entropía del sistema con una distribución de probabilidad {pi}. Utilizamos el término "entropía" porque la misma forma matemática aparece en la termodinámica y la mecánica estadística. Es por esto que el término "entropía" crea a su alrededor un aura de importancia que, en última instancia, no está justificada. ¡La misma forma matemática de escritura no implica la misma interpretación de los símbolos!
La entropía de la distribución de probabilidad juega un papel principal en la teoría de la codificación. La desigualdad de Gibbs para dos distribuciones de probabilidad diferentes pi y qi es una de las consecuencias importantes de esta teoría. Por lo tanto, debemos probar que
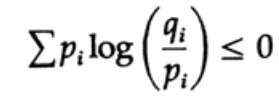
La demostración se basa en el gráfico obvio, fig. 13.I, que muestra que
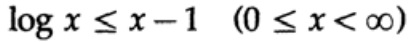
y la igualdad se alcanza solo cuando x = 1. Apliquemos la desigualdad a cada término de la suma del lado izquierdo:
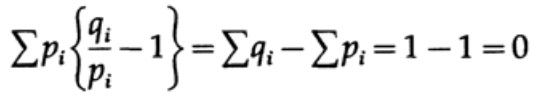
Si el alfabeto del sistema de comunicación está formado por q símbolos, al tomar la probabilidad de transmitir cada símbolo qi = 1/q y sustituyendo q, obtenemos de la desigualdad de Gibbs
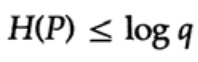
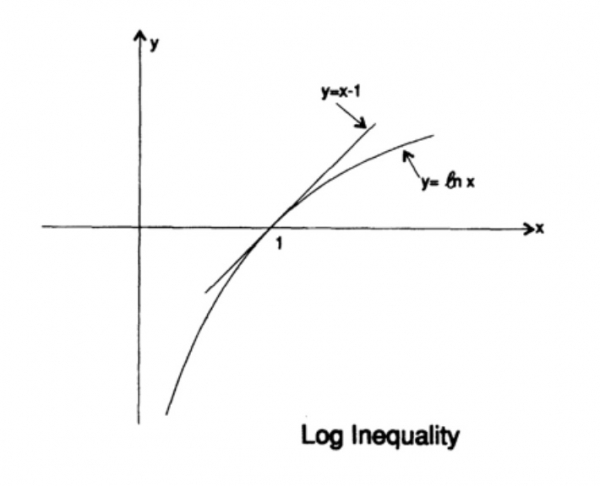
Figura 13.I
Esto indica que si la probabilidad de transmitir todos los q símbolos es igual y es 1/q, entonces la máxima entropía es igual a ln q; de lo contrario, se cumple la desigualdad.
En el caso de un código decodificable de forma única, tenemos la desigualdad de Kraft
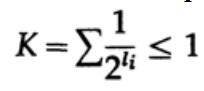
Ahora, si definimos las pseudoprobabilidades
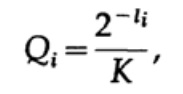
donde es finito 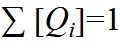 = 1, que se deduce de la desigualdad de Gibbs,
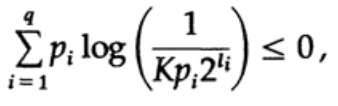
y aplicamos un poco de álgebra (recuerda que K ≤ 1, así que podemos omitir el término logarítmico, y es posible que reforcemos la desigualdad más tarde), entonces obtenemos
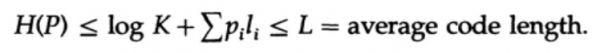
donde L es la longitud media del código.
Así, la entropía es el límite mínimo para cualquier código simbólico con una longitud media de palabra de código L. Esta es la teorema de Shannon para un canal sin ruido.
Ahora, consideremos el teorema principal sobre las limitaciones de los sistemas de comunicación, en los que la información se transmite en forma de flujo de bits independientes y hay ruido presente. Se supone que la probabilidad de una transmisión correcta de un bit P > 1/2, y la probabilidad de que el valor del bit se invierta durante la transmisión (se produzca un error) es Q = 1 - P. Para facilitar, supongamos que los errores son independientes y que la probabilidad de error es la misma para cada bit enviado, es decir, hay 'ruido blanco' en el canal de comunicación.
Supongamos que tenemos un largo flujo de n bits codificados en un solo mensaje, una expansión n-dimensional de un código de un bit. Definiremos el valor de n más adelante. Consideremos el mensaje constituido por n-bits como un punto en un espacio n-dimensional. Dado que tenemos un espacio n-dimensional y, para simplificar, asumiremos que cada mensaje tiene la misma probabilidad de ocurrir, existen M mensajes posibles (M también se definirá más adelante), por lo tanto, la probabilidad de cualquier mensaje enviado es

(remitente)
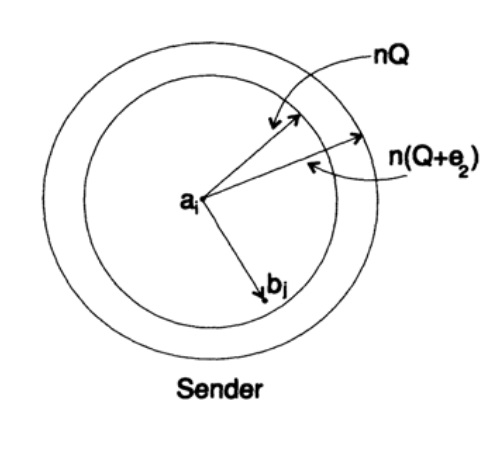
Gráfico 13.II
A continuación, consideraremos la idea del ancho de banda de un canal. Sin entrar en detalles, el ancho de banda de un canal se define como la máxima cantidad de información que puede ser transmitida de manera confiable a través de un canal de comunicación, teniendo en cuenta el uso de codificación óptima. No hay argumentos que sugieran que se puede transmitir más información a través de un canal de comunicación que su capacidad. Esto se puede probar para un canal binario simétrico (que es el que utilizamos en este caso). La capacidad del canal, en el caso de transmisión bit a bit, se establece como
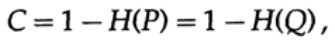
donde, como antes, P es la probabilidad de que no haya errores en cualquier bit enviado. Al enviar n bits independientes, la capacidad del canal se determina como
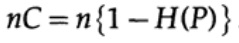
Si estamos cerca del ancho de banda del canal, debemos enviar casi esa cantidad de información para cada uno de los símbolos ai, i = 1, …, M. Teniendo en cuenta que la probabilidad de aparición de cada símbolo ai es igual a 1 / M, obtendremos
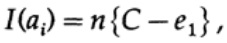
cuando enviamos uno de los M mensajes igualmente probables ai, tenemos
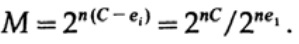
Al enviar n bits, esperamos la aparición de nQ errores. En la práctica, para un mensaje compuesto por n bits, tendremos aproximadamente nQ errores en el mensaje recibido. Para valores grandes de n, la variación relativa (variación = ancho de distribución,)
de la distribución del número de errores será cada vez más estrecha a medida que n crezca.
Así, desde el lado del transmisor, tomo el mensaje ai para enviar y dibujo una esfera alrededor de él con un radio
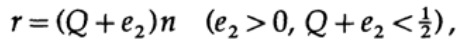
que es un poco mayor que la cantidad igual a e2, que el número esperado de errores Q, (figura 13.II). Si n es suficientemente grande, hay una probabilidad tan pequeña como se quiera de que un punto de mensaje bj en el receptor esté fuera de esta esfera. Ilustremos la situación, como la veo desde el punto de vista del transmisor: tenemos cualquier radio desde el mensaje transmitido ai hasta el mensaje recibido bj con una probabilidad de error igual (o casi igual) a la distribución normal, alcanzando un máximo en nQ. Para cualquier e2 dado, existe un n lo suficientemente grande, de modo que la probabilidad de que el punto recibido bj, que esté fuera de mi esfera, sea tan pequeña como se desee.
Ahora consideremos esta misma situación desde su perspectiva (fig. 13.III). En el lado del receptor hay una esfera S(r) del mismo radio r alrededor del punto recibido bj en un espacio n-dimensional, tal que si el mensaje recibido bj está dentro de mi esfera, entonces el mensaje enviado por mí ai está dentro de su esfera.
¿Cómo puede surgir un error? Un error puede ocurrir en los casos descritos en la tabla a continuación:
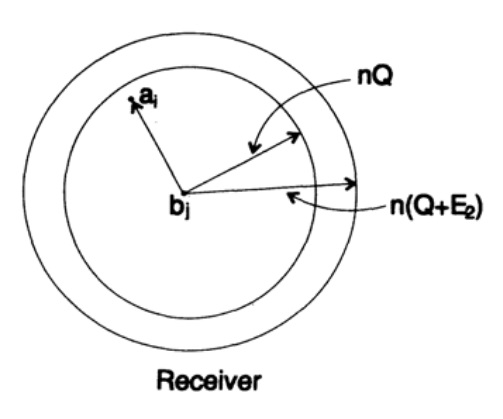
Figura 13.III
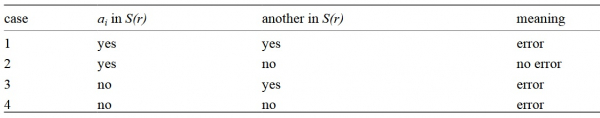
Aquí vemos que, si hay al menos otro punto en la esfera construida alrededor del punto recibido que corresponde a un posible mensaje enviado no codificado, entonces ha ocurrido un error en la transmisión, ya que no se puede determinar cuál de estos mensajes fue transmitido. El mensaje enviado no contiene errores solo si el punto correspondiente a él se encuentra en la esfera y no hay otros puntos posibles en este código que estén en la misma esfera.
Tenemos una ecuación matemática para la probabilidad de error Pe, si se envió un mensaje ai
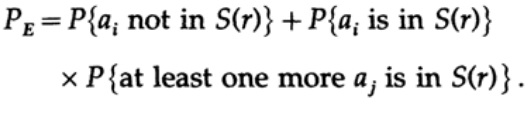
Podemos eliminar el primer multiplicador en el segundo término, asumiéndolo como 1. Así obtenemos una desigualdad
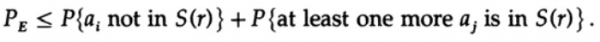
Es obvio que
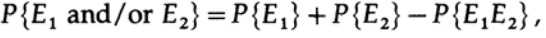
por lo tanto
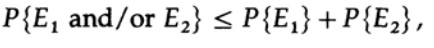
aplicamos nuevamente al último término a la derecha
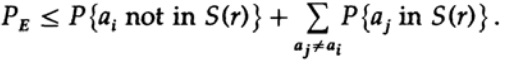
Asumiendo que n es lo suficientemente grande, el primer término puede ser considerado tan pequeño como queramos, digamos, menor que algún número d. Por lo tanto, tenemos
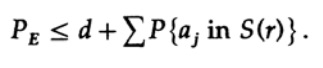
Ahora consideremos cómo se puede construir un código de sustitución simple para codificar M mensajes que consisten en n bits. Sin tener una idea de cómo exactamente construir el código (los códigos de corrección de errores aún no habían sido inventados), Shannon eligió la codificación aleatoria. Lanzamos una moneda para cada uno de los n bits en el mensaje y repetimos el proceso para M mensajes. En total, es necesario hacer nM lanzamientos de moneda, por lo que son posibles

diccionarios de código que tienen la misma probabilidad ½nM. Por supuesto, el proceso aleatorio de creación de un diccionario de códigos significa que hay una probabilidad de aparición de duplicados, así como puntos de código que estarán cerca unos de otros y, por lo tanto, serán una fuente de errores probables. Es necesario demostrar que si esto no ocurre con una probabilidad mayor que un pequeño nivel de error elegido, entonces n dado es lo suficientemente grande.
El punto decisivo es que Shannon promedió todos los libros de códigos posibles para encontrar el error medio. Utilizaremos el símbolo Av [.] para representar el valor medio sobre un conjunto de todos los posibles diccionarios de códigos aleatorios. Promediar por la constante d, por supuesto, da una constante, ya que para el promedio, cada término coincide con cualquier otro término en la suma.
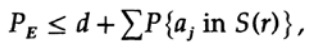
que puede ser aumentado (M–1 pasa a M)
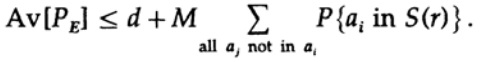
Para un mensaje específico, al promediar todos los libros de códigos, la codificación recorre todos los posibles valores, por lo que la probabilidad media de que un punto esté dentro de la esfera es la relación entre el volumen de la esfera y el volumen total del espacio. El volumen de la esfera en este caso
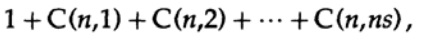
donde s=Q+e2 <1/2 y ns debe ser un número entero.
El último término a la derecha es el mayor en esta suma. Primero evaluaremos su valor usando la fórmula de Stirling para factoriales. Luego observaremos el coeficiente que disminuye para el término anterior, notando que este coeficiente aumenta al moverse hacia la izquierda, por lo que podemos: (1) limitar el valor de la suma con la suma de una progresión geométrica con este coeficiente inicial, (2) extender la progresión geométrica con ns términos a un número infinito de términos, (3) calcular la suma de la progresión geométrica infinita (álgebra estándar, nada sustancial) y finalmente obtener el límite (para un n suficientemente grande):
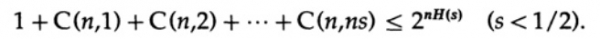
Observe cómo la entropía H(s) apareció en la identidad binomial. Nota que la expansión en serie de Taylor H(s)=H(Q+e2) da una estimación basada solo en la primera derivada y despreciando todas las demás. Ahora reunamos la expresión final:
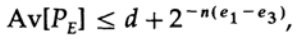
donde
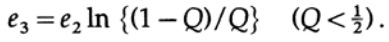
Todo lo que necesitamos hacer es elegir e2 de modo que e3 < e1, y entonces el último término será tan pequeño como deseemos, para un n suficientemente grande. Por lo tanto, el error medio PE se puede hacer tan pequeño como queramos con una capacidad de canal lo suficientemente cercana a C.
Si el valor medio de todos los códigos tiene un error suficientemente pequeño, entonces al menos un código debe ser apropiado, por lo tanto, existe al menos un sistema de codificación adecuado. Este es un resultado importante obtenido por Shannon: la "teorema de Shannon para un canal con interferencias", aunque cabe señalar que él lo demostró para un caso mucho más general que el simple canal binario simétrico que he utilizado. Para el caso general, los cálculos matemáticos son mucho más complejos, pero las ideas no son tan diferentes, por lo que a menudo el caso particular puede revelar el verdadero sentido del teorema.
Critiquemos el resultado. Hemos repetido varias veces: "Con n suficientemente grande". Pero, ¿qué tan grande debe ser n? Muy, muy grande, si realmente quieres estar simultáneamente cerca de la capacidad del canal y estar seguro de la correcta transmisión de datos. Tan grande que, de hecho, te verás obligado a esperar mucho tiempo para acumular un mensaje de tal cantidad de bits que luego puedas codificar. Al mismo tiempo, el tamaño del diccionario de código aleatorio será simplemente enorme (pues tal diccionario no puede ser representado en una forma más corta que una lista completa de todos los bits de Mn, dado que n y M son muy grandes).
Los códigos de corrección de errores evitan la espera de un mensaje muy largo, con su posterior codificación y decodificación a través de libros de códigos muy grandes, porque evitan los libros de códigos como tales y utilizan en su lugar cálculos ordinarios. En teoría simple, tales códigos tienden a perder la capacidad de acercarse a la capacidad del canal y al mismo tiempo mantener una frecuencia de errores suficientemente baja, pero cuando el código corrige un gran número de errores, muestran buenos resultados. En otras palabras, si reservas cierta capacidad del canal para la corrección de errores, debes usar la capacidad de corrección de errores la mayor parte del tiempo, es decir, en cada mensaje enviado debe corregirse un gran número de errores, de lo contrario, perderás esa capacidad en vano.
Sin embargo, el teorema demostrado anteriormente no es irrelevante. Muestra que los sistemas de transmisión eficaces deben emplear esquemas de codificación cuidadosamente diseñados para cadenas de bits muy largas. Un ejemplo son los satélites que han viajado más allá de los planetas exteriores; a medida que se alejan de la Tierra y del Sol, se ven obligados a corregir un número cada vez mayor de errores en los bloques de datos: algunos satélites utilizan paneles solares que proporcionan alrededor de 5 W, mientras que otros emplean fuentes de energía atómicas que ofrecen aproximadamente la misma potencia. La baja potencia de la fuente de energía, el tamaño reducido de las antenas transmisoras y los limitados tamaños de las antenas receptoras en la Tierra, así como la enorme distancia que debe recorrer la señal, requieren el uso de códigos con un alto nivel de corrección de errores para construir un sistema de comunicación eficiente.
Regresamos al espacio n-dimensional que utilizamos en la demostración anterior. Al discutirlo, mostramos que casi todo el volumen de la esfera se concentra cerca de la superficie exterior; así, casi con certeza, la señal enviada estará situada en la superficie de la esfera construida alrededor de la señal recibida, incluso con un radio relativamente pequeño de dicha esfera. Por lo tanto, no es sorprendente que la señal recibida, después de corregir una cantidad arbitrariamente grande de errores, nQ, resulte estar tan cerca como se desee de la señal sin errores. La capacidad del canal de comunicación que consideramos anteriormente es clave para entender este fenómeno. Tenga en cuenta que tales esferas, construidas para códigos de Hamming con corrección de errores, no se superponen entre sí. Un gran número de dimensiones prácticamente ortogonales en el espacio n-dimensional muestra por qué podemos acomodar M esferas en el espacio con poco solapamiento. Si se permite un pequeño solapamiento, que puede dar lugar solo a un pequeño número de errores en la decodificación, se puede lograr una disposición densa de esferas en el espacio. Hamming garantizó un cierto nivel de corrección de errores, Shannon una baja probabilidad de error, mientras que los códigos de Hamming no pueden mantener la capacidad real del canal de comunicación tan cerca como la capacidad del canal.
La teoría de la información no indica cómo diseñar un sistema eficiente, pero señala la dirección hacia sistemas de comunicación eficaces. Es una herramienta valiosa para la construcción de sistemas de comunicación entre máquinas, pero, como se menciona anteriormente, no tiene una relación particular con cómo las personas intercambian información entre sí. El grado en que la herencia biológica es similar a los sistemas de comunicación técnicos es simplemente desconocido, por lo que en este momento no está claro cuán aplicable es la teoría de la información a los genes. No nos queda otra opción que simplemente intentarlo, y si el éxito nos muestra la naturaleza maquinista de este fenómeno, el fracaso señalará otros aspectos significativos de la naturaleza de la información.
Vamos a distraernos un poco. Hemos visto que todas las definiciones iniciales, en mayor o menor medida, deben expresar la esencia de nuestras creencias originales, pero tienen un cierto grado de distorsión, y por tanto, resultan inaplicables. Tradicionalmente se considera que, en última instancia, la definición que utilizamos define realmente la esencia; pero esto solo nos indica cómo procesar las cosas y de ninguna manera nos aporta sentido. El enfoque postulacional, tan alabado en círculos matemáticos, deja mucho que desear en la práctica.
Ahora vamos a considerar un ejemplo de pruebas de IQ, donde la definición es tan cíclica como desees, y como resultado te confunde. Se crea una prueba que se supone debe medir la inteligencia. Después se revisa para que sea lo más coherente posible y luego se publica y se calibra de tal manera que la 'inteligencia' medida resulte normalmente distribuida (por supuesto, según la curva de calibración). Todas las definiciones deben ser revisadas, no solo cuando se proponen por primera vez, sino también mucho más tarde, cuando se utilizan en las conclusiones hechas. ¿Hasta qué punto los límites de las definiciones son adecuados para la tarea que se está resolviendo? ¿Con qué frecuencia las definiciones dadas en una condición comienzan a aplicarse en condiciones suficientemente diferentes? ¡Esto ocurre con bastante frecuencia! En las ciencias humanas, con las que inevitablemente te encontrarás en tu vida, esto sucede más a menudo.
Así, uno de los objetivos de esta presentación sobre la teoría de la información, además de demostrar su utilidad, fue advertir sobre este peligro, o mostrar cómo utilizarla para obtener el resultado deseado. Se ha observado desde hace tiempo que las definiciones iniciales condicionan mucho más lo que encuentras al final de lo que parece. Las definiciones iniciales requieren de tu gran atención no solo en cualquier nueva situación, sino también en áreas en las que ya trabajas desde hace tiempo. Esto te permitirá entender en qué medida los resultados obtenidos son una tautología, y no algo útil.
La conocida historia de Eddington habla sobre personas que pescaban en el mar con una red. Al estudiar el tamaño de los peces que atraparon, ¡determinaron el tamaño mínimo de los peces que habitan en el mar! Su conclusión estuvo condicionada por la herramienta utilizada, y no por la realidad.
Continuará...
Quien quiera ayudar con la traducción, maquetación y publicación de un libro, escríbame por privado o al correo magisterludi2016@yandex.ru
Por cierto, también hemos lanzado la traducción de otro gran libro — )
Estamos especialmente buscando a quienes ayuden a traducir . (traducimos en segmentos de 10 minutos, ya hemos tomado los primeros 20)
Contenido del libro y capítulos traducidos
- Introducción a El Arte de Hacer Ciencia e Ingeniería: Aprender a Aprender (28 de marzo de 1995)
- «Fundamentos de la Revolución Digital (Discreta)» (30 de marzo de 1995)
- «Historia de las Computadoras — Hardware» (31 de marzo de 1995)
- «Historia de las Computadoras — Software» (4 de abril de 1995)
- «Historia de las Computadoras — Aplicaciones» (6 de abril de 1995)
- «Inteligencia Artificial — Parte I» (7 de abril de 1995)
- «Inteligencia Artificial — Parte II» (11 de abril de 1995)
- «Inteligencia Artificial III» (13 de abril de 1995)
- «Espacio n-Dimensional» (14 de abril de 1995)
- «Teoría de la Codificación — La Representación de Información, Parte I» (18 de abril de 1995)
- «Teoría de la Codificación — La Representación de Información, Parte II» (20 de abril de 1995)
- «Códigos de Corrección de Errores» (21 de abril de 1995)
- «Teoría de la Información» (25 de abril de 1995)
- «Filtros Digitales, Parte I» (27 de abril de 1995)
- «Filtros Digitales, Parte II» (28 de abril de 1995)
- «Filtros Digitales, Parte III» (2 de mayo de 1995)
- «Filtros Digitales, Parte IV» (4 de mayo de 1995)
- «Simulación, Parte I» (5 de mayo de 1995)
- «Simulación, Parte II» (9 de mayo de 1995)
- «Simulación, Parte III» (11 de mayo de 1995)
- «Fibra Óptica» (12 de mayo de 1995)
- «Instrucción Asistida por Computadora» (16 de mayo de 1995)
- «Matemáticas» (18 de mayo de 1995)
- «Mecánica Cuántica» (19 de mayo de 1995)
- «Creatividad» (23 de mayo de 1995). Traducción:
- «Expertos» (25 de mayo de 1995)
- «Datos No Fiables» (26 de mayo de 1995)
- «Ingeniería de Sistemas» (30 de mayo de 1995)
- «Obtienes Lo Que Mides» (1 de junio de 1995)
- (2 de junio de 1995) traducimos en partes de 10 minutos
- Hamming, «Tú y Tu Investigación» (6 de junio de 1995).
Quien quiera ayudar con la traducción, maquetación y publicación de un libro, escríbame por privado o al correo magisterludi2016@yandex.ru
Fuente: habr.com
