

Hoy en día, el servicio "Bitrix24" no cuenta con cientos de gigabits de tráfico ni con una gran cantidad de servidores (aunque, por supuesto, hay varios). Sin embargo, para muchos clientes, es una herramienta fundamental dentro de la empresa, una verdadera aplicación crítica para el negocio. Por eso, es imperativo que no haya caídas. ¿Y qué pasaría si, a pesar de todo, ocurriese una caída, pero el servicio se recuperase tan rápidamente que nadie se diera cuenta? ¿Y cómo se logra implementar un failover sin perder calidad en el servicio y sin afectar la cantidad de clientes? Alexander Demidov, director del área de servicios en la nube de "Bitrix24", compartió con nuestro blog cómo ha evolucionado el sistema de reservas en los 7 años de existencia del producto.
"Lanzamos 'Bitrix24' en forma de SaaS hace 7 años. La principal dificultad, probablemente, fue la siguiente: antes de nuestro lanzamiento al público como SaaS, este producto existía simplemente en formato de solución de caja. Los clientes lo compraban a nosotros, lo instalaban en sus servidores, creaban un portal corporativo: una solución general para la comunicación entre empleados, almacenamiento de archivos, gestión de tareas, CRM, todo eso. Y para 2012 decidimos que queríamos lanzarlo como SaaS, administrándolo nosotros mismos, garantizando la resiliencia y la fiabilidad. La experiencia la adquirimos en el camino, porque hasta ese momento simplemente no la teníamos: éramos solo fabricantes de software, no proveedores de servicios.
Al lanzar el servicio, entendíamos que lo más importante era garantizar la resiliencia, la fiabilidad y la disponibilidad constante del servicio, porque si tienes un sitio web normal, una tienda, por ejemplo, y se cae durante una hora, solo te perjudicas tú, pierdes pedidos, pierdes clientes, pero para tu cliente eso no es muy crítico. Claro, se molesta un poco, pero se va y compra en otro sitio. Pero si se trata de una aplicación en la que se basa todo el trabajo dentro de la empresa, las comunicaciones, las decisiones, lo más clave es ganar la confianza de los usuarios, es decir, no decepcionarlos y no caer. Porque todo el trabajo puede detenerse si algo interno no funciona.
Bitrix24 como SaaS
El primer prototipo lo construimos un año antes del lanzamiento público, en 2011. Lo armamos en aproximadamente una semana, lo revisamos y lo manipulamos; incluso estaba funcionando. Es decir, se podía acceder a un formulario, introducir el nombre del portal y se generaba un nuevo portal con una base de usuarios. Lo observamos, evaluamos el producto en general, lo desechamos y continuamos refinándolo durante todo un año. Porque teníamos una gran tarea: no queríamos tener dos bases de código diferentes, no queríamos mantener un producto en caja por separado y soluciones en la nube, queríamos hacer todo esto dentro de un solo código.
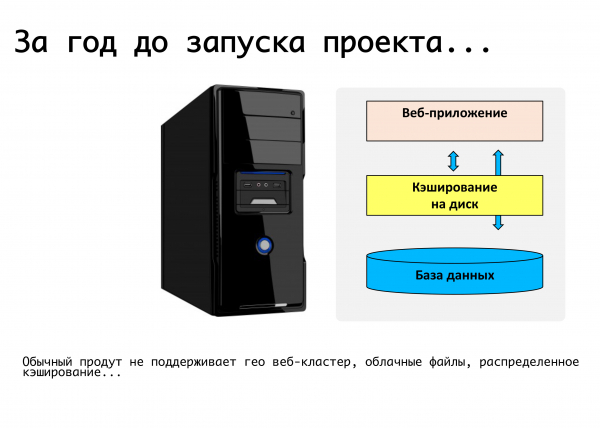
Una aplicación web típica en ese momento era un solo servidor en el que corría algún código PHP, con una base de datos MySQL, archivos siendo cargados, documentos e imágenes colocados en una carpeta de subida, y eso era todo. Lamentablemente, no es posible lanzar un servicio web críticamente resistente de esta manera. No se soporta caché distribuido, ni replicación de bases de datos.
Formulamos los requerimientos: esta capacidad de ser desplegados en diferentes ubicaciones, soportar replicación, idealmente ubicarse en diferentes centros de datos distribuidos geográficamente. Separar la lógica del producto y el almacenamiento de datos. Ser capaz de escalar dinámicamente según la carga, y en general, sacar la gestión de archivos estáticos. A partir de estas consideraciones, se formaron, en realidad, los requerimientos del producto que estuvimos refinando durante un año. Durante este tiempo, en la plataforma que resultó ser única —para soluciones en caja, para nuestro propio servicio— implementamos el soporte para las cosas que necesitábamos. Soporte de replicación MySQL a nivel de producto: es decir, el desarrollador que escribe el código no se preocupa de cómo se distribuirán sus consultas, usa nuestra API, y nosotros sabemos cómo distribuir correctamente las consultas de escritura y lectura entre maestros y esclavos.
Implementamos soporte a nivel de producto para varios almacenamiento de objetos en la nube: Google Storage, Amazon S3, además del soporte para OpenStack Swift. Por lo tanto, esto fue conveniente tanto para nosotros como para el servicio, y para los desarrolladores que trabajan con la solución en caja: si utilizan simplemente nuestra API para trabajar, no se preocupan de dónde se guardará el archivo al final, si localmente en el sistema de archivos o si irá a un almacenamiento de objetos.
Al final, decidimos que haríamos la reserva a nivel de todo el centro de datos. En 2012, comenzamos completamente en Amazon AWS porque ya teníamos experiencia trabajando con esta plataforma: nuestro propio sitio estaba alojado allí. Nos atraía que en cada región de Amazon hay varias zonas de disponibilidad - en su terminología, varios centros de datos que son más o menos independientes entre sí y nos permiten hacer reservas a nivel de todo un centro de datos: si uno falla, las bases se replican master-master, los servidores de aplicaciones web están reservados y la estática está almacenada en el almacenamiento de objetos S3. La carga se equilibra - en ese momento con el ELB de Amazon, pero poco después llegamos a nuestros propios equilibradores de carga porque necesitábamos una lógica más compleja.
Lo que queríamos, lo obtuvimos...
Todas las cosas básicas que queríamos garantizar - la redundancia de los propios servidores, las aplicaciones web y las bases de datos - funcionaron bien. El escenario más sencillo: si alguna de nuestras aplicaciones web falla, es simple: se apagan del equilibrio de carga.
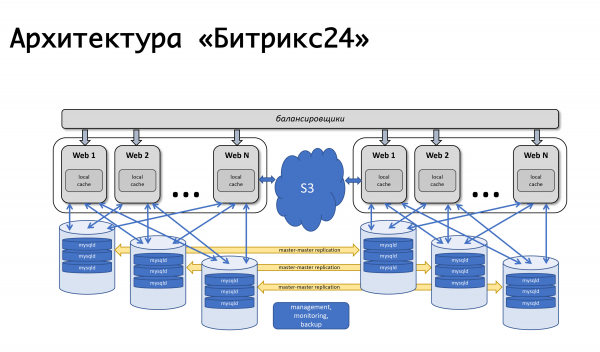
Las máquinas que fallaron son marcadas como unhealthy por el equilibrador (en ese momento era el ELB de Amazon), que desactivaba la distribución de carga sobre ellas. Funcionaba el autoescalado de Amazon: cuando la carga aumentaba, se añadían nuevas máquinas al grupo de autoescalado y la carga se distribuía entre las nuevas máquinas - todo iba bien. Con nuestros equilibradores de carga, la lógica es más o menos la misma: si algo le sucede a un servidor de aplicaciones, retiramos las solicitudes de él, desechamos esas máquinas, iniciamos nuevas y seguimos trabajando. El esquema ha cambiado un poco a lo largo de los años, pero sigue funcionando: es simple, claro y no hay complicaciones.
Trabajamos en todo el mundo, los picos de carga de los clientes son absolutamente diferentes y, en realidad, debemos tener la capacidad de realizar ciertos trabajos de servicio con cualquier componente de nuestro sistema en cualquier momento, sin que los clientes se percaten. Por lo tanto, tenemos la posibilidad de desconectar la base de datos, redistribuyendo la carga en un segundo centro de datos.
¿Cómo funciona todo esto? — Redirigimos el tráfico a un centro de datos operativo; si hay una falla en el centro de datos, se hace completamente, si son trabajos planificados en una base, desviamos parte del tráfico que atiende a esos clientes a un segundo centro de datos, y se suspende la replicación. Si necesitamos nuevas máquinas para aplicaciones web debido al aumento de carga en el segundo centro de datos, se inician automáticamente. Terminamos los trabajos, se restablece la replicación y devolvemos toda la carga original. Si necesitamos hacer un trabajo espejo en el segundo DC, como instalar actualizaciones del sistema o cambiar configuraciones en la segunda base de datos, repetimos todo lo mismo, simplemente en la otra dirección. Y si hay una falla, hacemos todo de manera simple: en el sistema de monitoreo utilizamos el mecanismo de event-handlers. Si se activan varias comprobaciones y el estado cambia a crítico, se activa este handler, un procesador que puede ejecutar cierta lógica. Para cada base, tenemos especificado qué servidor es su failover y a dónde redirigir el tráfico en caso de que quede inoperante. Históricamente, usamos nagios o alguna de sus bifurcaciones. En principio, casi cualquier sistema de monitoreo tiene mecanismos similares; algo más complejo aún no lo usamos, pero quizás lo hagamos en el futuro. Actualmente, el monitoreo se activa ante la inaccesibilidad y tiene la capacidad de redirigir algo.
¿Hemos reservado todo?
Tenemos muchos clientes de EE. UU., muchos clientes de Europa, y muchos clientes más cerca de Oriente: Japón, Singapur, y así sucesivamente. Naturalmente, una gran parte de nuestros clientes están en Rusia. Esto significa que nuestra operación no se limita a una sola región. Los usuarios quieren un tiempo de respuesta rápido, hay requisitos para cumplir con diversas leyes locales, y dentro de cada región reservamos dos centros de datos, además de algunos servicios adicionales que, una vez más, es conveniente ubicar dentro de una misma región para los clientes que operan en ella. Los manejadores REST y los servidores de autorización son menos críticos para la operación del cliente en general; se pueden cambiar con una pequeña demora aceptable, pero no queremos reinventar la rueda en cuanto a cómo monitorearlos y qué hacer con ellos. Por lo tanto, tratamos de aprovechar al máximo las soluciones ya existentes en lugar de desarrollar nuestra propia competencia en productos adicionales. Y en algunos casos, simplemente utilizamos el cambio a nivel de DNS, determinando la disponibilidad del servicio por medio del mismo DNS. En Amazon existe el servicio Route 53, pero no es solo un DNS donde se pueden agregar registros y ya está: es mucho más flexible y conveniente. A través de él, se pueden construir servicios geo-distribuidos con geolocalizaciones, cuando a través de él se determina de dónde vino el cliente y se le proporcionan ciertos registros; se pueden construir arquitecturas de failover. Los mismos health checks se configuran dentro de Route 53, donde se especifica el endpoint que se monitorea, las métricas y los protocolos según los cuales se determina la "vitalidad" del servicio: TCP, HTTP, HTTPS; se establece la frecuencia de las verificaciones que determinan si el servicio está activo o no. Y en el DNS mismo se especifica cuál será el primario, cuál será el secundario, y adónde cambiar si se activa el health check dentro de Route 53. Todo esto se puede hacer con otras herramientas, pero lo conveniente es que una vez configurado, luego no tenemos que pensar en cómo se realizan las verificaciones y cómo se lleva a cabo el cambio: todo funciona automáticamente.
La primera "pero": ¿Y cómo y con qué reservar Route 53? No vaya a ser que ocurra algo. Afortunadamente, nunca hemos tenido ese problema, pero de nuevo, pronto contaré por qué pensamos que realmente hay que hacer reservas. Aquí lo hacemos de manera anticipada. Varias veces al día hacemos una exportación completa de todas las zonas que tenemos en Route 53. La API de Amazon permite exportarlas fácilmente en JSON, y tenemos varios servidores de respaldo donde convertimos y exportamos esto en forma de configuraciones y, dicho de manera sencilla, tenemos una configuración de respaldo. En caso de ser necesario, podemos desplegarla manualmente y no perderemos los datos de configuración DNS.
El segundo 'pero': ¿qué en esta imagen aún no está reservado? ¡El balanceador! La distribución de clientes por regiones se realiza de manera muy simple. Tenemos los dominios bitrix24.ru, bitrix24.com, .de, ahora hay unos 13 diferentes que funcionan en diversas zonas. Hemos llegado a la siguiente conclusión: en cada región hay sus propios balanceadores. Es más fácil distribuir según las regiones, dependiendo de dónde hay más carga en la red. Si hay un fallo en algún balanceador, simplemente se saca de operación y se elimina del DNS. Si hay algún problema en el grupo de balanceadores, se reservan en otras ubicaciones y el cambio entre ellos se realiza con Route 53, porque gracias a un TTL corto, el cambio se lleva a cabo en un máximo de 2, 3, 5 minutos.
El tercer 'pero': ¿qué más no está reservado? S3, correcto. Al almacenar archivos que tenemos de los usuarios en S3, creíamos sinceramente que era a prueba de balas y que no había necesidad de hacer reservas. Pero la historia muestra que las cosas suceden de otra manera. En general, Amazon describe S3 como un servicio fundamental, porque Amazon utiliza S3 para almacenar imágenes de máquinas, configuraciones, imágenes AMI, instantáneas... Y si S3 falla, como sucedió una vez en estos 7 años que hemos estado usando bitrix24, arrastra con ello un montón de cosas: la indisponibilidad de la creación de máquinas virtuales, fallos en el funcionamiento de la API, etc.
Y S3 puede fallar, como sucedió una vez. Por eso llegamos al siguiente esquema: hace unos años no había grandes almacenes públicos de objetos en Rusia, y consideramos la opción de hacer algo propio... Afortunadamente, no comenzamos a hacerlo, porque nos habríamos enredado en una experticia que no poseemos, y seguramente habríamos cometido errores. Ahora hay almacenes compatibles con S3 de Mail.ru, Yandex y otros proveedores. Al final, llegamos a la conclusión de que queríamos, en primer lugar, reservación, y en segundo lugar, la posibilidad de trabajar con copias locales. Para la región rusa en particular, utilizamos el servicio Mail.ru Hotbox, que es compatible con S3 a través de API. No necesitamos hacer grandes modificaciones en el código dentro de la aplicación, y hemos creado el siguiente mecanismo: en S3 hay disparadores que se activan al crear/eliminar objetos, y Amazon tiene un servicio llamado Lambda, que es un código que se ejecuta sin servidor y que se ejecutará precisamente cuando se activen esos disparadores.
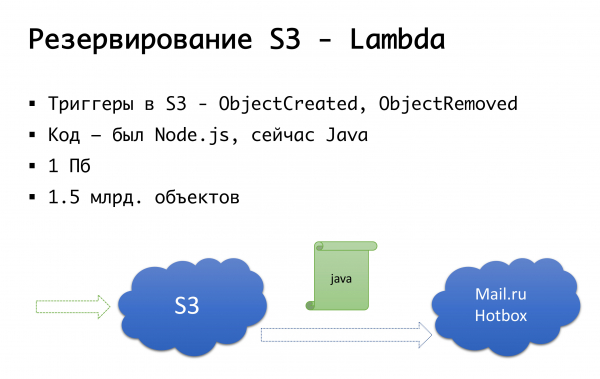
Hicimos algo muy simple: si se activa un disparador, ejecutamos un código que copia el objeto en el almacenamiento de Mail.ru. Para iniciar completamente el trabajo con copias locales de datos, también necesitamos una sincronización inversa, para que los clientes que están en el segmento ruso puedan trabajar con un almacenamiento que les quede más cerca. Mail está por completar los disparadores en su almacenamiento; se podrá realizar la sincronización inversa a nivel de infraestructura, mientras tanto, lo hacemos a nivel de nuestro propio código. Si vemos que un cliente ha subido un archivo, en nuestro código colocamos un evento en la cola, lo procesamos y hacemos una replicación inversa. Lo malo es que si hay algún trabajo con nuestros objetos fuera de nuestro producto, es decir, con medios externos, no lo tendremos en cuenta. Por eso, esperamos hasta que los disparadores estén disponibles a nivel de almacenamiento, para que, independientemente de dónde ejecutemos el código, el objeto que hemos recibido se copie hacia el otro lado.
A nivel de código, configuramos dos almacenamiento para cada cliente: uno es el primario y el otro es de respaldo. Si todo va bien, trabajamos con el almacenamiento más cercano a nosotros: es decir, nuestros clientes que están en Amazon utilizan S3, mientras que aquellos que operan en Rusia utilizan Hotbox. Si se activa un interruptor, debemos conectarnos a un failover, y cambiamos a los clientes a otro almacenamiento. Este interruptor puede activarse de manera independiente por regiones y podemos alternar entre ellos. En la práctica, aún no lo hemos utilizado, pero hemos previsto este mecanismo y creemos que en algún momento necesitaremos y será útil este cambio. Ya ha sucedido una vez.
Oh, parece que Amazon se ha escapado…
Este abril marca el aniversario del inicio de las bloqueos de Telegram en Rusia. El proveedor más afectado por esto fue Amazon. Y, lamentablemente, las empresas rusas que operaban a nivel mundial fueron las más perjudicadas.
Si la empresa es global y Rusia representa solo un pequeño segmento, del 3 al 5%, de alguna manera, se puede sacrificar.
Si se trata de una empresa puramente rusa, estoy seguro de que debe establecerse localmente; simplemente será más conveniente y cómodo para los usuarios, y habrá menos riesgos.
Y si se trata de una empresa que opera a nivel global, y tiene aproximadamente la misma cantidad de clientes en Rusia que en otras partes del mundo? La conectividad de los segmentos es importante, y de alguna manera deben trabajar juntos.
También, a finales de marzo de 2018, Roskomnadzor envió una carta a los mayores operadores, indicando que planeaban bloquear varios millones de IP de Amazon para bloquear... el mensajero Zello. Gracias a esos proveedores, la carta fue filtrada con éxito a todos, y surgió la comprensión de que la conectividad con Amazon podría colapsar. Era viernes, y llegamos en pánico a nuestros colegas de servers.ru, diciendo: 'Amigos, necesitamos varios servidores que no estén en Rusia, no en Amazon, sino, por ejemplo, en algún lugar de Ámsterdam', para tener la oportunidad de establecer allí, de alguna manera, nuestros propios. vpn y proxy para algunos endpoints, sobre los que no podemos influir de ninguna manera, como los endpoints del mismo s3 — no se puede intentar levantar un nuevo servicio y obtener otra ip, aún necesitamos comunicarnos con ellos. En unos días configuramos estos servidores, los levantamos y, en general, para el momento en que comenzaron los bloqueos, estábamos preparados. Curiosamente, el RKN, al ver el alboroto y el pánico levantado, dijo: «No, ahora no vamos a bloquear nada». (Pero esto fue justo hasta el momento en que empezaron a bloquear Telegram.) Configurando las capacidades de evasión y comprendiendo que no se impuso el bloqueo, sin embargo, no desmantelamos todo esto. Así, por si acaso.
Y así, en 2019, vivimos bajo condiciones de bloqueos. Anoche estaba mirando: cerca de un millón de ip siguen siendo bloqueadas. Sin embargo, Amazon fue desbloqueado casi en su totalidad, en su punto más alto se llegó a 20 millones de direcciones... En resumen, la realidad es que la conectividad, buena conectividad — puede no existir. De repente. Puede no estar por razones técnicas — incendios, excavadoras, y todo eso. O, como hemos visto, no del todo técnicas. Por lo tanto, alguien grande y poderoso, con sus propios AS, probablemente puede manejar esto de otras maneras, — conexiones directas y otras cosas ya a nivel l2. Pero en una opción simple, como nosotros o aquellos más pequeños, se puede tener por si acaso una reserva a nivel de servidores, levantados en otros lugares, configurados previamente con vpn, proxy, con la posibilidad de cambiar rápidamente la configuración a esos segmentos que son críticos para su conectividad. Esto nos ha sido útil varias veces, cuando comenzaron los bloqueos de Amazon, a través de ellos dirigimos en el peor de los casos el tráfico de S3, pero poco a poco todo se resolvió.
¿Y cómo se reserva… a un proveedor entero?
Actualmente no tenemos un plan en caso de un fallo total de Amazon. Sin embargo, tenemos un plan similar para Rusia. Nos alojamos en Rusia con un proveedor que elegimos para tener varias ubicaciones. Hace un año, nos enfrentamos a un problema: a pesar de que son dos centros de datos, ya a nivel de configuración de red del proveedor pueden surgir problemas que afecten a ambos centros de datos. Y podemos experimentar falta de disponibilidad en ambas ubicaciones. Por supuesto, eso sucedió. Al final, revisamos la arquitectura interna. No cambió mucho, pero ahora tenemos dos ubicaciones en Rusia, que no están bajo un mismo proveedor, sino en dos diferentes. Si uno falla, podemos cambiar al otro.
Hipotéticamente, para Amazon estamos considerando la posibilidad de hacer una reserva a nivel de otro proveedor; quizás Google, quizás alguien más... Pero hasta ahora hemos observado en la práctica que si Amazon tiene fallos a nivel de una zona de disponibilidad, los fallos a nivel de toda una región son bastante raros. Así que teóricamente tenemos la idea de que podríamos hacer una reserva de "Amazon - no Amazon", pero en la práctica eso aún no se ha realizado.
Unas palabras sobre la automatización
¿Siempre se necesita automatización? Aquí es apropiado recordar el efecto Dunning-Kruger. En el eje 'X', nuestras conocimientos y experiencia que vamos adquiriendo, y en el eje 'Y' — la confianza en nuestras acciones. Primero no sabemos nada y no estamos seguros en absoluto. Luego sabemos un poco y nos volvemos megaconfiados — este es el denominado 'pico de tontería', bien ilustrado por la imagen 'estupidez y valentía'. Después ya hemos aprendido un poco y estamos listos para entrar en acción. Luego pisamos algunos graves errores, caemos en el valle de la desesperación, donde parece que sabemos algo, pero en realidad no sabemos mucho. Luego, a medida que adquirimos experiencia, nos volvemos más seguros.
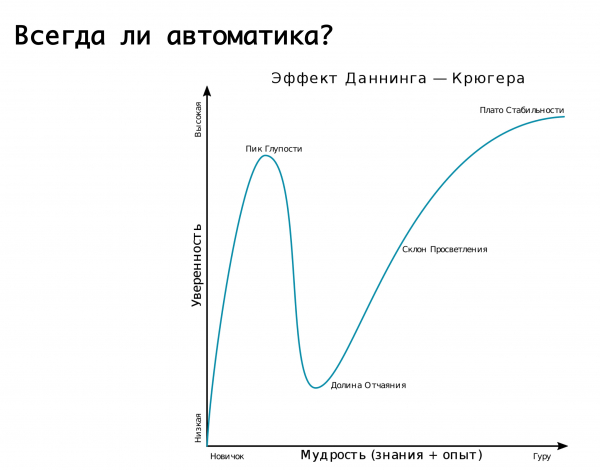
Nuestra lógica sobre varios cambios automáticos en caso de fallos se describe muy bien con este gráfico. Comenzamos sin saber nada, prácticamente todos los trabajos se realizaban manualmente. Luego comprendimos que podíamos automatizar todo y, de alguna manera, dormir tranquilos. Y de repente nos encontramos con un gran tropiezo: se activa un falso positivo y cambiamos el tráfico de un lado a otro, cuando, en realidad, no debería haberse hecho. Esto rompe la replicación o algo más: esa es la famosa zona de desesperación. Y luego llegamos a la comprensión de que debemos abordar todo con sabiduría. Es decir, merece la pena confiar en la automatización, previniendo la posibilidad de un falso positivo. ¡Pero! Si las consecuencias pueden ser destructivas, es mejor dejar esto en manos del turno de guardia, los ingenieros de guardia, quienes se asegurarán y verificarán que realmente hay un fallo y realizarán las acciones necesarias manualmente...
Conclusión
En 7 años hemos pasado de vivir en pánico cuando algo fallaba, a entender que no hay problemas, solo tareas que hay que resolver. Cuando construyes un servicio, míralo desde una perspectiva general, evalúa todos los riesgos que pueden surgir. Si los identificas de inmediato, prevé el respaldo y la posibilidad de construir una infraestructura tolerante a fallos, porque cualquier punto que pueda fallar y causar un mal funcionamiento del servicio, lo hará sin duda. Y aunque creas que algunos elementos de la infraestructura no fallarán, como el mismo s3, ten en cuenta que pueden hacerlo. Y al menos en teoría, ten una idea de lo que harás con ellos si algo sucede. Ten un plan para gestionar los riesgos. Cuando consideres si hacer todo automáticamente o manualmente, evalúa los riesgos: ¿qué pasará si la automatización comienza a cambiar todo? ¿No resultará eso en un panorama aún peor en comparación con una avería? Tal vez en algunos casos sea necesario encontrar un compromiso razonable entre la automatización y la reacción del ingeniero de guardia, quien evaluará la situación real y decidirá si necesita cambiar algo de inmediato o 'sí, pero no ahora'.
Un compromiso razonable entre el perfeccionismo y las verdaderas fuerzas, tiempo y dinero que puedes gastar en el esquema que tendrás al final.
Este texto es una versión ampliada y enriquecida del informe de Alexander Demidov en la conferencia .
Fuente: habr.com
