

Las aplicaciones web se utilizan hoy en día en todas partes, y entre todos los protocolos de transporte, HTTP ocupa una parte significativa. Al estudiar los matices del desarrollo de aplicaciones web, la mayoría presta muy poca atención al sistema operativo en el que realmente se ejecutan estas aplicaciones. La separación entre desarrollo (Dev) y operaciones (Ops) ha empeorado la situación. Pero con la difusión de la cultura DevOps, los desarrolladores comienzan a asumir la responsabilidad de desplegar sus aplicaciones en la nube, por lo que les resulta muy útil familiarizarse a fondo con el backend del sistema operativo. Esto es especialmente beneficioso si intentas implementar un sistema para miles o decenas de miles de conexiones simultáneas.
Las limitaciones en los servicios web son muy similares a las limitaciones en otras aplicaciones. Ya sea en balanceadores de carga o en servidores de bases de datos, todos estos tipos de aplicaciones enfrentan problemas similares en un entorno de alto rendimiento. Comprender estas limitaciones fundamentales y las formas de superarlas en general permitirá evaluar el rendimiento y la escalabilidad de tus aplicaciones web.
Escribo esta serie de artículos en respuesta a las preguntas de jóvenes desarrolladores que desean convertirse en arquitectos de sistemas bien informados. No se puede entender claramente los métodos de optimización de aplicaciones en Linux sin profundizar en los fundamentos de cómo funcionan a nivel de sistema operativo. Aunque hay muchos tipos de aplicaciones, en este ciclo quiero explorar aplicaciones de red, y no de escritorio, como un navegador o un editor de texto. Este material está dirigido a desarrolladores y arquitectos que desean entender cómo funcionan los programas en Linux o Unix y cómo estructurarlos para un alto rendimiento.
Linux es un sistema operativo servidor, y la mayoría de las veces tus aplicaciones funcionan precisamente en este SO. Aunque digo 'Linux', en la mayor parte del tiempo puedes suponer con confianza que me refiero a todos los sistemas operativos similares a Unix en general. Sin embargo, no he probado el código de soporte en otros sistemas. Así que, si te interesa FreeBSD u OpenBSD, el resultado puede variar. Cuando pruebo algo específico de Linux, lo indico.
Aunque puedes utilizar los conocimientos adquiridos para crear una aplicación desde cero y que esté perfectamente optimizada, es mejor no hacerlo. Si decides escribir un nuevo servidor web en C o C++ para la aplicación empresarial de tu organización, probablemente será tu último día en el trabajo. Sin embargo, conocer la estructura de estas aplicaciones te ayudará a elegir programas existentes. Podrás comparar sistemas basados en procesos con sistemas basados en hilos y también con sistemas basados en eventos. Entenderás y apreciarás por qué Nginx funciona mejor que Apache httpd, y por qué una aplicación de Python basada en Tornado puede atender a más usuarios en comparación con una aplicación de Python basada en Django.
ZeroHTTPd: herramienta de aprendizaje
— un servidor web que he escrito desde cero en C como herramienta educativa. No tiene dependencias externas, incluyendo acceso a Redis. Ejecutamos nuestros propios procedimientos de Redis. Más detalles abajo.
Aunque podríamos discutir mucho sobre la teoría, no hay nada mejor que escribir código, ejecutarlo y comparar entre las diferentes arquitecturas de servidor. Este es el método más ilustrativo. Por eso, estaremos escribiendo un servidor web simple ZeroHTTPd, aplicando cada modelo: basado en procesos, hilos y eventos. Probaremos cada uno de estos servidores y veremos cómo funcionan en comparación uno con otro. ZeroHTTPd está implementado en un solo archivo C. El servidor basado en eventos incluye , una excelente implementación de tabla hash que se proporciona en un solo archivo de cabecera. En otros casos, no hay dependencias para no complicar el proyecto.
El código tiene muchos comentarios para ayudar a entender. Siendo un servidor web simple en pocas líneas de código, ZeroHTTPd también es un marco mínimo para el desarrollo web. Tiene funcionalidad limitada, pero es capaz de entregar archivos estáticos y páginas 'dinámicas' muy básicas. Debo decir que ZeroHTTPd es muy adecuado para aprender a crear aplicaciones de Linux de alto rendimiento. En general, la mayoría de los servicios web están a la espera de solicitudes, las verifican y las procesan. Eso es exactamente lo que hará ZeroHTTPd. Es una herramienta de aprendizaje, no para producción. No es fuerte en el manejo de errores y probablemente no presuma de las mejores prácticas de seguridad (oh sí, utilicé strcpy) o con trucos enrevesados del lenguaje C. Pero espero que haga bien su trabajo.
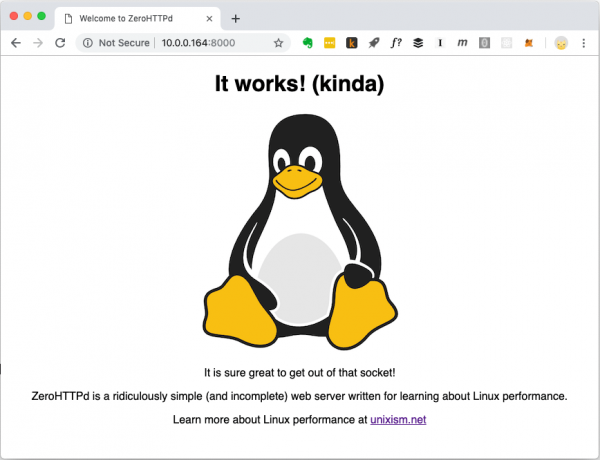
Página principal de ZeroHTTPd. Puede entregar diferentes tipos de archivos, incluyendo imágenes.
Aplicación del libro de visitas.
Las aplicaciones web modernas generalmente no se limitan a archivos estáticos. Tienen interacciones complejas con diferentes bases de datos, cachés, etc. Por lo tanto, crearemos una aplicación web sencilla llamada ‘Libro de visitas’, donde los visitantes dejan mensajes con sus nombres. En el libro de visitas se guardan los mensajes dejados anteriormente. También hay un contador de visitantes en la parte inferior de la página.
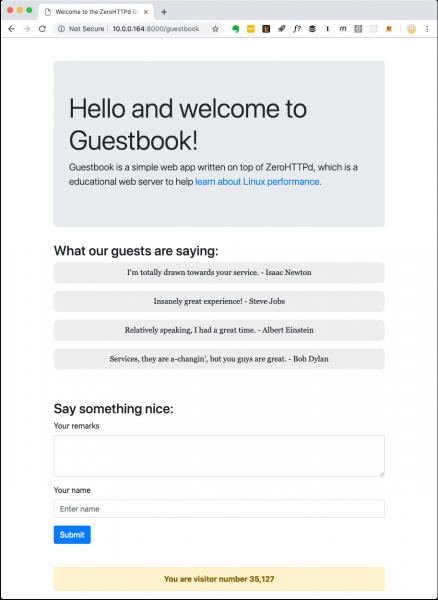
Aplicación del libro de visitas ZeroHTTPd.
El contador de visitantes y los mensajes del libro de visitas se almacenan en Redis. Se han implementado procedimientos propios para la comunicación con Redis, que no dependen de bibliotecas externas. No soy un gran fan de sacar código hecho en casa cuando hay soluciones disponibles y bien probadas. Sin embargo, el objetivo de ZeroHTTPd es estudiar el rendimiento de Linux y el acceso a servicios externos, mientras que el manejo de las solicitudes HTTP afecta gravemente al rendimiento. Debemos controlar completamente las comunicaciones con Redis en cada una de nuestras arquitecturas de servidor. En una arquitectura usamos llamadas bloqueantes, en otras, procedimientos basados en eventos. Usar una librería cliente externa de Redis no proporcionará ese control. Además, nuestro pequeño cliente de Redis solo realiza unas pocas funciones (obtener, configurar y aumentar una clave; obtener y agregar a un array). Además, el protocolo Redis es excepcionalmente elegante y simple. Ni siquiera es necesario aprenderlo específicamente. El hecho de que todo el trabajo del protocolo se realice en aproximadamente cien líneas de código habla de lo bien diseñado que está.
La siguiente figura muestra las acciones de la aplicación cuando el cliente (navegador) solicita. /guestbookURL.

Mecanismo de funcionamiento de la aplicación del libro de visitas.
Cuando se necesita generar la página del libro de visitas, se realiza una llamada al sistema de archivos para leer la plantilla en memoria y tres llamadas a Redis. El archivo de la plantilla contiene la mayor parte del contenido HTML para la página en la captura de pantalla de arriba. También hay marcadores especiales para la parte dinámica del contenido: las entradas y el contador de visitantes. Las obtenemos de Redis, las insertamos en la página y entregamos al cliente el contenido completamente formado. Se puede evitar la tercera llamada a Redis, ya que Redis devuelve un nuevo valor de clave al incrementarse. Sin embargo, para nuestro servidor con arquitectura asincrónica basada en eventos, múltiples llamadas de red son una buena prueba con fines educativos. Así, ignoramos el valor devuelto por Redis sobre la cantidad de visitantes y lo solicitamos en una llamada separada.
Arquitecturas de servidor ZeroHTTPd
Construimos siete versiones de ZeroHTTPd con la misma funcionalidad, pero con diferentes arquitecturas:
- Iterativa
- Servidor fork (un proceso hijo por solicitud)
- Servidor pre-fork (forking previo de procesos)
- Servidor con hilos de ejecución (un hilo por solicitud)
- Servidor con creación previa de hilos
- Arquitectura basada en
poll() - Arquitectura basada en
epoll
Medimos el rendimiento de cada arquitectura cargando el servidor con solicitudes HTTP. Pero al comparar arquitecturas con un alto grado de paralelismo, la cantidad de solicitudes aumenta. Probamos tres veces y calculamos el promedio.
Metodología de prueba
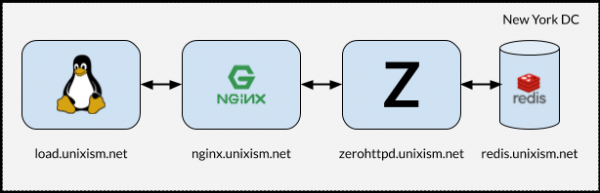
Configuración para la prueba de carga de ZeroHTTPd
Es importante que al realizar las pruebas, todos los componentes no se ejecuten en una sola máquina. En este caso, el sistema operativo incurre en costos adicionales de planificación, ya que los componentes compiten por la CPU. Medir el costo del sistema operativo con cada una de las arquitecturas de servidor elegidas es uno de los objetivos más importantes de este ejercicio. Agregar más variables perjudicará el proceso. Por lo tanto, la configuración en la imagen anterior funciona mejor.
Qué hace cada uno de estos servidores
- load.unixism.net: aquí ejecutamos
ab, la utilidad Apache Benchmark. Genera la carga necesaria para probar nuestras arquitecturas de servidor. - nginx.unixism.net: a veces queremos ejecutar más de una instancia de un programa de servidor. Para esto, el servidor Nginx con la configuración adecuada funciona como un equilibrador de carga, recibiendo las peticiones de ab nuestros procesos de servidor.
- zerohttpd.unixism.net: aquí ejecutamos nuestros programas de servidor en siete arquitecturas diferentes, una a la vez.
- redis.unixism.net: en este servidor se ejecuta el demonio Redis, donde se almacenan los registros en el libro de visitas y el contador de visitantes.
Todos los servidores funcionan en un núcleo de CPU. La idea es evaluar el rendimiento máximo de cada una de las arquitecturas. Como todos los programas de servidor se pruebas en el mismo hardware, este es el nivel básico para su comparación. Mi instalación de prueba consiste en servidores virtuales alquilados a Digital Ocean.
¿Qué estamos midiendo?
Se pueden medir diferentes métricas. Evaluamos el rendimiento de cada arquitectura en esta configuración, cargando los servidores con solicitudes a diferentes niveles de paralelismo: la carga aumenta de 20 a 15,000 usuarios concurrentes.
Resultados de pruebas
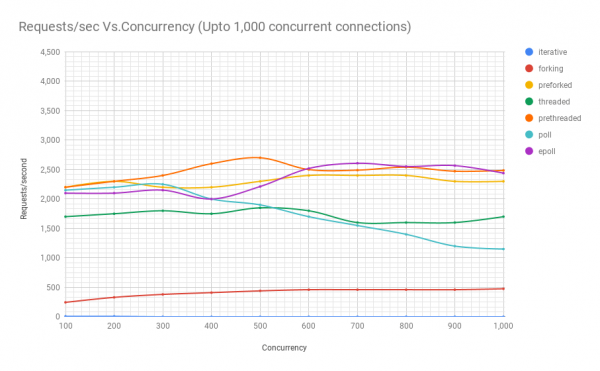
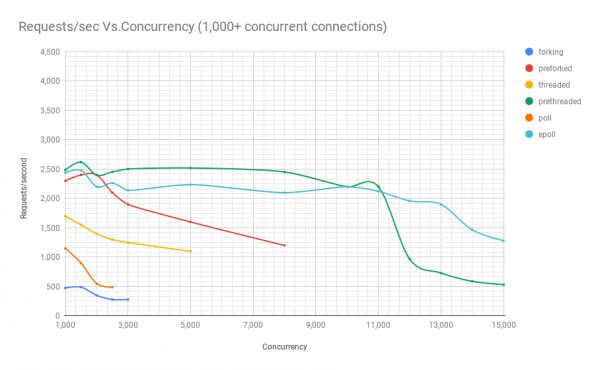
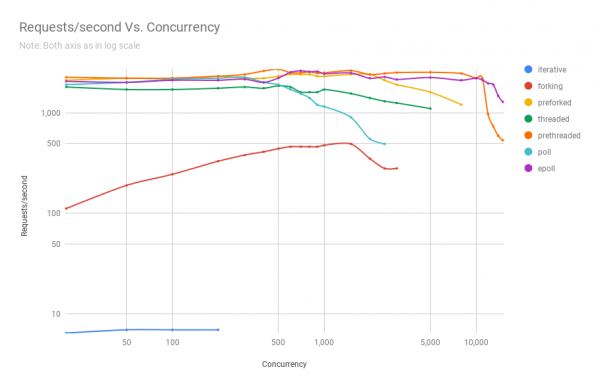
En el siguiente diagrama se muestra el rendimiento de los servidores en diferentes arquitecturas a varios niveles de paralelismo. En el eje y — cantidad de solicitudes por segundo, en el eje x — conexiones paralelas.
A continuación, una tabla con los resultados.
solicitudes por segundo
paralelismo
iterativo
fork
pre-fork
hilo
pre-hilo
poll
epoll
20
7
112
2100
1800
2250
1900
2050
50
7
190
2200
1700
2200
2000
2000
100
7
245
2200
1700
2200
2150
2100
200
7
330
2300
1750
2300
2200
2100
300
–
380
2200
1800
2400
2250
2150
400
–
410
2200
1750
2600
2000
2000
500
–
440
2300
1850
2700
1900
2212
600
–
460
2400
1800
2500
1700
2519
700
–
460
2400
1600
2490
1550
2607
800
–
460
2400
1600
2540
1400
2553
900
–
460
2300
1600
2472
1200
2567
1000
–
475
2300
1700
2485
1150
2439
1500
–
490
2400
1550
2620
900
2479
2000
–
350
2400
1400
2396
550
2200
2500
–
280
2100
1300
2453
490
2262
3000
–
280
1900
1250
2502
gran variabilidad
2138
5000
–
gran variabilidad
1600
1100
2519
–
2235
8000
–
–
1200
gran variabilidad
2451
–
2100
10 000
–
–
gran variabilidad
–
2200
–
2200
11 000
–
–
–
–
2200
–
2122
12 000
–
–
–
–
970
–
1958
13 000
–
–
–
–
730
–
1897
14 000
–
–
–
–
590
–
1466
15 000
–
–
–
–
532
–
1281
Del gráfico y la tabla se observa que por encima de 8000 solicitudes concurrentes solo nos quedan dos competidores: pre-fork y epoll. A medida que aumenta la carga, el servidor basado en polling tiene un rendimiento peor que el basado en hilos. La arquitectura con creación previa de hilos compite dignamente con epoll: esto es un testimonio de cuán bien el núcleo de Linux planifica una gran cantidad de hilos.
Código fuente de ZeroHTTPd
Código fuente de ZeroHTTPd . Para cada arquitectura hay un directorio separado.
ZeroHTTPd
│
├── 01_iterative
│   ├── main.c
├── 02_forking
│   ├── main.c
├── 03_preforking
│   ├── main.c
├── 04_threading
│   ├── main.c
├── 05_prethreading
│   ├── main.c
├── 06_poll
│   ├── main.c
├── 07_epoll
│    └── main.c
├── Makefile
├── public
│   ├── index.html
│   └── tux.png
└── templates
    └── guestbook
        └── index.html
Además de los siete directorios para todas las arquitecturas, en el directorio raíz hay dos más: public y templates. En el primero se encuentra el archivo index.html y la imagen del primer screenshot. Allí se pueden colocar otros archivos y carpetas, y ZeroHTTPd debería servir estos archivos estáticos sin problemas. Si la ruta en el navegador corresponde al camino en la carpeta public, ZeroHTTPd busca en este directorio el archivo index.html. El contenido del libro de visitas se genera de manera dinámica. Solo tiene una página principal, y su contenido se basa en el archivo 'templates/guestbook/index.html'. En ZeroHTTPd, es fácil agregar páginas dinámicas para extenderlo. La idea es que los usuarios pueden agregar plantillas en este directorio y expandir ZeroHTTPd según sea necesario.
Para compilar los siete servidores, ejecute make all desde el directorio raíz — y todas las compilaciones aparecerán en este directorio. Los archivos ejecutables buscan los directorios public y templates en el directorio desde el cual se inician.
Linux API
Para entender la información en este ciclo de artículos, no es necesario tener un buen dominio de la Linux API. Sin embargo, recomiendo leer más sobre este tema, hay muchos recursos de referencia disponibles en la red. Aunque tocamos algunas categorías de la Linux API, nuestra atención se centrará principalmente en los procesos, hilos, eventos y la pila de red. Además de libros y artículos sobre la Linux API, también recomiendo consultar las páginas man para las llamadas del sistema y las funciones de biblioteca utilizadas.
Rendimiento y escalabilidad
Una observación sobre rendimiento y escalabilidad. Teóricamente, no hay ninguna relación entre ellos. Puede tener un servicio web que funcione muy bien, con tiempos de respuesta de unos pocos milisegundos, pero que no sea escalable en absoluto. De igual manera, puede haber una aplicación web que funcione mal, que requiera varios segundos para responder, pero que sea escalable para manejar decenas de miles de usuarios simultáneos. Sin embargo, la combinación de alto rendimiento y escalabilidad es una combinación muy poderosa. Las aplicaciones de alto rendimiento, en general, utilizan los recursos de manera económica y, por lo tanto, pueden atender a más usuarios simultáneos en el servidor de manera efectiva, reduciendo costos.
Tareas de CPU y I/O
Finalmente, en los cálculos siempre hay dos tipos posibles de tareas: para I/O y CPU. Obtener solicitudes a través de Internet (entrada/salida de red), gestionar archivos (entrada/salida de red y disco), comunicarse con bases de datos (entrada/salida de red y disco) — todas estas son acciones de I/O. Algunas consultas a la base de datos pueden cargar un poco la CPU (ordenamiento, cálculo del promedio de un millón de resultados, etc.). La mayoría de las aplicaciones web están limitadas por el I/O máximo posible, mientras que el procesador rara vez se utiliza a plena capacidad. Cuando observa que se utiliza mucha CPU para una tarea de entrada/salida, es probable que sea un signo de mala arquitectura de la aplicación. Esto puede significar que los recursos de CPU se gastan en la gestión de procesos y el cambio de contexto — y eso no es del todo útil. Si está haciendo algo como procesamiento de imágenes, conversión de archivos de audio o aprendizaje automático, entonces la aplicación requiere recursos de CPU potentes. Pero para la mayoría de las aplicaciones no es así.
Más sobre arquitecturas de servidores
Fuente: habr.com
