

Cómo leer este artículo: pido disculpas por lo extenso y caótico del texto. Para ahorrar su tiempo, comienzo cada capítulo con una introducción "Lo que aprendí", donde resumo en una o dos oraciones la esencia del capítulo.
"¡Solo muestra la solución!" Si solo desea ver a qué llegué, pase al capítulo "Me vuelvo más ingenioso", pero creo que resulta más interesante y útil leer sobre mis fracasos.
Recientemente se me asignó configurar el proceso de manejo de un gran volumen de secuencias de ADN (técnicamente se trata de un chip SNP). Necesitaba obtener rápidamente datos sobre una ubicación genética específica (denominada SNP) para la posterior modelación y otras tareas. Con la ayuda de R y AWK, logré limpiar y organizar los datos de manera natural, acelerando considerablemente el procesamiento de solicitudes. No fue fácil y requirió numerosas iteraciones. Este artículo le ayudará a evitar algunos de mis errores y mostrará lo que finalmente logré.
Para empezar, algunas aclaraciones introductorias.
Datos
Nuestro centro universitario de procesamiento de información genética nos proporcionó datos en formato TSV por un volumen de 25 TB. Me llegaron en 5 paquetes, comprimidos con Gzip, cada uno conteniendo alrededor de 240 archivos de cuatro gigabytes. Cada fila contenía datos para un SNP de una persona. En total, se transmitieron datos sobre ~2,5 millones de SNP y ~60 mil personas. Además de la información de SNP, los archivos incluían numerosas columnas con números que reflejaban diferentes características, como la intensidad de lectura, la frecuencia de diferentes alelos, etc. Hubo alrededor de 30 columnas con valores únicos.
El objetivo
Como en cualquier proyecto de gestión de datos, lo más importante era determinar cómo se utilizarían los datos. En este caso principalmente estaríamos ajustando modelos y flujos de trabajo para SNP basados en SNP. Es decir, en simultáneo solo necesitaríamos datos sobre un SNP. Debía aprender a extraer todos los registros relacionados con uno de los 2,5 millones de SNP de la manera más simple, rápida y económica posible.
Cómo no hacer esto
Citaré un cliché adecuado:
No fallé mil veces, simplemente descubrí mil maneras de no procesar un montón de datos en un formato conveniente para las solicitudes.
Primer intento
Lo que aprendí: no existe una forma barata de procesar 25 Tb de una vez.
Después de asistir a la clase 'Métodos Avanzados de Procesamiento de Grandes Datos' en la Universidad de Vanderbilt, estaba seguro de que todo estaba resuelto. Quizás llevaría una o dos horas configurar el servidor Hive para procesar todos los datos y obtener un informe. Dado que nuestros datos se almacenan en AWS S3, utilicé el servicio , que permite aplicar consultas Hive SQL a los datos de S3. No es necesario configurar/levantar un clúster Hive y solo pagas por los datos que buscas.
Después de mostrarle a Athena mis datos y su formato, ejecuté algunas pruebas con consultas como estas:
select * from intensityData limit 10;Y obtuve rápidamente resultados bien estructurados. Listo.
Hasta que intentamos usar los datos en el trabajo...
Me pidieron que extrajera toda la información sobre SNP para probar un modelo. Ejecuté la consulta:
select * from intensityData
where snp = 'rs123456';
...y comencé a esperar. Después de ocho minutos y más de 4 Tb de datos solicitados, obtuve el resultado. Athena cobra por el volumen de datos encontrados, a $5 por terabyte. Así que esta única consulta me costó $20 y ocho minutos de espera. Para correr el modelo con todos los datos, tendría que esperar 38 años y pagar $50 millones. Obviamente, eso no nos funcionaba.
Era necesario usar Parquet...
Lo que aprendí: ten cuidado con el tamaño de tus archivos Parquet y su organización.
Primero intenté corregir la situación convirtiendo todos los TSV a . Son convenientes para trabajar con grandes conjuntos de datos, porque la información se almacena en formato columnar: cada columna reside en su propio segmento de memoria/disco, a diferencia de los archivos de texto donde las filas contienen elementos de cada columna. Y si necesitas encontrar algo, solo es necesario leer la columna requerida. Además, en cada archivo, cada columna almacena un rango de valores, por lo que si el valor buscado no está en el rango de la columna, Spark no perderá tiempo escaneando todo el archivo.
Ejecuté una tarea simple para convertir nuestros TSV a Parquet y subir nuevos archivos a Athena. Esto tomó alrededor de 5 horas. Pero cuando ejecuté la consulta, el tiempo de ejecución fue aproximadamente el mismo y un poco menos dinero. El problema es que Spark, tratando de optimizar la tarea, simplemente descomprimió un chunk de TSV y lo colocó en su propio chunk de Parquet. Y dado que cada chunk era lo suficientemente grande y contenía registros completos de muchas personas, cada archivo almacenaba todos los SNP, por lo que Spark tenía que abrir todos los archivos para extraer la información necesaria.
Curiosamente, el tipo de compresión predeterminado (y recomendado) en Parquet — snappy — no es dividible (splitable). Por lo tanto, cada ejecutor (executor) se atasca en la tarea de descompresión y carga del conjunto de datos completo de 3,5 GB.
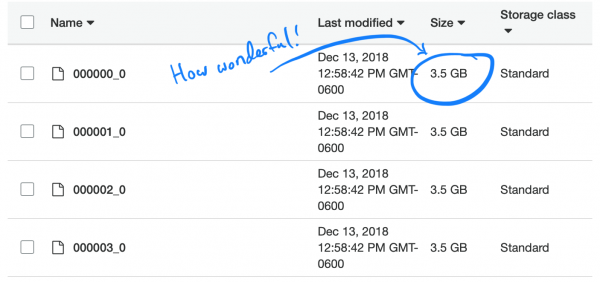
Estamos investigando el problema
Lo que aprendí: es complicado clasificar, especialmente si los datos están distribuidos.
Me parecía que ahora entendía la esencia del problema. Solo necesitaba clasificar los datos por la columna SNP, no por personas. Entonces, en un chunk de datos separado, habría varios SNP, y así es donde se manifestaría en todo su esplendor la función "inteligente" de Parquet que "abre solo si el valor está en el rango". Desafortunadamente, clasificar miles de millones de filas esparcidas por el clúster resultó ser una tarea complicada.
Yo tomando clases de algoritmos en la universidad: «Ugh, a nadie le importa la complejidad computacional de todos estos algoritmos de clasificación»
Yo tratando de clasificar una columna en 20TB tabla: «¿Por qué está tardando tanto?» luchas.
— Nick Strayer (@NicholasStrayer)
AWS definitivamente no quiere devolver el dinero por la razón de que «Soy un estudiante distraído». Después de ejecutar la clasificación en Amazon Glue, funcionó durante 2 días y terminó con un error.
¿Qué pasa con el particionado?
Lo que aprendí: las particiones en Spark deben estar equilibradas.
Luego se me ocurrió la idea de particionar los datos en cromosomas. Hay 23 (y algunos más, si se cuentan el ADN mitocondrial y las áreas no mapeadas).
Esto permitirá dividir los datos en porciones más pequeñas. Si agrego en la función de exportación de Spark en el script de Glue solo una línea partition_by = "chr", los datos deberían estar distribuidos en buckets.
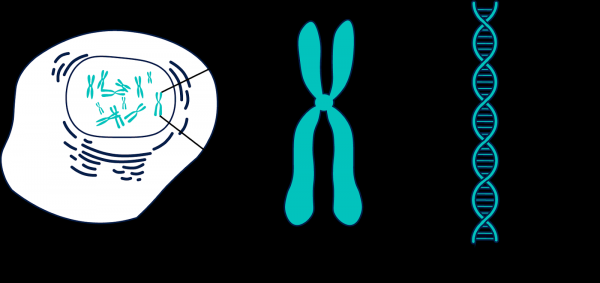
El genoma está compuesto de numerosos fragmentos que se llaman cromosomas.
Desafortunadamente, eso no funcionó. Los cromosomas tienen diferentes tamaños, lo que significa que contienen diferentes cantidades de información. Esto significa que las tareas que Spark enviaba a los trabajadores no estaban equilibradas y se ejecutaban lentamente, ya que algunos nodos terminaban antes y quedaban inactivos. Sin embargo, las tareas se completaron. Pero al solicitar un SNP, el desequilibrio volvió a causar problemas. El costo de procesamiento de SNP en cromosomas más grandes (es decir, de donde queremos obtener los datos) se redujo solo aproximadamente 10 veces. Es mucho, pero no suficiente.
¿Y si dividimos en particiones aún más pequeñas?
Lo que aprendí: en general, nunca intentes hacer 2,5 millones de particiones.
Decidí ir a lo grande y particioné cada SNP. Esto garantizaba particiones de tamaño uniforme. FUE UNA MALA IDEA. Usé Glue y añadí una línea inocente partition_by = 'snp'. La tarea se lanzó y comenzó a ejecutarse. Un día después, revisé y vi que aún no se había escrito nada en S3, así que maté la tarea. Parece que Glue estaba escribiendo archivos intermedios en un lugar oculto en S3, y había muchos archivos, tal vez un par de millones. Como resultado, mi error costó más de mil dólares y no impresionó a mi mentor.
Particionamiento + ordenación
Lo que aprendí: ordenar sigue siendo complicado, al igual que configurar Spark.
El último intento de particionamiento fue que particioné los cromosomas y luego ordené cada partición. En teoría, esto debería haber acelerado cada consulta, ya que los datos deseados sobre SNP deberían estar dentro de unos pocos bloques Parquet dentro de un rango dado. Sin embargo, ordenar incluso los datos particionados resultó ser una tarea difícil. Como resultado, me cambié a EMR para un clúster personalizado y utilicé ocho instancias potentes (C5.4xl) y Sparklyr para crear un flujo de trabajo más flexible…
# Sparklyr snippet to partition by chr and sort w/in partition
# Join the raw data with the snp bins
raw_data
  group_by(chr) %>%
  arrange(Position) %>%
  Spark_write_Parquet(
    path = DUMP_LOC,
    mode = 'overwrite',
    partition_by = c('chr')
  )
…sin embargo, la tarea aún no se completó. Ajusté de muchas maneras: aumenté la memoria asignada a cada ejecutor de consultas, utilicé nodos con mayor capacidad de memoria, apliqué variables de difusión (broadcasting variable), pero cada vez resultaban ser soluciones parciales, y gradualmente los ejecutores comenzaron a fallar, hasta que todo se detuvo.
Actualización: así comienza.
— Nick Strayer (@NicholasStrayer)
Me vuelvo más ingenioso
Lo que aprendí: a veces los datos especiales requieren soluciones especiales.
Cada SNP tiene un valor de posición. Este número corresponde a la cantidad de bases que se encuentran a lo largo de su cromosoma. Es una buena y natural forma de organizar nuestros datos. Al principio quería particionar por regiones de cada cromosoma. Por ejemplo, posiciones 1 — 2000, 2001 — 4000, etc. Pero el problema es que los SNP están distribuidos de manera desigual por los cromosomas, por lo que el tamaño de los grupos variará significativamente.
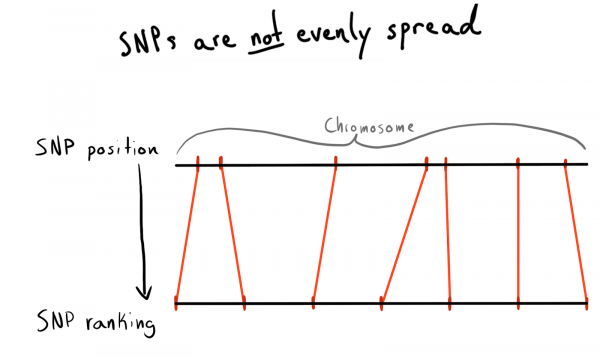
Como resultado, llegué a la división por categorías (rank) de posiciones. Con los datos ya cargados, ejecuté una consulta para obtener una lista de SNP únicos, sus posiciones y cromosomas. Luego, clasifiqué los datos dentro de cada cromosoma y agrupé los SNP en grupos (bin) de un tamaño determinado. Digamos, de 1000 SNP. Esto me dio la relación SNP con grupo-en-cromosoma.
Finalmente, hice grupos (bin) de 75 SNP; la razón la explicaré a continuación.
snp_to_bin %
  group_by(chr) %>%
  arrange(position) %>%
  mutate(
    rank = 1:n()
    bin = floor(rank/snps_per_bin)
  ) %>%
  ungroup()
Primer intento con Spark
Lo que aprendí: la unión en Spark funciona rápido, pero la partición aún resulta costosa.
Quería leer este pequeño (2.5 millones de filas) marco de datos en Spark, unirlo con los datos crudos y luego particionar por la columna recién agregada. bin.
# Join the raw data with the snp bins
data_w_bin <- raw_data %>%
  left_join(sdf_broadcast(snp_to_bin), by ='snp_name') %>%
  group_by(chr_bin) %>%
  arrange(Position) %>%
  Spark_write_Parquet(
    path = DUMP_LOC,
    mode = 'overwrite',
    partition_by = c('chr_bin')
  )
He utilizado sdf_broadcast(), de este modo Spark sabe que debe enviar el marco de datos a todos los nodos. Esto es útil si los datos son de tamaño pequeño y se requieren para todas las tareas. De lo contrario, Spark intenta ser inteligente y distribuye los datos según sea necesario, lo que puede causar lentitud.
Y de nuevo mi idea no funcionó: las tareas funcionaron durante un tiempo, completaron la unión y luego, al igual que los ejecutores que se iniciaron con la partición, comenzaron a fallar.
Agrego AWK
Lo que aprendí: no duermas cuando te enseñan lo básico. Seguramente alguien ya resolvió tu problema en la década de 1980.
Hasta ese momento, la razón de todos mis fracasos con Spark había sido la mezcla de datos en el clúster. Quizás la situación se pueda mejorar con un preprocesamiento. Decidí intentar dividir los datos de texto crudos en columnas de cromosomas, así esperaba proporcionar a Spark datos "pre-particionados".
Busqué en StackOverflow cómo dividir por los valores de las columnas y encontré Con AWK, puede dividir un archivo de texto por los valores de las columnas, realizando la escritura en un script en lugar de enviar los resultados a stdout.
Para probar, escribí un script en Bash. Descargué uno de los TSV comprimidos y luego lo descomprimí con gzip y lo envié a awk.
gzip -dc path/to/chunk/file.gz |
awk -F 't'
'{print $1",..."$30" > "chunked/"$chr"_chr"$15".csv"}'
¡Funcionó!
Rellenar núcleos
Lo que aprendí: gnu parallel es algo mágico, todos deben usarlo.
La división procedía bastante lento, y cuando ejecuté htop, para comprobar el uso de una instancia EC2 poderosa (y costosa), resultó que solo estaba utilizando un núcleo y aproximadamente 200 Mb de memoria. Para resolver el problema y no perder una fortuna, necesitaba encontrar cómo paralelizar el trabajo. Afortunadamente, en un libro absolutamente impresionante, de Jeroen Janssens, encontré un capítulo dedicado a la paralelización. Aprendí sobre gnu parallel, un método muy flexible para implementar multihilo en Unix.
Cuando ejecuté la división usando el nuevo proceso, todo fue perfecto, pero había un cuello de botella: la descarga de objetos S3 en disco no era muy rápida y no estaba completamente paralelizada. Para solucionar esto, hice lo siguiente:
- Descubrí que se podía implementar la etapa de descarga S3 directamente en la tubería, eliminando por completo el almacenamiento intermedio en disco. Esto significa que podía evitar escribir datos en crudo en disco y usar un almacenamiento aún más pequeño, y por lo tanto más barato, en AWS.
- Con el comando
aws configure set default.s3.max_concurrent_requests 50aumentó significativamente el número de hilos que utiliza AWS CLI (por defecto son 10). - Cambié a una instancia EC2 optimizada para velocidad en red, con la letra n en su nombre. Descubrí que la pérdida de capacidad de cómputo al usar instancias n se compensa con creces por el aumento de la velocidad de carga. Para la mayoría de las tareas, utilicé c5n.4xl.
- Cambié
gzipen , que es una herramienta gzip que puede hacer cosas geniales para paralelizar una tarea de descompresión que originalmente no era paralelizada (esto ayudó muy poco).
# Let S3 use as many threads as it wants
aws configure set default.s3.max_concurrent_requests 50

for chunk_file in $(aws s3 ls $DATA_LOC | awk '{print $4}' | grep 'chr'$DESIRED_CHR'.csv') ; do

        aws s3 cp s3://$batch_loc$chunk_file - |
        pigz -dc |
        parallel --block 100M --pipe
        "awk -F 't' '{print $1",..."$30">"chunked/{#}_chr"$15".csv"}'"

       # Combine all the parallel process chunks to single files
        ls chunked/ |
        cut -d '_' -f 2 |
        sort -u |
        parallel 'cat chunked/*_{} | sort -k5 -n -S 80% -t, | aws s3 cp - '$s3_dest'/batch_'$batch_num'_{}'

         # Clean up intermediate data
       rm chunked/*
done
Estos pasos se combinan entre sí para que todo funcione muy rápido. Gracias al aumento de la velocidad de descarga y a la eliminación de la escritura en disco, ahora podía procesar un paquete de 5 terabytes en solo unas pocas horas.
No hay nada más dulce que ver todos los núcleos que estás pagando en AWS siendo utilizados. Gracias a gnu-parallel, puedo descomprimir y dividir un CSV de 19 gigas tan rápido como puedo descargarlo. Ni siquiera pude hacer que Spark funcionara.
— Nick Strayer (@NicholasStrayer)
Este tuit debería mencionar 'TSV'. Lamentablemente.
Uso de datos volver a analizados
Lo que aprendí: Spark ama los datos no comprimidos y no le gusta combinar particiones.
Ahora los datos estaban en S3 en un formato no comprimido (es decir, particionado) y semiestructurado, y podía volver a Spark. Me esperaba una sorpresa: ¡no logré lo que quería otra vez! Era muy difícil indicarle a Spark cómo estaban particionados los datos. Y incluso cuando lo hice, resultó que había demasiadas particiones (95 mil), y cuando utilicé coalesce para reducirlas a niveles razonables, esto arruinó mi particionado. Estoy seguro de que se puede solucionar, pero tras un par de días buscando, no encontré una solución. Al final, completé todas las tareas en Spark, aunque tomó un tiempo, y mis archivos Parquet divididos no eran muy pequeños (~200 Kb). Sin embargo, los datos estaban donde debía.
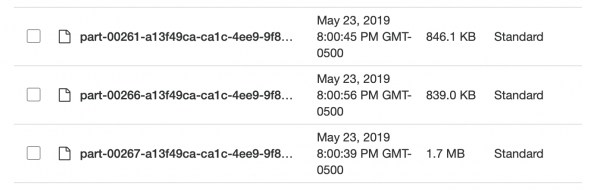
¡Demasiado pequeños y desiguales, maravilloso!
Pruebas de consultas locales de Spark
Lo que aprendí: hay demasiados gastos generales en Spark para resolver tareas simples.
Al cargar datos en un formato bien pensado, pude probar la velocidad. Configuré un script en R para ejecutar un servidor local de Spark y luego cargué el marco de datos de Spark desde el almacenamiento de grupos Parquet (bin). Intenté cargar todos los datos, pero no pude hacer que Sparklyr reconociera el particionado.
sc <- Spark_connect(master = "local")

desired_snp <- 'rs34771739'

# Iniciar un temporizador
start_time <- Sys.time()

# Cargar el bin deseado en Spark
intensity_data %
  Spark_read_Parquet(
    name = 'intensity_data',
    path = get_snp_location(desired_snp),
    memory = FALSE )

# Subconjunto bin a snp y luego recoger a local
test_subset %
  filter(SNP_Name == desired_snp) %>%
  collect()

print(Sys.time() - start_time)
La ejecución tomó 29,415 segundos. Mucho mejor, pero no lo suficientemente bueno para pruebas masivas de nada. Además, no podía acelerar el trabajo usando almacenamiento en caché, porque cuando intentaba almacenar en la memoria el marco de datos, Spark siempre fallaba, incluso cuando asigné más de 50 GB de memoria para un conjunto de datos que pesaba menos de 15.
Regreso a AWK
Lo que aprendí: los arrays asociativos en AWK son muy eficientes.
Sabía que podía lograr una mayor velocidad. Recordé que en la maravillosa Leí sobre una característica genial llamada «». En esencia, son pares clave-valor, que curiosamente en AWK se llaman de otra manera, y por eso no los había recordado mucho. me recordó que el término «arrays asociativos» es mucho más antiguo que el término «par clave-valor». Incluso si , no encontrarás ese término, aunque sí hallarás arrays asociativos. Además, «par clave-valor» se asocia más frecuentemente con bases de datos, por lo que es más lógico compararlo con hashmap. Me di cuenta de que puedo usar estos arrays asociativos para conectar mis SNP con la tabla de grupos (tabla de bin) y datos crudos sin usar Spark.
Para ello, en el script de AWK utilicé el bloque BEGIN. Este es un fragmento de código que se ejecuta antes de que se envíe la primera línea de datos al cuerpo principal del script.
join_data.awk
BEGIN {
  FS=",";
  batch_num=substr(chunk,7,1);
  chunk_id=substr(chunk,15,2);
  while(getline  "chunked/chr_"chr"_bin_"bin[$1]"_"batch_num"_"chunk_id".csv"
}
Comando while(getline...) cargó todas las filas del CSV del grupo (bin), estableció la primera columna (nombre del SNP) como clave para el array asociativo bin y el segundo valor (grupo) como su valor. Luego, en el bloque { }, que se ejecuta para todas las filas del archivo principal, cada fila se envía a un archivo de salida que recibe un nombre único dependiendo de su grupo (bin): ..._bin_"bin[$1]"_....
Variables batch_num y chunk_id coincidieron con los datos proporcionados por el pipeline, lo que permitió evitar condiciones de carrera, y cada hilo de ejecución que se lanzó parallel, escribía en su propio archivo único.
Dado que había distribuido todos los datos crudos en carpetas por cromosomas, que sobraron de mi experimento anterior con AWK, ahora podía escribir otro script de Bash para procesar un cromosoma a la vez y entregar datos más profundamente particionados en S3.
DESIRED_CHR='13'

# Descargar los datos del cromosoma de s3 y dividir en bins
aws s3 ls $DATA_LOC |
awk '{print $4}' |
grep 'chr'$DESIRED_CHR'.csv' |
parallel "echo 'reading {}'; aws s3 cp "$DATA_LOC"{} - | awk -v chr=""$DESIRED_CHR"" -v chunk="{}" -f split_on_chr_bin.awk"

# Combinar todos los fragmentos del proceso paralelo en archivos únicos y subir a rds usando R
ls chunked/ |
cut -d '_' -f 4 |
sort -u |
parallel "echo 'zipping bin {}'; cat chunked/*_bin_{}_*.csv | ./upload_as_rds.R '$S3_DEST'/chr_'$DESIRED_CHR'_bin_{}.rds"
rm chunked/*
El script tiene dos secciones parallel.
En la primera sección se leen los datos de todos los archivos que contienen información sobre el cromosoma necesario, luego estos datos se distribuyen entre hilos que agrupan los archivos en grupos correspondientes (bin). Para evitar condiciones de carrera, cuando varios hilos escriben en un mismo archivo, AWK les proporciona nombres de archivo para escribir datos en diferentes ubicaciones, por ejemplo, chr_10_bin_52_batch_2_aa.csv. Como resultado, se crean muchos archivos pequeños en el disco (para esto utilicé volúmenes EBS de un terabyte).
El canal de la segunda sección parallel pasa por los grupos (bin) y combina sus archivos individuales en un CSV común con cat, y luego los envía para exportación.
¿Transmisión en R?
Lo que aprendí: se puede acceder a stdin y stdout desde un script de R, lo que significa que también puede utilizarse en el canal.
En el script de Bash, podría haber notado la siguiente línea: ...cat chunked/*_bin_{}_*.csv | ./upload_as_rds.R.... Esta línea transmite todos los archivos concatenados del grupo (bin) al siguiente script de R. {} es una técnica especial parallel, que inserta cualquier dato que envía a la corriente especificada directamente en el comando. La opción {#} proporciona un ID único para el hilo de ejecución, y {%} es el número de ranura de trabajo (se repite, pero nunca al mismo tiempo). La lista de todas las opciones se puede encontrar en
#!/usr/bin/env Rscript
library(readr)
library(aws.s3)

# Read first command line argument
data_destination <- commandArgs(trailingOnly = TRUE)[1]

data_cols <- list(SNP_Name = 'c', ...)

s3saveRDS(
  read_csv(
        file("stdin"),
        col_names = names(data_cols),
        col_types = data_cols
    ),
  object = data_destination
)
Cuando la variable file("stdin") se pasa a readr::read_csv, los datos transmitidos al script de R se cargan en un marco que luego se graba como .rds-archivo utilizando aws.s3 que se escribe directamente en S3.
RDS es algo así como una versión simplificada de Parquet, sin los lujos del almacenamiento en columnas.
Después de que finalizó el script de Bash, obtuve un montón de .rds-archivos en S3, lo que me permitió utilizar una compresión eficiente y tipos integrados.
A pesar del uso del lento R, todo funcionó muy rápido. No es sorprendente que los fragmentos en R responsables de leer y escribir datos estén bien optimizados. Después de probar en un cromosoma de tamaño medio, la tarea se completó en una instancia C5n.4xl en aproximadamente dos horas.
Limitaciones de S3
Lo que aprendí: gracias a una implementación inteligente de rutas, S3 puede manejar muchos archivos.
Estaba preocupado de si S3 podría manejar muchos archivos que se le enviaban. Podría hacer que los nombres de los archivos fueran significativos, pero ¿cómo buscará S3 a través de ellos?
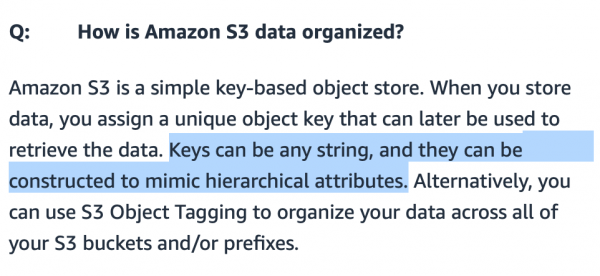
Las carpetas en S3 son solo decorativas, en realidad al sistema no le interesa el símbolo /.
Parece que S3 representa la ruta a un archivo específico como una simple clave en una especie de tabla hash o base de datos basada en documentos. Se puede considerar que el bucket es una tabla y los archivos son registros en esa tabla.
Dado que la velocidad y la eficiencia son importantes para obtener beneficios en Amazon, no es sorprendente que este sistema de "clave-como-ruta-al-archivo" esté increíblemente optimizado. Intenté encontrar un equilibrio: para que no sea necesario realizar muchas solicitudes GET, pero que al mismo tiempo las solicitudes se ejecuten rápidamente. Resultó que lo mejor es hacer alrededor de 20,000 archivos binarios. Creo que si continúo optimizando, se puede lograr un aumento en la velocidad (por ejemplo, creando un bucket especial solo para datos, reduciendo así el tamaño de la tabla de búsqueda). Pero no había tiempo y dinero para más experimentos.
¿Qué hay de la compatibilidad cruzada?
Lo que aprendí: la principal razón de la pérdida de tiempo es la optimización prematura de tu método de almacenamiento.
En este momento, es muy importante preguntarse: "¿Por qué usar un formato de archivo propietario?" La razón radica en la velocidad de carga (los archivos CSV comprimidos en gzip se cargaban 7 veces más lento) y la compatibilidad con nuestros flujos de trabajo. Puedo revisar mi decisión si R puede cargar fácilmente archivos Parquet (o Arrow) sin la carga adicional de Spark. En nuestro laboratorio, todos usan R, y si necesito convertir datos a otro formato, todavía tengo los datos de texto originales, así que puedo reiniciar el canal.
División del trabajo
Lo que aprendí: no intentes optimizar tareas manualmente, deja que la computadora lo haga.
Depuré el flujo de trabajo en un cromosoma, ahora necesito procesar todos los demás datos.
Quería lanzar varias instancias de EC2 para la conversión, pero al mismo tiempo tenía miedo de obtener una carga extremadamente desbalanceada en diferentes tareas de procesamiento (así como Spark sufría por particiones desbalanceadas). Además, no me agradaba levantar una instancia por cada cromosoma, porque hay un límite predeterminado de 10 instancias por cuenta de AWS.
Entonces decidí escribir un script en R para optimizar las tareas de procesamiento.
Primero pedí a S3 que calculase cuánto espacio en el almacenamiento ocupa cada cromosoma.
library(aws.s3)
library(tidyverse)

chr_sizes %
  mutate(Size = as.numeric(Size)) %>%
  filter(Size != 0) %>%
  mutate(
    # Extraer el cromosoma del nombre del archivo
    chr = str_extract(Key, 'chr.{1,4}.csv') %>%
             str_remove_all('chr|.csv')
  ) %>%
  group_by(chr) %>%
  summarise(total_size = sum(Size)/1e+9) # Dividir para obtener el valor en GB


# Un tibble: 27 x 2
   chr   total_size

 1 0           163.
 2 1           967.
 3 10          541.
 4 11          611.
 5 12          542.
 6 13          364.
 7 14          375.
 8 15          372.
 9 16          434.
10 17          443.
# … con 17 filas más
Luego escribí una función que toma el tamaño total, mezcla el orden de los cromosomas y los divide en grupos. num_jobs y reporta cuán diferentes son los tamaños de todos los trabajos de procesamiento.
num_jobs <- 7
# ¿Qué tan grande sería cada trabajo si se dividiera perfectamente?
job_size <- sum(chr_sizes$total_size)/7

shuffle_job %
    sample_frac() %>%
    mutate(
      cum_size = cumsum(total_size),
      job_num = ceiling(cum_size/job_size)
    ) %>%
    group_by(job_num) %>%
    summarise(
      job_chrs = paste(chr, collapse = ','),
      total_job_size = sum(total_size)
    ) %>%
    mutate(sd = sd(total_job_size)) %>%
    nest(-sd)
}

shuffle_job(1)


# Un tibble: 1 x 2
     sd data

1  153.
Después corrí mil mezclas usando purrr y elegí la mejor.
1:1000 %>%
  map_df(shuffle_job) %>%
  filter(sd == min(sd)) %>%
  pull(data) %>%
  pluck(1)
Así obtuve un conjunto de trabajos, muy parecidos en tamaño. Luego solo quedaba envolver mi anterior script de Bash en un gran ciclo. para. Me tomó alrededor de 10 minutos escribir esta optimización. Y eso es mucho menos que lo que habría gastado creando trabajos manualmente en caso de que estuvieran desbalanceados. Así que creo que no me equivoqué con esta optimización previa.
for DESIRED_CHR in "16" "9" "7" "21" "MT"
do
# Código para procesar un solo cromosoma
fi
Al final añado el comando de apagado:
sudo shutdown -h now … ¡y todo funcionó! Usando AWS CLI levanté instancias y mediante la opción user_data les pasé scripts de Bash para sus trabajos de procesamiento. Se ejecutaron y se apagaron automáticamente, así que no pagué por potencia computacional excesiva.
aws ec2 run-instances ...
--tag-specifications "ResourceType=instance,Tags=[{Key=Name,Value=<>}]"
--user-data file://<>
¡Empaquetemos!
Lo que aprendí: La API debe ser simple por razones de simplicidad y flexibilidad de uso.
Finalmente obtuve los datos en el lugar y formato necesarios. Solo quedaba maximizar la simplificación del proceso de uso de los datos para que a mis colegas les fuera más fácil. Quería crear una API sencilla para generar solicitudes. Si en el futuro decido cambiar de .rds en archivos Parquet, esto debería ser un problema para mí, no para mis colegas. Por eso decidí crear un paquete interno en R.
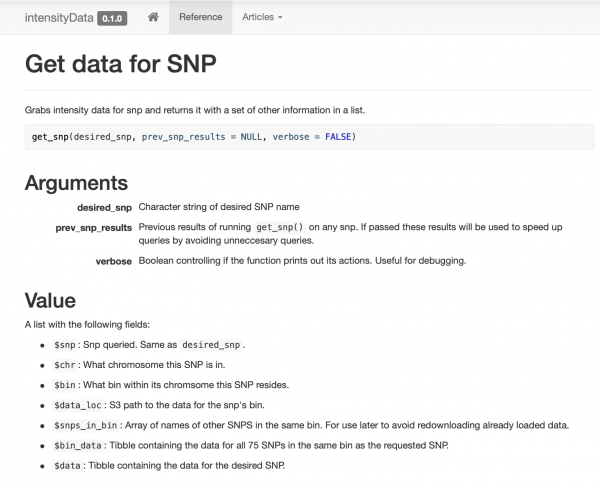
Reuní y documenté un paquete muy simple, que contiene solo unas pocas funciones para acceder a los datos, basado en la función get_snp. También creé para mis colegas un sitio , para que puedan ver fácilmente ejemplos y documentación.
Caché inteligente
Lo que aprendí: si tus datos están bien preparados, ¡el caché será fácil!
Dado que uno de los principales flujos de trabajo aplicaba el mismo modelo de análisis al paquete SNP, decidí aprovechar el agrupamiento (binning). Al pasar datos por SNP, se adjunta toda la información del grupo (bin) al objeto devuelto. Así, las consultas antiguas pueden (en teoría) acelerar el procesamiento de nuevas consultas.
# Part of get_snp()
...
  # Test if our current snp data has the desired snp.
  already_have_snp <- desired_snp %in% prev_snp_results$snps_in_bin

  if(!already_have_snp){
    # Grab info on the bin of the desired snp
    snp_results <- get_snp_bin(desired_snp)

    # Download the snp's bin data
    snp_results$bin_data <- aws.s3::s3readRDS(object = snp_results$data_loc)
  } else {
    # The previous snp data contained the right bin so just use it
    snp_results <- prev_snp_results
  }
...
Al construir el paquete, ejecuté muchos benchmarks para comparar la velocidad de diferentes métodos. Recomiendo no descuidar esto, ya que a veces los resultados son sorprendentes. Por ejemplo, dplyr::filter resultó ser mucho más rápido que la captura de filas mediante filtrado basado en indexación, y obtener una columna de un marco de datos filtrado funcionó mucho más rápido que aplicar la sintaxis de indexación.
Ten en cuenta que el objeto prev_snp_results contiene la clave snps_in_bin. Este es un array de todos los SNP únicos en el grupo (bin), que permite verificar rápidamente si ya hay datos de una consulta anterior. También facilita el paso cíclico por todos los SNP en el grupo (bin) con este código:
# Get bin-mates
snps_in_bin <- my_snp_results$snps_in_bin

for(current_snp in snps_in_bin){
  my_snp_results <- get_snp(current_snp, my_snp_results)
  # Do something with results
}
Resultados
Ahora podemos (y comenzamos seriamente) a ejecutar modelos y escenarios que antes no estaban a nuestro alcance. Lo mejor de todo es que mis colegas de laboratorio no tienen que preocuparse por las complejidades. Simplemente tienen una función que funciona.
Y aunque el paquete los libera de los detalles, intenté que el formato de datos fuera lo suficientemente sencillo como para que pudieran entenderlo si de repente desaparezco mañana...
La velocidad ha aumentado considerablemente. Normalmente escaneamos fragmentos funcionalmente significativos del genoma. Antes no podíamos hacerlo (resultaba demasiado caro), pero ahora, gracias a la estructura de grupos (bin) y la caché, la consulta de un SNP toma en promedio menos de 0,1 segundos, y el uso de datos es tan bajo que los costos de obtener S3 son mínimos.
Recientemente, me pusieron a cargo de manejar más de 25 TB de datos de genotipado en bruto para mi laboratorio. Cuando comencé, utilizar Spark tomaba 8 minutos y costaba $20 para consultar un SNP. Después de usar AWK + para procesar, ahora toma menos de una décima de segundo y cuesta $0.00001. Mi victoria personal gané.
— Nick Strayer (@NicholasStrayer)
Conclusión
Este artículo no es un manual. La solución fue individual y casi seguramente no es óptima. Más bien, es un relato de un viaje. Quiero que otros entiendan que tales soluciones no surgen completamente formadas en la cabeza, son el resultado de pruebas y errores. Además, si estás buscando un especialista en análisis de datos, ten en cuenta que para utilizar eficazmente estas herramientas se necesita experiencia, y la experiencia requiere dinero. Estoy feliz de haber tenido fondos para pagar, pero muchos otros que podrían hacer el mismo trabajo mejor que yo nunca tendrán esa oportunidad por falta de dinero incluso para intentarlo.
Las herramientas para grandes datos son universales. Si tienes tiempo, casi seguro que podrás escribir una solución más rápida aplicando una ‘limpieza’ inteligente de datos, almacenamiento y metodologías de extracción. En última instancia, todo se reduce a analizar el costo y el beneficio.
Lo que he aprendido:
- no hay forma barata de analizar 25 TB de una vez;
- ten cuidado con el tamaño y la organización de tus archivos Parquet;
- las particiones en Spark deben estar equilibradas;
- nunca intentes hacer 2.5 millones de particiones;
- ordenar sigue siendo difícil, igual que configurar Spark;
- a veces, datos especiales requieren soluciones especiales;
- la unión en Spark funciona rápido, pero la partición aún es costosa;
- no duermas cuando te enseñan lo básico, seguramente alguien ya resolvió tu problema en los años 80;
gnu paralleles algo mágico, todos deberían usarlo;- Spark ama los datos sin comprimir y no le gusta combinar particiones;
- en Spark hay demasiados gastos generales al resolver tareas simples;
- los arrays asociativos en AWK son muy eficientes;
- puedes acceder a
stdinystdoutdesde un script R, lo que significa que puedes usarlo en un pipeline; - gracias a la implementación inteligente de las rutas S3, puede manejar muchos archivos;
- la principal razón de la pérdida de tiempo es la optimización prematura de tu método de almacenamiento;
- no intentes optimizar tareas manualmente, deja que lo haga la computadora;
- la API debe ser simple por razones de simplicidad y flexibilidad de uso;
- si tus datos están bien preparados, ¡el caching será fácil!
Fuente: habr.com
