

En este artículo, hablaré sobre cómo abordamos la cuestión de la alta disponibilidad en PostgreSQL, por qué se volvió importante para nosotros y qué resultado obtuvimos.
Nuestro servicio es de alta carga: 2,5 millones de usuarios en todo el mundo, más de 50,000 usuarios activos cada día. Los servidores están en Amazon en una región de Irlanda: mantendemos constantemente más de 100 servidores diferentes, de los cuales casi 50 están relacionados con bases de datos.
Todo el backend es una gran aplicación monolítica stateful en Java, que mantiene una conexión websocket constante con el cliente. Durante el trabajo simultáneo de varios usuarios en un mismo tablero, todos ven los cambios en tiempo real, porque cada cambio lo registramos en la base de datos. Recibimos aproximadamente 10,000 solicitudes por segundo a nuestras bases de datos. En los picos de carga en Redis, registramos de 80,000 a 100,000 solicitudes por segundo.
Por qué pasamos de Redis a PostgreSQL
Originalmente, nuestro servicio operaba con Redis, un almacén key-value que mantiene todos los datos en la memoria. servidores.
Ventajas de Redis:
- Alta velocidad de respuesta, ya que todo se almacena en memoria;
- Facilidad de respaldo y replicación.
Desventajas de Redis para nosotros:
- No hay transacciones reales. Intentamos imitarlas a nivel de nuestra aplicación. Desafortunadamente, esto no siempre funcionaba bien y requería escribir código muy complicado.
- El volumen de datos está limitado por la cantidad de memoria. A medida que aumenta la cantidad de datos, la memoria crecerá y, en última instancia, nos encontraremos con las características de la instancia seleccionada, lo que en AWS requiere detener nuestro servicio para cambiar el tipo de instancia.
- Es necesario mantener constantemente un nivel bajo de latencia, ya que tenemos un gran número de solicitudes. El nivel de latencia óptimo para nosotros es de 17-20 ms. Con un nivel de 30-40 ms, recibimos respuestas lentas a las solicitudes de nuestra aplicación y degradación del servicio. Desafortunadamente, esto ocurrió en septiembre de 2018, cuando una de las instancias de Redis, por alguna razón, experimentó una latencia el doble de la habitual. Para solucionar el problema, detuvimos el servicio a mitad del día para realizar un mantenimiento no programado y reemplazamos la instancia problemática de Redis.
- Es fácil obtener inconsistencia de datos incluso con errores menores en el código y luego gastar mucho tiempo escribiendo código para corregir esos datos.
Hemos tenido en cuenta los inconvenientes y comprendimos que necesitábamos migrar a algo más conveniente, con transacciones normales y menor dependencia de la latencia. Realizamos una investigación, analizamos numerosas opciones y elegimos PostgreSQL.
Hemos estado migrando a la nueva base de datos durante 1.5 años y solo hemos trasladado una pequeña parte de los datos, por lo que actualmente estamos trabajando simultáneamente con Redis y PostgreSQL. Más información sobre las etapas de la migración y el cambio de datos entre bases de datos se puede encontrar en el artículo de mi colega.
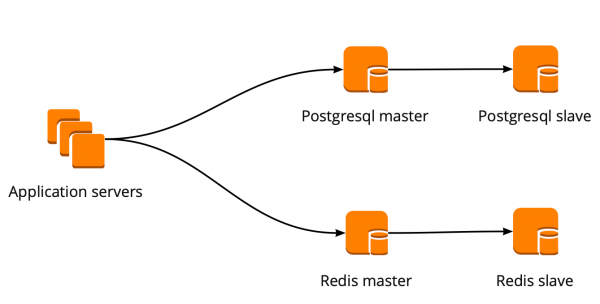
Cuando comenzamos a migrar, nuestra aplicación funcionaba directamente con la base de datos, accediendo al maestro de Redis y PostgreSQL. El clúster de PostgreSQL constaba de un maestro y una réplica con replicación asíncrona. Así es como se veía el esquema de trabajo con las bases de datos:
Implementación de PgBouncer
Mientras migrábamos, el producto también evolucionaba: el número de usuarios y servidores que trabajaban con PostgreSQL estaba aumentando, y comenzamos a quedarnos sin conexiones. PostgreSQL crea un proceso separado para cada conexión y consume recursos. Se puede aumentar el número de conexiones hasta cierto punto, de lo contrario hay riesgo de que la base de datos funcione de manera subóptima. La opción ideal en esa situación será elegir un gestor de conexiones que se sitúe frente a la base de datos.
Teníamos dos opciones para el gestor de conexiones: Pgpool y PgBouncer. Pero el primero no soporta el modo transaccional de trabajo con la base de datos, por lo que elegimos PgBouncer.
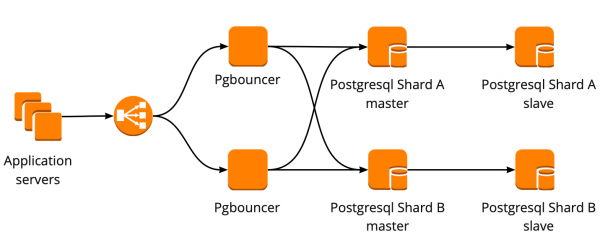
Configuramos el siguiente esquema de trabajo: nuestra aplicación se conecta a un PgBouncer, detrás del cual se encuentran los maestros de PostgreSQL, y detrás de cada maestro hay una réplica con replicación asíncrona.
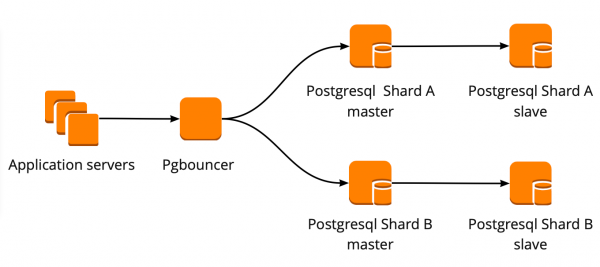
A su vez, no podíamos almacenar todo el volumen de datos en PostgreSQL y para nosotros era importante la velocidad de trabajo con la base de datos, por lo que comenzamos a hacer sharding de PostgreSQL a nivel de aplicación. El esquema descrito anteriormente es relativamente conveniente para esto: al añadir un nuevo shard, solo es necesario actualizar la configuración de PgBouncer y la aplicación puede empezar a trabajar inmediatamente con el nuevo shard.
Tolerancia a fallos de PgBouncer
Este esquema funcionó hasta que la única instancia de PgBouncer falló. Estamos en AWS, donde todas las instancias se ejecutan en hardware que muere periódicamente. En tales casos, la instancia simplemente se traslada a nuevo hardware y vuelve a funcionar. Así ocurrió con PgBouncer, pero se volvió inaccesible. Como resultado de esta caída, nuestro servicio estuvo fuera de servicio durante 25 minutos. AWS recomienda a los usuarios implementar redundancia para estas situaciones, lo que en ese momento no habíamos implementado.
Después de esto, comenzamos a pensar seriamente en la tolerancia a fallos de PgBouncer y de los clústeres de PostgreSQL, porque una situación similar podría repetirse con cualquier instancia en nuestra cuenta de AWS.
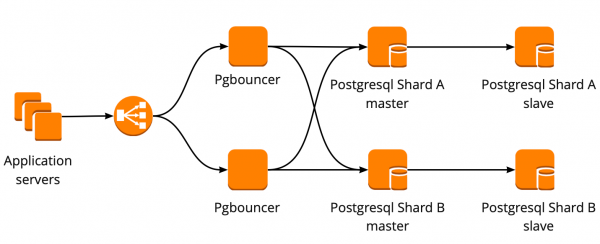
Construimos el esquema de tolerancia a fallos de PgBouncer de la siguiente manera: todos los servidores de la aplicación se conectan a un Network Load Balancer, detrás del cual hay dos PgBouncer. Cada PgBouncer observa los mismos master de PostgreSQL de cada shard. En caso de una caída de la instancia en AWS, todo el tráfico se redirige a través de otro PgBouncer. La tolerancia a fallos del Network Load Balancer es proporcionada por AWS.
Este esquema permite agregar nuevos servidores PgBouncer sin problemas.
Creación de un clúster PostgreSQL tolerante a fallos
Al abordar esta tarea, consideramos varias opciones: failover personalizado, repmgr, AWS RDS, Patroni.
Scripts personalizados
Pueden monitorear el funcionamiento del master y, en caso de que falle, promover la réplica a master y actualizar la configuración de PgBouncer.
Las ventajas de este enfoque radican en su máxima simplicidad, ya que escribes los scripts tú mismo y sabes exactamente cómo funcionan.
Desventajas:
- El master puede no haber caído, en su lugar podría haber ocurrido una falla de red. El failover, sin saberlo, promoverá la réplica a master, y el antiguo master seguirá funcionando. Como resultado, tendremos dos servidores actuando como master y no sabremos en cuál de ellos están los datos más recientes. Esta situación también se llama split-brain;
- Nos quedamos sin réplica. En nuestra configuración, hay un master y una réplica, después del failover la réplica se promueve a master y ya no tenemos más réplicas, por lo que tenemos que agregar manualmente una nueva réplica;
- Se necesita una supervisión adicional del funcionamiento del failover, y tenemos 12 shards de PostgreSQL, lo que significa que debemos monitorear 12 clústeres. Al aumentar el número de shards, también debemos recordar actualizar el failover.
El failover personalizado parece muy complicado y requiere soporte no trivial. Con un solo clúster de PostgreSQL, esta sería la opción más sencilla, pero no es escalable, por lo que no es adecuada para nosotros.
Repmgr
Gestor de Replicación para clústeres de PostgreSQL que puede administrar el funcionamiento del clúster de PostgreSQL. Sin embargo, no cuenta con failover automático “de fábrica”, por lo que será necesario escribir nuestro propio “wrapper” sobre la solución existente. Por lo tanto, puede terminar siendo incluso más complicado que con los scripts personalizados, así que ni siquiera probamos Repmgr.
AWS RDS
Soporta todo lo necesario para nosotros, permite hacer copias de seguridad y soporta un pool de conexiones. Tiene conmutación automática: cuando el maestro falla, la réplica se convierte en el nuevo maestro, y AWS cambia el registro DNS al nuevo maestro, manteniendo las réplicas en diferentes AZ.
Entre las desventajas se puede mencionar la falta de configuraciones finas. Un ejemplo de configuraciones finas: en nuestras instancias hay restricciones para las conexiones TCP, lo cual, desafortunadamente, no se puede hacer en RDS:
net.ipv4.tcp_keepalive_time=10
net.ipv4.tcp_keepalive_intvl=1
net.ipv4.tcp_keepalive_probes=5
net.ipv4.tcp_retries2=3
Además, el precio de AWS RDS es casi el doble del precio habitual de la instancia, que fue la principal razón para rechazar esta solución.
Patroni
Este es un template en Python para gestionar PostgreSQL con buena documentación, failover automático y código fuente en github.
Ventajas de Patroni:
- Cada parámetro de configuración está detallado, es claro cómo funciona cada cosa;
- El failover automático funciona de fábrica;
- Está escrito en Python, y como nosotros también escribimos mucho en Python, nos será más fácil lidiar con problemas y, posiblemente, incluso ayudar en el desarrollo del proyecto;
- Administra completamente PostgreSQL, permite cambiar la configuración de inmediato en todos los nodos del clúster y, si para aplicar una nueva configuración se requiere reiniciar el clúster, esto también se puede hacer con Patroni.
Desventajas:
- La documentación no es clara sobre cómo trabajar correctamente con PgBouncer. Aunque esto no se puede considerar un inconveniente, ya que la tarea de Patroni es gestionar PostgreSQL, y cómo se gestionen las conexiones a Patroni ya es nuestro problema;
- Hay pocos ejemplos de implementación de Patroni en grandes volúmenes, pero hay muchos ejemplos de implementación desde cero.
Al final, para crear un clúster resistente a fallos, elegimos precisamente Patroni.
El proceso de implementación de Patroni
Antes de Patroni, teníamos 12 shards de PostgreSQL con una configuración de un maestro y una réplica con replicación asíncrona. Los servidores de aplicaciones se conectaban a las bases de datos a través de un Network Load Balancer, detrás del cual había dos instancias de PgBouncer, y detrás de ellas estaban todos los servidores PostgreSQL.
Para implementar Patroni, necesitábamos seleccionar un almacén de configuración distribuido para el clúster. Patroni trabaja con sistemas de almacenamiento de configuraciones distribuidos, como etcd, Zookeeper y Consul. En producción, tenemos un clúster completo de Consul que funciona en conjunto con Vault y no lo utilizamos de ninguna otra manera. Es una excelente oportunidad para comenzar a utilizar Consul para su propósito.
Cómo funciona Patroni con Consul
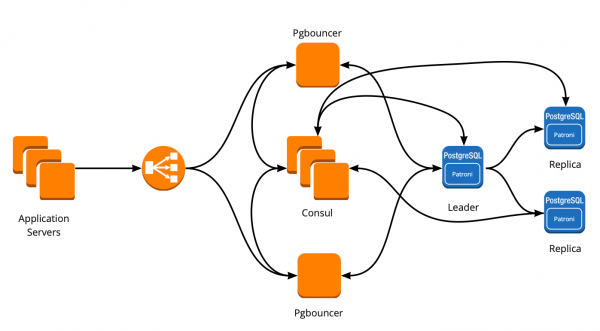
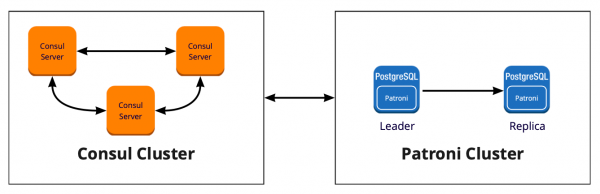
Tenemos un clúster de Consul que consta de tres nodos y un clúster de Patroni que está compuesto por un líder y una réplica (en Patroni, el maestro se llama líder del clúster y los esclavos son réplicas). Cada instancia del clúster Patroni envía constantemente información sobre el estado del clúster a Consul. Por lo tanto, siempre se puede conocer la configuración actual del clúster de Patroni y quién es el líder en ese momento desde Consul.
Para conectar Patroni a Consul, basta con consultar la documentación oficial, donde se indica que es necesario especificar el host en formato http o https, dependiendo de cómo trabajamos con Consul, y opcionalmente el esquema de conexión:
host: el host:puerto para el punto final de Consul, en formato: http(s)://host:puerto
scheme: (opcional) http o https, por defecto es http
Parece simple, pero aquí comienzan los problemas ocultos. Trabajamos con Consul a través de una conexión segura a través de https, y nuestra configuración de conexión se verá de la siguiente manera:
consul:
  host: https://server.production.consul:8080
  verify: true
  cacert: {{ consul_cacert }}
  cert: {{ consul_cert }}
  key: {{ consul_key }}
Pero así no funciona. Al iniciar Patroni, no puede conectarse a Consul porque intenta hacer la conexión por http de todos modos.
Resolver el problema ayudó el código fuente de Patroni. Afortunadamente, está escrito en Python. Resulta que el parámetro host no se analiza de ninguna manera, y es necesario especificar el protocolo en el esquema. Así es como se ve el bloque de configuración funcional para trabajar con Consul en nuestra implementación:
consul:
  host: server.production.consul:8080
  scheme: https
  verify: true
  cacert: {{ consul_cacert }}
  cert: {{ consul_cert }}
  key: {{ consul_key }}
Consul-template
Así que hemos elegido el almacenamiento para la configuración. Ahora necesitamos entender cómo PgBouncer cambiará su configuración al cambiar de líder en el clúster de Patroni. La documentación no ofrece respuesta a esta pregunta, ya que no describe en principio el funcionamiento con PgBouncer.
En busca de una solución, encontramos un artículo (lamentablemente no recuerdo el nombre), donde se decía que Consul-template ayudó mucho en la integración de PgBouncer y Patroni. Esto nos impulsó a investigar el funcionamiento de Consul-template.
Resultó que Consul-template monitorea constantemente la configuración del clúster PostgreSQL en Consul. Al cambiar de líder, actualiza la configuración de PgBouncer y envía un comando para su reinicio.
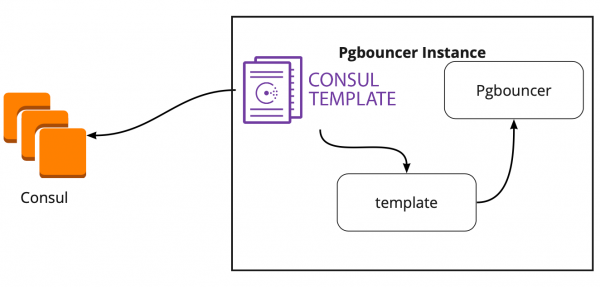
Una gran ventaja del template es que se almacena en forma de código, por lo que al añadir un nuevo shard, basta con hacer un nuevo commit y actualizar el template automáticamente, manteniendo el principio de Infraestructura como código.
Nueva arquitectura con Patroni
Como resultado, obtuvimos el siguiente esquema de trabajo:
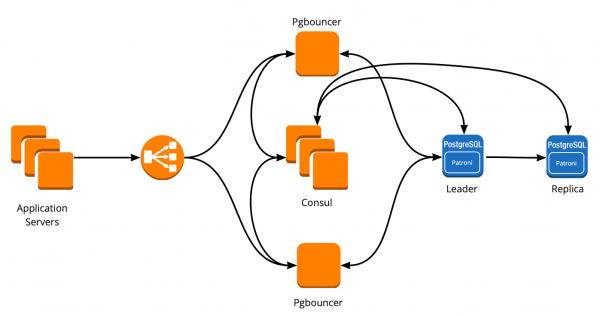
Todos los servidores de aplicaciones se dirigen al balanceador → detrás de él hay dos instancias de PgBouncer → en cada instancia se ejecuta Consul-template, que monitoriza el estado de cada clúster de Patroni y mantiene actualizada la configuración de PgBouncer, que dirige las solicitudes al actual líder de cada clúster.
Pruebas manuales
Antes de poner este esquema en producción, lo probamos en un pequeño entorno de pruebas y verificamos el funcionamiento del cambio automático. Abrimos un tablero, movimos un sticker y en ese momento 'eliminamos' al líder del clúster. En AWS, esto es suficiente con apagar la instancia a través de la consola.
El sticker regresó en 10-20 segundos, y luego comenzó a moverse normalmente nuevamente. Esto significa que el clúster de Patroni funcionó correctamente: cambió de líder, envió la información a Consul, y Consul-template captó de inmediato esta información, reemplazó la configuración de PgBouncer y envió el comando para recargar.
¿Cómo sobrevivir a una alta carga y mantener un tiempo de inactividad mínimo?
¡Todo funciona perfectamente! Pero surgen nuevas preguntas: ¿Cómo funcionará esto bajo alta carga? ¿Cómo desplegar todo en producción de manera rápida y segura?
Responder la primera pregunta nos ayuda un entorno de prueba, en el que realizamos pruebas de carga. Es completamente idéntico a production en arquitectura y tiene datos de prueba generados, que en volumen son aproximadamente equivalentes a production. Simplemente decidimos "matar" uno de los maestros de PostgreSQL durante la prueba y ver qué sucede. Pero antes de esto es importante verificar el despliegue automático, ya que en este entorno tenemos varios shards de PostgreSQL, así que obtendremos un excelente test de los scripts de configuración antes de la producción.
Ambas tareas parecen ambiciosas, pero tenemos PostgreSQL 9.6. ¿Quizás deberíamos actualizar directamente a 11.2?
Decidimos hacer esto en 2 etapas: primero actualizar la versión a 11.2, luego iniciar Patroni.
Actualización de PostgreSQL
Para una actualización rápida de la versión de PostgreSQL es necesario utilizar la opción -k, que crea enlaces duros en el disco y no requiere la copia de sus datos. En bases de datos de 300-400 GB, la actualización toma 1 segundo.
Tenemos muchos shards, por lo que la actualización debe hacerse de forma automática. Para ello, hemos escrito un playbook de Ansible que lleva a cabo todo el proceso de actualización por nosotros:
/usr/lib/postgresql/11/bin/pg_upgrade
<b>--enlace </b>
--old-datadir='' --new-datadir=''
 --old-bindir=''  --new-bindir=''
 --old-options=' -c config_file='
 --new-options=' -c config_file='
Aquí es importante señalar que antes de iniciar la actualización es necesario realizarla con el parámetro —check, para asegurarse de que la actualización sea posible. Además, nuestro script realiza el intercambio de configuraciones durante la actualización. Nuestro script tardó 30 segundos en ejecutarse, lo cual es un gran resultado.
Iniciar Patroni
Para resolver el segundo problema, es suficiente mirar la configuración de Patroni. En el repositorio oficial hay un ejemplo de configuración con initdb, que se encarga de inicializar una nueva base de datos en el primer lanzamiento de Patroni. Pero dado que ya tenemos una base de datos lista, simplemente eliminamos esta sección de la configuración.
Cuando comenzamos a instalar Patroni en un clúster de PostgreSQL ya preparado y a ejecutarlo, nos encontramos con un nuevo problema: ambos servidores se iniciaban como líderes. Patroni no tiene conocimiento del estado previo del clúster y intenta iniciar ambos servidores como dos clústeres separados con el mismo nombre. Para resolver este problema, es necesario eliminar el directorio de datos en el esclavo:
rm -rf /var/lib/postgresql/¡Esto solo se debe hacer en el esclavo!
Al conectar una réplica limpia, Patroni hace un basebackup del líder y lo restaura en la réplica, y luego alcanza el estado actual a través de los registros wal.
Otra dificultad que encontramos es que todos los clústeres de PostgreSQL se llaman main por defecto. Esto es normal cuando cada clúster no sabe nada sobre los demás. Pero cuando deseas utilizar Patroni, todos los clústeres deben tener un nombre único. La solución es cambiar el nombre del clúster en la configuración de PostgreSQL.
Prueba de carga
Realizamos una prueba que simula la actividad de los usuarios en los tableros. Cuando la carga alcanzó nuestro promedio diario, repetimos exactamente la misma prueba, apagamos una instancia con el líder de PostgreSQL. El failover automático funcionó como esperábamos: Patroni cambió al líder, Consul-template actualizó la configuración de PgBouncer y envió el comando para recargar. En nuestros gráficos de Grafana, se podían ver retrasos de 20 a 30 segundos y un pequeño número de errores de servidores relacionados con la conexión a la base. Esta es una situación normal, estos valores son aceptables para nuestro failover y definitivamente son mejores que el tiempo de inactividad del servicio.
Salida de Patroni en producción
Al final, obtuvimos el siguiente plan:
- Despliegue de Consul-template en los servidores PgBouncer y puesta en marcha;
- Actualización de PostgreSQL a la versión 11.2;
- Cambio del nombre del clúster;
- Inicio del clúster de Patroni.
Nuestra esquema permite realizar el primer punto prácticamente en cualquier momento; podemos quitar cada PgBouncer uno por uno de la operación y realizar el despliegue y el inicio de consul-template. Así lo hicimos.
Para una rápida implementación, utilizamos Ansible, ya que habíamos verificado todos los playbooks en un entorno de prueba, y el tiempo de ejecución completo del escenario fue de 1,5 a 2 minutos para cada shard. Podíamos implementar todo de manera secuencial en cada shard sin detener nuestro servicio, pero tendríamos que apagar cada PostgreSQL durante unos minutos. En este caso, los usuarios cuyos datos están en ese shard no podrían trabajar plenamente durante ese tiempo, lo cual es inaceptable para nosotros.
La solución a esta situación fue un mantenimiento programado, que realizamos cada 3 meses. Esta es una ventana para trabajos planificados, cuando apagamos completamente nuestro servicio y actualizamos las instancias de base de datos. Quedaba una semana para la próxima ventana, y decidimos simplemente esperar y prepararnos mejor. Durante el tiempo de espera, tomamos precauciones adicionales: para cada shard de PostgreSQL levantamos una réplica de respaldo en caso de fallos, para conservar los datos más recientes, y añadimos una nueva instancia para cada shard, que debería convertirse en una nueva réplica en el clúster Patroni, para no tener que ejecutar el comando de eliminación de datos. Todo esto ayudó a minimizar el riesgo de error.
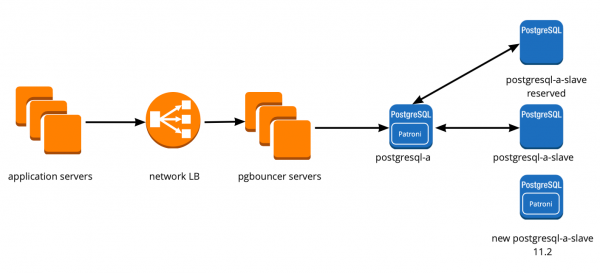
Reiniciamos nuestro servicio, todo funcionó como debía, los usuarios continuaron trabajando, pero en los gráficos notamos una carga anormalmente alta en los servidores de Consul.
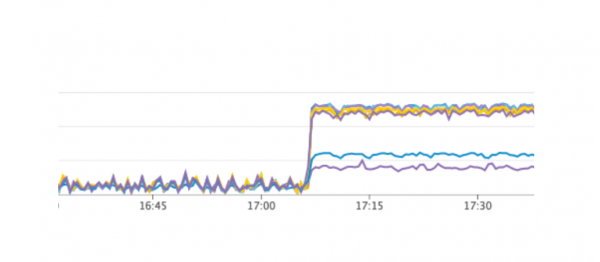
¿Por qué no vimos esto en el entorno de prueba? Este problema ilustra muy bien que debemos seguir el principio de Infraestructura como código y desarrollar toda la infraestructura, comenzando desde los entornos de prueba y terminando en producción. De lo contrario, es muy fácil enfrentarse a un problema como el que tuvimos. ¿Qué ocurrió? Consul apareció primero en producción y luego en los entornos de prueba; como resultado, en los entornos de prueba la versión de Consul era más alta que en producción. Precisamente en una de las versiones se solucionó una fuga de CPU al trabajar con consul-template. Por lo tanto, simplemente actualizamos Consul, resolviendo así el problema.
Reiniciar el clúster Patroni
Sin embargo, nos encontramos con un nuevo problema, del que ni siquiera sospechábamos. Al actualizar Consul, simplemente eliminamos el nodo de Consul del clúster usando el comando consul leave → Patroni se conecta a otro servidor de Consul → todo funciona. Pero cuando llegamos a la última instancia del clúster de Consul y le enviamos el comando consul leave, todos los clústeres de Patroni simplemente se reiniciaron, y en los registros vimos el siguiente error:
ERROR: get_cluster
Traceback (última llamada más reciente):
...
RetryFailedError: 'Se superó el plazo de reintento'
ERROR: Error al comunicarse con DCS
<b>LOG: el sistema de base de datos está apagado</b>
El clúster de Patroni no pudo obtener información sobre su clúster y se reinició.
Para buscar una solución, nos dirigimos a los creadores de Patroni a través de un issue en GitHub. Ellos propusieron mejoras a nuestros archivos de configuración:
consul:
 consul.checks: []
bootstrap:
 dcs:
   retry_timeout: 8
Pudimos reproducir el problema en el entorno de prueba y probamos esos parámetros allí, pero, desafortunadamente, no funcionaron.
El problema sigue sin resolverse. Planeamos probar las siguientes opciones de solución:
- Usar el agente Consul en cada instancia del clúster Patroni;
- Corregir el problema en el código.
Entendemos el origen del error: probablemente la problemática se encuentra en el uso del timeout por defecto, que no se reconfigura a través del archivo de configuración. Al eliminar el último servidor Consul del clúster, todo el clúster de Consul se congela por más de un segundo, lo que impide que Patroni obtenga el estado del clúster y reinicia completamente todo el clúster.
Afortunadamente, no hemos encontrado más errores.
Conclusiones sobre el uso de Patroni
Después de iniciar con éxito Patroni, agregamos una réplica adicional en cada clúster. Ahora en cada clúster hay una especie de quórum: un líder y dos réplicas, para asegurar en caso de un split-brain durante el cambio.
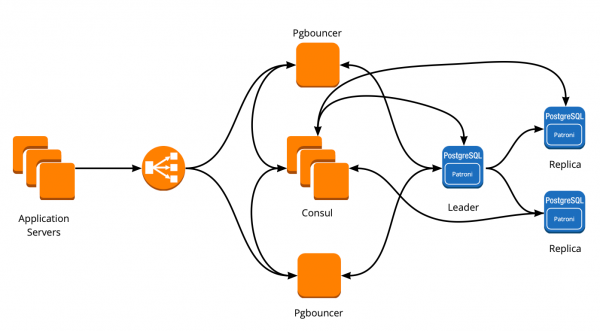
Patroni ha estado funcionando en producción durante más de tres meses. En este tiempo, ya nos ha salvado. Recientemente, el líder de uno de los clústeres en AWS falló, se activó el failover automático y los usuarios continuaron trabajando. Patroni cumplió su tarea principal.
Un pequeño resumen sobre el uso de Patroni:
- Facilidad para cambiar la configuración. Basta con modificar la configuración en una instancia y se aplicará a todo el clúster. Si se requiere un reinicio para aplicar la nueva configuración, Patroni lo notificará. Patroni puede reiniciar todo el clúster con un solo comando, lo que también es muy conveniente.
- El failover automático funciona y ya nos ha salvado.
- Actualización de PostgreSQL sin tiempo de inactividad para la aplicación. Primero hay que actualizar las réplicas a la nueva versión, luego cambiar el líder en el clúster de Patroni y actualizar al antiguo líder. En este proceso se realiza la prueba necesaria de failover automático.
Fuente: habr.com
