

Introducción
Ha llegado el momento de comprar un sistema de almacenamiento. ¿Cuál elegir y a quién escuchar? El proveedor A habla sobre el proveedor B, y también está el integrador C, que dice lo contrario y recomienda al proveedor D. En esta situación, incluso un arquitecto experimentado en sistemas de almacenamiento puede sentirse abrumado, especialmente con todos los nuevos proveedores y las tendencias actuales como SDS y la hiperconvergencia.
Entonces, ¿cómo se puede entender todo esto y no quedar en ridículo? Nosotros ( Antón Zhbankov y Evgeny Elizarov) intentaremos explicarlo en un lenguaje claro para los rusos.
El artículo está en gran medida interconectado y, de hecho, es una extensión del “” en cuanto a la selección de sistemas de almacenamiento de datos y revisión de tecnologías de almacenamiento. Revisaremos brevemente la teoría general, pero recomendamos también leer el artículo mencionado.
¿Por qué?
A menudo se observa la situación en la que una nueva persona llega a un foro o a un chat especializado, como Storage Discussions, y pregunta: “me están ofreciendo dos opciones de sistema de almacenamiento: ABC SuperStorage S600 y XYZ HyperOcean 666v4, ¿qué me aconsejan?”
Y comienza la comparación de las características de implementación de peculiaridades extrañas y confusas que para una persona no preparada son completamente incomprensibles.
Así que, la pregunta clave y más importante que debes hacerte mucho antes de comparar especificaciones en las propuestas comerciales es — ¿PARA QUÉ? ¿Para qué necesitas este sistema de almacenamiento?
La respuesta será inesperada, y muy al estilo de Tony Robbins — para almacenar datos. ¡Gracias, Capitán! Y aun así, a veces nos adentramos tanto en la comparación de detalles que olvidamos por qué estamos haciendo todo esto.
Así que, la tarea de un sistema de almacenamiento de datos es almacenar y proporcionar acceso a los DATOS con un rendimiento específico. Partiremos de los datos.
Datos
Tipo de datos
¿Qué datos planeamos almacenar? Es una pregunta muy importante que puede descartar muchas soluciones de almacenamiento incluso de consideración. Por ejemplo, si se planea almacenar grabaciones de video y fotografías. Se pueden eliminar inmediatamente los sistemas diseñados para acceso aleatorio de bloques pequeños, o aquellos con características propietarias en compresión / deduplicación. Pueden ser sistemas excelentes, no queremos decir nada malo al respecto. Pero en este caso, sus fortalezas pueden convertirse, por el contrario, en debilidades (el video y las fotos no se comprimen) o simplemente aumentarán significativamente el costo del sistema.
Y, por el contrario, si el uso previsto es una base de datos transaccional pesada, entonces los excelentes sistemas de streaming de multimedia, capaces de entregar gigabytes por segundo, serán una mala elección.
Volumen de datos
¿Cuántos datos planeamos almacenar? La cantidad siempre se convierte en calidad, no hay que olvidar eso nunca, especialmente en nuestra época de crecimiento exponencial del volumen de datos. Los sistemas de clase petabyte ya no son raros, pero cuanto mayor es el volumen de petabytes, más específica se convierte la solución, y menos funcionalidad habitual de sistemas de acceso aleatorio de pequeño y mediano volumen estará disponible. Sencillamente porque, solo las tablas de estadísticas de acceso por bloques superan la memoria RAM disponible en los controladores. Sin contar la compresión / tiraje. Supongamos que queremos cambiar el algoritmo de compresión por uno más potente y comprimir 20 petabytes de datos. ¿Cuánto tiempo tomará: seis meses, un año?
Por otro lado, ¿por qué complicarse la vida si solo hay que almacenar y procesar 500 GB de datos? Solo 500. Los SSD domésticos (con bajo DWPD) de ese tamaño son muy económicos. ¿Para qué construir una fábrica de Fiber Channel y comprar un sistema de almacenamiento externo de clase alta que cuesta un ojo de la cara?
¿Qué porcentaje del volumen total son datos calientes? ¿Qué tan desigual es la carga en el volumen de datos? Aquí es donde la tecnología de almacenamiento en varias capas o Flash Cache puede ser de gran ayuda si el volumen de datos calientes es mísero en comparación con el total. Por el contrario, en caso de que haya una carga uniforme en todo el volumen, común en sistemas de transmisión (videovigilancia, algunos sistemas de análisis), estas tecnologías no aportarán nada y solo aumentarán el costo / complejidad del sistema.
IS
El reverso de los datos es el sistema de información que utiliza esos datos. La IS tiene un conjunto de requisitos que heredan los datos. Para más detalles sobre la IS, ver "Diseño de un centro de datos virtualizado."
Requisitos de tolerancia a fallos / disponibilidad
Los requisitos de tolerancia a fallos / disponibilidad de los datos se heredan del sistema de información que los utiliza y se expresan en tres cifras — RPO, RTO, de diferentes versiones del mismo paquete. A diferencia de las Software Collections, la instalación simultánea.
Disponibilidad — la parte durante un período determinado de tiempo en el que los datos están disponibles para trabajar con ellos. Se expresa generalmente en cantidad de 9. Por ejemplo, dos nueves al año significa que la disponibilidad es del 99%, o de otra manera se permite hasta 95 horas de inactividad al año. Tres nueves — 9,5 horas al año.
RPO / RTO — son índices no acumulativos, sino por cada incidente (falla), a diferencia de la disponibilidad.
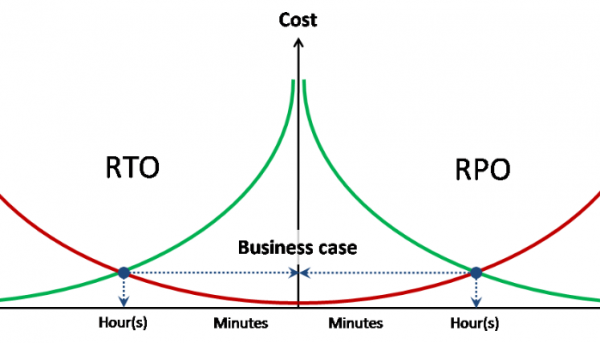
RPO — volumen de datos perdidos en caso de un accidente (en horas). Por ejemplo, si se realiza una copia de seguridad una vez al día, entonces RPO = 24 horas. Es decir, en caso de un accidente y pérdida total del almacenamiento, se pueden perder datos por un volumen de hasta 24 horas (desde la última copia de seguridad). Basado en el RPO establecido para la IS, por ejemplo, se elabora la normativa de copias de seguridad. También, basado en el RPO, se puede entender cuán necesaria es la replicación de datos sincrónica / asincrónica.
RTO — tiempo de recuperación del servicio (acceso a los datos) después de un accidente. Basado en el valor establecido de RTO, podemos entender si se necesita un metroclúster o si es suficiente una replicación unidireccional. También es necesario saber si se requiere un almacenamiento de clase alta multi-controlador.
Requisitos de rendimiento
A pesar de que esta es una question bastante obvia, es precisamente con ella que más se presentan dificultades. Dependiendo de si ya tiene alguna infraestructura o no, y se construirán rutas para recopilar las estadísticas necesarias.
Ya tiene un sistema de almacenamiento y está buscando un reemplazo o desea adquirir uno más para expandirse. Aquí es sencillo. Usted entiende qué servicios ya tiene y cuáles planea incorporar en el futuro cercano. Basándose en los servicios actuales, puede recopilar estadísticas sobre el rendimiento. Determinar la cantidad actual de IOPS y las latencias existentes: ¿cuáles son esas cifras y son suficientes para sus tareas? Esto se puede hacer tanto en el propio sistema de almacenamiento como desde los hosts que están conectados a él.
Además, es importante no solo observar la carga actual, sino también durante un cierto periodo (mejor un mes). Ver cuáles son los picos máximos durante el día, qué carga genera la copia de seguridad, etc. Si su sistema de almacenamiento o su software no le proporciona un conjunto completo de estos datos, puede utilizar la herramienta gratuita RRDtool, que puede trabajar con la mayoría de los sistemas de almacenamiento y conmutadores más populares y podrá proporcionarle estadísticas detalladas sobre el rendimiento. También es recomendable observar la carga en los hosts que trabajan con este sistema de almacenamiento, en máquinas virtuales específicas o lo que está funcionando en este host.
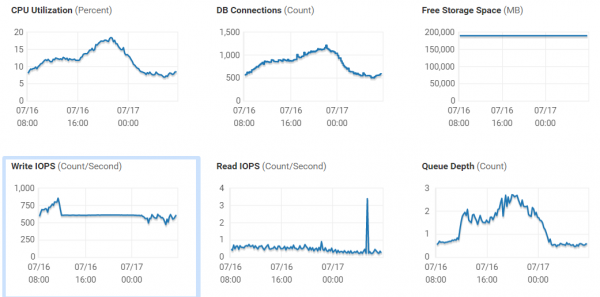
Cabe destacar que si hay diferencias significativas entre las latencias en el volumen y el datastore que se encuentra en este volumen, debe prestar atención a su red SAN; hay una alta probabilidad de que existan problemas y, antes de adquirir un nuevo sistema, es importante abordar esta cuestión, ya que hay una gran posibilidad de que aumente el rendimiento del sistema actual.
Usted está construyendo una infraestructura desde cero, o adquiriendo un sistema para algún nuevo servicio del cual no tiene información sobre las cargas. Aquí hay varias opciones: comunicarse con colegas en recursos especializados para intentar obtener y pronosticar la carga, acudir a un integrador que tenga experiencia en la implementación de tales servicios y que pueda calcular la carga por usted. Y la tercera opción (generalmente la más complicada, especialmente si se trata de aplicaciones personalizadas o poco comunes) es intentar averiguar los requisitos de rendimiento con los desarrolladores del sistema.
Y, la atención, la opción más adecuada desde el punto de vista práctico es un piloto en el equipo actual, o en el equipo proporcionado para pruebas por el vendedor / integrador.
Requisitos especiales
Los requisitos especiales son todo aquello que no se incluye en los requisitos de rendimiento, resistencia a fallos y funcionalidad para el procesamiento y suministro directo de datos.
Uno de los requisitos especiales más simples para un sistema de almacenamiento de datos es "medios de información transferibles". Y es evidente que este sistema de almacenamiento de datos debe incluir una biblioteca de cintas o simplemente un streamer, donde se realiza la copia de seguridad. Después, una persona especialmente capacitada firma la cinta y la lleva con orgullo a una caja fuerte especial.
Otro ejemplo de un requisito especial es una ejecución resistente a impactos.
Donde
El segundo elemento clave en la elección de un sistema de almacenamiento de datos es la información sobre DÓNDE se ubicará este sistema de almacenamiento. Desde la geografía o las condiciones climáticas, hasta el personal.
Cliente
¿Para quién se planea este sistema de almacenamiento de datos? La pregunta tiene las siguientes bases:
Cliente gubernamental / comercial.
El cliente comercial no tiene restricciones y no está obligado a realizar licitaciones, salvo por sus propios reglamentos internos.
El cliente gubernamental es un asunto diferente. La Ley 44-FZ y otras complejidades con las licitaciones y los Pliegos de Condiciones que pueden ser impugnados.
Cliente bajo sanciones
Aquí la cuestión es muy simple: la elección se limita solo a las propuestas disponibles para este cliente.
Reglamentos internos / proveedores autorizados para compra / modelos
La cuestión también es bastante simple, pero hay que recordarla.
Dónde físicamente
En esta parte abordamos todas las cuestiones relacionadas con la geografía, los canales de comunicación y el microclima en el lugar de ubicación.
Personal
¿Quién trabajará con este sistema de almacenamiento de datos? Esto es tan importante como lo que el sistema de almacenamiento sabe hacer.
Por muy prometedor, impresionante y excelente que sea el sistema de almacenamiento del vendedor A, no tiene mucho sentido implementarlo si el personal solo sabe trabajar con el vendedor B, y no hay planes para futuras compras ni colaboración continua con A.
Y, por supuesto, el reverso de la cuestión es qué tan disponible está el personal capacitado en la ubicación geográfica específica, tanto en la empresa como potencialmente en el mercado laboral. Para las regiones, puede tener un significado considerable la elección de un sistema de almacenamiento con interfaces sencillas o la posibilidad de gestión centralizada remota. De lo contrario, en algún momento puede volverse insoportablemente doloroso. Internet está lleno de historias de cómo un nuevo empleado, un estudiante de ayer, configuró algo que hizo colapsar toda la empresa.
Entorno
Y, por supuesto, hay una pregunta igualmente importante: ¿en qué entorno estará trabajando este sistema de almacenamiento?
- ¿Qué pasa con la alimentación / refrigeración?
- ¿Qué tipo de conexión?
- ¿Dónde se montará?
- Y así sucesivamente.
A menudo, estas preguntas se consideran evidentes y no se discuten en profundidad, pero a veces son precisamente estas cuestiones las que pueden cambiar todo radicalmente.
¿Qué?
Proveedor
Hasta hoy (mediados de 2019), el mercado ruso de sistemas de almacenamiento se puede dividir en cinco categorías condicionales:
- División superior: compañías reconocidas con una amplia gama de opciones, desde los sistemas de almacenamiento más simples hasta los de gama alta (HPE, DellEMC, Hitachi, NetApp, IBM / Lenovo).
- División inferior: compañías con una línea limitada, jugadores de nicho, serios proveedores de SDS o nuevos entrantes en auge (Fujitsu, Datacore, Infinidat, Huawei, Pure, etc.).
- Tercera división: soluciones de nicho de gama baja, SDS económicos, productos improvisados basados en ceph y otros proyectos abiertos (Infortrend, Starwind, etc.).
- Segmento SOHO: sistemas de almacenamiento pequeños y muy pequeños para el hogar / oficina pequeña (Synology, QNAP, etc.).
- Sistemas de almacenamiento importados: aquí se incluyen tanto hardware de la primera división con etiquetas reetiquetadas, como raros representantes de la segunda (RAIDIX, les daremos un voto a favor de la segunda), pero principalmente es la tercera división (Aerodisk, Baum, Depo, etc.).
La división es bastante condicional y no significa en absoluto que la tercera o el segmento SOHO sean de mala calidad y no se puedan utilizar. En proyectos específicos con un conjunto de datos claramente definido y un perfil de carga, pueden desempeñarse muy bien, superando ampliamente la relación calidad/precio de la primera división. Es importante primero definir las tareas, las perspectivas de crecimiento y la funcionalidad requerida; y entonces Synology le servirá fielmente, haciendo que su cabello sea suave y sedoso.
Uno de los factores importantes al elegir un proveedor es el entorno actual. Cuántos y qué tipos de sistemas de almacenamiento ya tiene, con qué sistemas pueden trabajar los ingenieros. ¿Necesita otro proveedor, otro punto de contacto, va a migrar gradualmente toda la carga del proveedor A al proveedor B?
No se deben crear entidades más allá de lo necesario.
iSCSI / FC / Archivo
No existe un consenso entre los ingenieros sobre los protocolos de acceso, y las disputas se asemejan más a discusiones teológicas que a debates técnicos. Pero en general se pueden destacar los siguientes puntos:
FCoE está más muerto que vivo.
FC vs iSCSI. Una de las ventajas clave de FC en 2019 frente a los sistemas de almacenamiento IP, que es una fábrica dedicada para el acceso a los datos, se ve contrarrestada por una red IP dedicada. No hay ventajas globales de FC sobre las redes IP, y en IP se pueden construir sistemas de almacenamiento de cualquier nivel de carga, incluso sistemas para bases de datos pesadas para una ABC de un gran banco. Por otro lado, la muerte de FC se predice desde hace varios años, pero algo siempre se interpone. Hoy en día, por ejemplo, algunos actores en el mercado de sistemas de almacenamiento están desarrollando activamente el estándar NVMeoF. Si este dividirá la suerte de FCoE, el tiempo lo dirá.
Acceso a archivos tampoco es algo que merezca ser ignorado. NFS / CIFS se desempeñan perfectamente en entornos productivos y, con un diseño correcto, tienen tan pocas quejas como los protocolos de bloque.
Híbrido / All Flash Array
Los sistemas de almacenamiento clásicos se dividen en 2 tipos:
- AFA (All Flash Array) — sistemas optimizados para el uso de SSD.
- Híbridos — que permiten usar tanto HDD como SSD o una combinación de ambos.
Su principal diferencia radica en las tecnologías de eficiencia de almacenamiento que soportan y el nivel máximo de rendimiento (altos IOPS y bajas latencias). Ambos sistemas (en la mayoría de sus modelos, excluyendo el segmento de gama baja) pueden funcionar como dispositivos de bloques o de archivos. El nivel del sistema determina la funcionalidad soportada, y en los modelos más básicos, esta a menudo está reducida al nivel mínimo. Esto es algo a tener en cuenta al investigar las características de un modelo específico, en lugar de simplemente las capacidades de toda la gama en su conjunto. Además, por supuesto, el nivel del sistema afecta a sus características técnicas, como el procesador, la cantidad de memoria, el caché, la cantidad y los tipos de puertos, etc. Desde la perspectiva de gestión, las AFA se diferencian de los sistemas híbridos (de disco) solo en lo que respecta a la implementación de mecanismos de trabajo con unidades de estado sólido; incluso si utiliza SSD en un sistema híbrido, no significa que podrá obtener un nivel de rendimiento comparable al de un sistema AFA. Además, en la mayoría de los casos, los mecanismos inline de almacenamiento eficiente en sistemas híbridos están desactivados, y activarlos resulta en una pérdida de rendimiento.
Almacenamiento de Datos Especializados
Además de los sistemas de almacenamiento de datos de propósito general, orientados principalmente al procesamiento en tiempo real, existen sistemas de almacenamiento especializados con principios clave que difieren fundamentalmente de los habituales (baja latencia, alto IOPS):
Medios.
Estos sistemas están diseñados para almacenar y procesar archivos multimedia, que se caracterizan por su gran tamaño. Por lo tanto, la latencia se vuelve prácticamente irrelevante, y la capacidad de enviar y recibir datos a gran ancho de banda en múltiples flujos paralelos se vuelve primordial.
Sistemas de Almacenamiento Deduplícate para Copias de Seguridad.
Dado que las copias de seguridad suelen diferir poco entre sí en condiciones normales (una copia de seguridad promedio difiere de la de ayer en un 1-2%), esta clase de sistemas empaqueta de manera extremadamente eficiente los datos almacenados en un número relativamente pequeño de medios físicos. Por ejemplo, en ciertos casos, los ratios de compresión de datos pueden alcanzar hasta 200 a 1.
Sistemas de Almacenamiento de Objetos.
En estos sistemas de almacenamiento, no hay volúmenes de acceso bloqueado o comparticiones de archivos como es habitual, sino que más bien se parecen a una enorme base de datos. El acceso a un objeto almacenado en un sistema así se lleva a cabo mediante un identificador único o mediante metadatos (por ejemplo, todos los objetos en formato JPEG con fecha de creación entre XX-XX-XXXX y YY-YY-YYYY).
Sistema de cumplimiento.
Hoy en día no son muy comunes en Rusia, pero vale la pena mencionarlos. El propósito de estos sistemas de almacenamiento es garantizar el almacenamiento de datos para cumplir con las políticas de seguridad o los requisitos regulatorios. En algunos sistemas (por ejemplo, EMC Centera) se implementó una función de prohibición de la eliminación de datos; una vez que se gira la llave y el sistema entra en este modo, ni el administrador ni nadie más puede eliminar físicamente los datos ya grabados.
Tecnologías patentadas
Cache Flash
Cache Flash es el término general para todas las tecnologías patentadas que utilizan memoria flash como caché de segundo nivel. Al utilizar el caché flash, los sistemas de almacenamiento generalmente están diseñados para satisfacer la carga estable de discos magnéticos, mientras que la carga máxima es manejada por el caché.
Es necesario comprender el perfil de carga y el grado de localización de los accesos a los bloques de los volúmenes de almacenamiento. Flash Cache es una tecnología para cargas con alta localización de solicitudes y prácticamente no es aplicable para volúmenes cargados uniformemente (como sucede en sistemas analíticos).
En el mercado están disponibles dos implementaciones de caché flash:
- Solo lectura. En este caso, solo se almacenan en caché los datos de lectura, y la escritura se realiza directamente en los discos. Algunos fabricantes, como NetApp, consideran que la escritura en sus sistemas de almacenamiento ya se realiza de manera óptima, y que el caché no ayuda en absoluto.
- Lectura y escritura. No solo se almacena en caché la lectura, sino también la escritura, lo que permite bufferizar el flujo y reducir el impacto de la penalización RAID, aumentando así el rendimiento general para sistemas de almacenamiento con un mecanismo de escritura no tan óptimo.
Tiering
El almacenamiento en múltiples niveles (tiering) es una tecnología que combina en un único grupo de discos niveles de rendimiento diverso, como SSD y HDD. En caso de una clara desigualdad en el acceso a bloques de datos, el sistema podrá equilibrar automáticamente los bloques de datos, trasladando los sobrecargados a un nivel de alto rendimiento, y los fríos, por el contrario, a un nivel más lento.
Los sistemas híbridos de gama baja y media utilizan almacenamiento jerárquico con movimiento de datos entre niveles según un horario. En este caso, el tamaño del bloque de almacenamiento jerárquico en los mejores modelos es de 256 MB. Estas características no permiten considerar la tecnología de almacenamiento jerárquico como una tecnología de aumento de rendimiento, como erróneamente piensan muchos. El almacenamiento jerárquico en sistemas de gama baja y media es una tecnología de optimización de costos de almacenamiento para sistemas con una notable desigualdad de carga.
Instantánea
Por más que hablemos de la fiabilidad de los sistemas de almacenamiento, existen muchas oportunidades de perder datos que no dependen de problemas de hardware. Estos pueden incluir virus, hackers o cualquier otro tipo de eliminación/mal funcionamiento involuntario de datos. Por esta razón, realizar copias de seguridad de los datos productivos es una parte esencial del trabajo del ingeniero.
Un snapshot es una instantánea de un volumen en un momento específico. Al trabajar con la mayoría de los sistemas, como la virtualización, bases de datos, etc., necesitamos tomar dicha instantánea de la que copiaremos datos para la copia de seguridad, mientras nuestros sistemas de información pueden continuar trabajando tranquilamente con este volumen. Pero hay que recordar: no todos los snapshots son igualmente útiles. Los diferentes proveedores tienen diferentes enfoques para la creación de snapshots, relacionados con su arquitectura.
CoW (Copy-On-Write). Al intentar escribir un bloque de datos, su contenido original se copia en un área especial, y luego la escritura procede normalmente. Esto previene la corrupción de datos dentro del snapshot. Naturalmente, todas estas manipulaciones "parásitas" con los datos generan una carga adicional en el almacenamiento, y por esta razón, los proveedores con esta implementación no recomiendan usar más de una decena de snapshots, y en volúmenes de alta carga, no usarlos en absoluto.
RoW (Redirect-on-Write). En este caso, el volumen original se congela de manera natural, y al intentar escribir un bloque de datos, el almacenamiento escribe los datos en un área especial en el espacio libre, cambiando la ubicación de este bloque en la tabla de metadatos. Esto permite reducir el número de operaciones de reescritura, lo que a su vez mitiga la caída en el rendimiento y elimina las limitaciones respecto a los snapshots y su cantidad.
Los snapshots también se dividen en dos tipos en relación con las aplicaciones:
Application consistent. En el momento de la creación del snapshot, el almacenamiento llama a un agente en el sistema operativo del consumidor, que obliga a vaciar las cachés de disco de la memoria al disco y hace que esto ocurra en la aplicación. En este caso, al restaurar desde el snapshot, los datos serán consistentes.
Crash consistentEn este caso, no ocurre nada similar y la instantánea se crea tal como está. En caso de restaurar desde tal instantánea, la situación es idéntica a si se hubiera cortado la energía de repente, y es posible que haya cierta pérdida de datos almacenados en cachés que no llegaron al disco. Estas instantáneas son más fáciles de implementar y no causan caídas de rendimiento en las aplicaciones, pero son menos confiables.
¿Para qué se necesitan las instantáneas en los sistemas de almacenamiento de datos?
- Copia de seguridad sin agente directamente desde el SCD
- Creación de entornos de prueba basados en datos reales
- En el caso de los SCD de archivos, se puede usar para crear entornos VDI mediante el uso de instantáneas del SCD en lugar del hipervisor.
- Garantizar bajos RPO creando instantáneas programadas con una frecuencia significativamente mayor que la frecuencia de copia de seguridad.
Clonado
El clonado de un volumen funciona según un principio similar al de las instantáneas, pero sirve no solo para leer datos, sino para trabajar plenamente con ellos. Tenemos la capacidad de obtener una copia exacta de nuestro volumen, con todos los datos en él, sin hacer una copia física, lo que permite ahorrar espacio. Por lo general, el clonado de volúmenes se utiliza en Test&Dev o si desea verificar la funcionalidad de alguna actualización en su SI. El clonado permitirá hacerlo de la manera más rápida y económica en términos de recursos de disco, ya que solo se registrarán los bloques de datos modificados.
Replicación / registro
La replicación es un mecanismo para crear una copia de datos en otro SCD físico. Generalmente, cada proveedor tiene su propia tecnología patentada que solo funciona dentro de su propia línea. Sin embargo, también existen soluciones de terceros, incluidas las que operan a nivel de hipervisor, como VMware vSphere Replication.
La funcionalidad de las tecnologías patentadas y la comodidad de su uso generalmente superan con creces las universales, pero resultan inaplicables cuando, por ejemplo, es necesario hacer una réplica de NetApp a HP MSA.
La replicación se divide en dos subtipos:
Sincronizada. En el caso de replicación síncrona, la operación de escritura se envía inmediatamente al segundo sistema de almacenamiento y no se confirma su ejecución hasta que el sistema de almacenamiento remoto lo confirme. Esto aumenta la latencia de acceso, pero nos brinda una copia espejo exacta de los datos. Es decir, RPO = 0 en caso de pérdida del sistema de almacenamiento principal.
Asíncrona. Las operaciones de escritura se ejecutan solo en el sistema de almacenamiento principal y se confirman de inmediato, acumulándose en un búfer para transmisión por lotes al sistema de almacenamiento remoto. Este tipo de replicación es relevante para datos menos valiosos, o para canales de baja capacidad o que tengan alta latencia (característico para distancias superiores a 100 km). Por lo tanto, RPO = la frecuencia de envío por lotes.
A menudo, junto con la replicación, existe un mecanismo de registro de operaciones en disco. En este caso, se asigna un área específica para el registro y se almacenan las operaciones de escritura a una profundidad temporal determinada, o limitadas en volumen del registro. Para tecnologías específicas de marca, como EMC RecoverPoint, existe integración con el software del sistema, que permite asociar ciertas marcas a un registro específico en el registro. Gracias a esto, es posible retroceder el estado de un volumen (o crear un clon) no solo a las 23 de abril a las 11 horas 59 minutos 13 milisegundos, sino al momento anterior a “DROP ALL TABLES; COMMIT”.
Metro cluster
El metro cluster es una tecnología que permite crear replicación síncrona bidireccional entre dos sistemas de almacenamiento de tal manera que desde el exterior, este par parece un solo sistema de almacenamiento. Se utiliza para crear clústeres con brazos geográficamente separados en distancias metropolitanas (menos de 100 km).
Con el ejemplo de uso en un entorno de virtualización, el metro cluster permite crear un datastore con máquinas virtuales, accesible para escritura desde dos centros de datos. En este caso, se crea un clúster a nivel de hipervisores, compuesto por hosts en diferentes centros de datos físicos, conectados a este datastore. Esto permite lo siguiente:
- Automatización total del proceso de recuperación después de la muerte de uno de los centros de datos. Sin necesidad de herramientas adicionales, todas las VMs que funcionaban en el centro de datos fallecido se reiniciarán automáticamente en el que queda. RTO = tiempo de espera del clúster de alta disponibilidad (15 segundos para VMware) + tiempo de arranque del sistema operativo y inicio de servicios.
- Evitar desastres o, en ruso, избежание катастроф. Si se planifican trabajos de suministro eléctrico en el centro de datos 1, tenemos la posibilidad de migrar toda la carga crítica al centro de datos 2 sin interrupciones, antes de que comiencen los trabajos.
Virtualización
La virtualización de SAN es técnicamente el uso de volúmenes de otra SAN como discos. Un virtualizador de SAN puede simplemente presentar un volumen extraño al consumidor como suyo, mientras lo replica en otra SAN, o incluso crear un RAID de volúmenes externos.
Los representantes clásicos en la clase de virtualización de SAN son EMC VPLEX e IBM SVC. Y, por supuesto, las SAN con función de virtualización — NetApp, Hitachi, IBM / Lenovo Storwize.
¿Para qué puede ser necesaria?
- Reserva a nivel de SAN. Se crea un espejo entre volúmenes, donde una mitad puede estar en HP 3Par y la otra en NetApp. Y el virtualizador es de EMC.
- Migración de datos con un tiempo de inactividad mínimo entre SAN de diferentes fabricantes. Supongamos que los datos deben migrarse de un antiguo 3Par que se retirará a un nuevo Dell. En este caso, los consumidores se desconectan del 3Par, los volúmenes se pasan a través de VPLEX y ya se presentan a los consumidores nuevamente. Dado que no se ha modificado ni un bit en el volumen, el trabajo continúa. En segundo plano, se inicia el proceso de replicación del volumen en el nuevo Dell, y al finalizar, el espejo se rompe y el 3Par se desconecta.
- Organización de metaclustres.
Compresión / deduplicación
La compresión y deduplicación son tecnologías que permiten ahorrar espacio en disco en su SAN. Cabe mencionar que no todos los datos son susceptibles de compresión y/o deduplicación en principio, y algunos tipos de datos se comprimen y deduplican mejor, mientras que otros, al contrario.
La compresión y deduplicación pueden ser de 2 tipos:
Inline La compresión y deduplicación de bloques de datos se realiza antes de escribir estos datos en el disco. De esta manera, el sistema solo calcula el hash del bloque y lo compara con la tabla de datos ya existentes. En primer lugar, esto se ejecuta más rápido que simplemente escribir en el disco; en segundo lugar, no desperdiciamos espacio en disco innecesariamente.
Publicar Cuando estas operaciones se realizan sobre datos ya escritos que están en los discos. Por lo tanto, los datos primero se escriben en el disco, y solo después se calcula el hash, se eliminan los bloques innecesarios y se liberan recursos en disco.
Cabe mencionar que la mayoría de los proveedores utilizan ambos tipos, lo que permite optimizar estos procesos y, por ende, aumentar su eficiencia. La mayoría de los proveedores de sistemas de almacenamiento cuentan con herramientas que permiten analizar sus conjuntos de datos. Estas herramientas funcionan sobre la misma lógica que se implementa en los sistemas de almacenamiento, por lo que el nivel estimado de eficiencia coincidirá. También es importante recordar que muchos proveedores tienen programas de garantía de eficiencia que prometen un nivel no inferior al declarado para ciertos (o todos) tipos de datos. No se debe subestimar este programa; al calcular el sistema para sus tareas, considerando el coeficiente de eficiencia de un sistema específico, se puede ahorrar en capacidad. También hay que tener en cuenta que estos programas están diseñados para sistemas AFA, pero la compra de una menor cantidad de SSD en comparación con HDD en los sistemas clásicos, permitirá reducir su coste, y aunque no llegue a igualar el precio del sistema de disco, se aproximará bastante.
Modelo
Y aquí es donde llegamos a la pregunta bien planteada.
Me están ofreciendo dos opciones de sistemas de almacenamiento: ABC SuperStorage S600 y XYZ HyperOcean 666v4, ¿qué me aconsejas?
Se transforma en: "Me están ofreciendo dos opciones de sistemas de almacenamiento: ABC SuperStorage S600 y XYZ HyperOcean 666v4, ¿qué me aconsejas?"
Carga objetivo: máquinas virtuales mixtas VMware desde entornos productivos / prueba / desarrollo. Prueba = productivo. 150 TB para cada uno con un rendimiento máximo de 80,000 IOPS con bloques de 8kb y 50% de acceso aleatorio 80/20 lectura-escritura. 300 TB para desarrollo, con 50,000 IOPS es suficiente, acceso aleatorio 80, 80 escritura.
Productivo supuestamente en un metroclúster RPO = 15 minutos RTO = 1 hora, desarrollo en replicación asíncrona RPO = 3 horas, prueba en un solo sitio.
Tendrá 50 TB de base de datos, sería bueno para ellos tener un registro.
Tenemos servidores Dell en todas partes, y los sistemas de almacenamiento Hitachi son antiguos y apenas funcionan, planeamos un aumento del 50% en la carga tanto en volumen como en rendimiento.
Como se dice, en una pregunta bien formulada está el 80% de la respuesta.
Información adicional
¿Qué más deberían revisar según los autores?
Libros
- Oliger y Oliger, “Redes de Computadoras”. El libro ayudará a sistematizar y posiblemente a entender mejor cómo funciona el entorno de transmisión de datos para sistemas de almacenamiento IP/Ethernet.
- “EMC Information Storage and Management”. Un excelente libro sobre los fundamentos de los sistemas de almacenamiento, por qué, cómo y para qué.
Foros y chats
Recomendaciones generales
Precios
Ahora, en cuanto a los precios: en general, los precios de los sistemas de almacenamiento, si se encuentran, suelen ser precios de lista, a partir de los cuales cada cliente obtiene un descuento individual. El tamaño del descuento se compone de una gran cantidad de parámetros, así que predecir qué precio final obtendrá su empresa sin solicitarlo al distribuidor es simplemente imposible. Sin embargo, últimamente, los modelos de bajo costo han comenzado a aparecer en tiendas de computación comunes, como por ejemplo o . Allí se puede adquirir inmediatamente el sistema que le interesa a un precio fijo, como cualquier componente de computadora.
Pero es importante señalar que la comparación directa por TB/$ no es correcta. Si se aborda desde esta perspectiva, la solución más barata sería un simple JBOD + servidor, lo que no ofrecerá la flexibilidad ni la confiabilidad que proporciona un sistema de almacenamiento completo con dos controladores. Esto no significa que el JBOD sea algo negativo; simplemente hay que entender muy bien cómo y para qué se utilizará esta solución. A menudo se escucha que en el JBOD no hay nada que se rompa, ya que solo hay un backplane. Sin embargo, también pueden fallar los backplanes. Todo se rompe tarde o temprano.
Total
Las comparaciones entre sistemas deben hacerse no solo por precio o solo por rendimiento, sino por la combinación de todos los indicadores.
Compra un HDD solo si estás seguro de que lo necesitas. Para cargas bajas y tipos de datos no comprimibles, en caso contrario, deberías considerar los programas de garantía de eficiencia de almacenamiento en SSD, que ahora tienen la mayoría de los proveedores (y realmente funcionan, incluso en Rusia), aunque todo depende de las aplicaciones y los datos que se alojarán en este sistema de almacenamiento.
No persigas la baratura. A menudo, detrás de eso se esconden muchos problemas desagradables, uno de los cuales Evgeny Elizarov describió en sus artículos sobre . Y, al final, esa baratura puede salirte cara. No olvides: 'el tacaño paga dos veces'.
Fuente: habr.com
