

En Linux hay una gran cantidad de herramientas para depurar núcleos y aplicaciones. La mayoría de ellas impactan negativamente en el rendimiento de las aplicaciones y no pueden ser utilizadas en producción.
Hace un par de años se desarrolló — eBPF. Permite trazar el núcleo y las aplicaciones de usuario con bajo sobrecosto y sin necesidad de recompilar programas o cargar módulos externos en el núcleo.
Actualmente ya existen muchas utilidades aplicativas que utilizan eBPF, y en este artículo veremos cómo escribir nuestra propia utilidad de perfilado basada en la biblioteca . Este artículo se basa en eventos reales. Recorreremos el proceso desde la aparición del problema hasta su solución, mostrando cómo pueden ser utilizadas las utilidades existentes en situaciones concretas.
Ceph Es Lento
Se añadió un nuevo host al clúster Ceph. Tras migrar parte de los datos a él, notamos que la velocidad de procesamiento de las solicitudes de escritura era muy inferior a la de otros servidores.
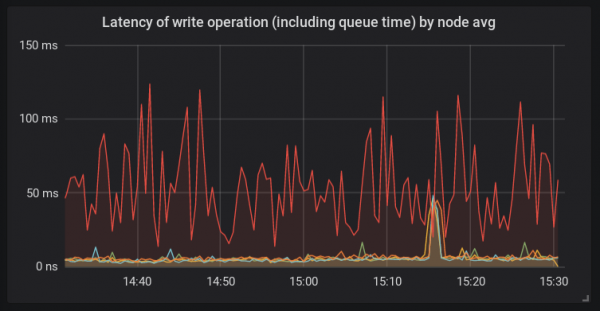
A diferencia de otras plataformas, en este host se utilizaba bcache y un nuevo núcleo de linux 4.15. Esta configuración de host fue utilizada aquí por primera vez. En ese momento era evidente que la raíz del problema teóricamente podría ser cualquier cosa.
Investigando el Host
Comencemos por ver qué ocurre dentro del proceso ceph-osd. Para ello, usaremos y (más detalles se pueden leer ):
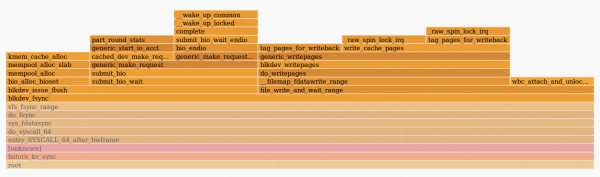
La imagen nos indica que la función fdatasync() gastó mucho tiempo al enviar la solicitud en la función generic_make_request(). Esto significa que, probablemente, la causa de los problemas esté fuera del propio demonio osd. Podría ser el núcleo o los discos. La salida de iostat mostraba una alta latencia en el procesamiento de solicitudes por los discos bcache.
Al revisar el host, encontramos que el demonio systemd-udevd consumía una gran cantidad de tiempo de CPU: alrededor del 20% en varios núcleos. Este comportamiento es extraño, así que hay que investigar su causa. Dado que Systemd-udevd trabaja con eventos uevent, decidimos observarlos a través de udevadm monitor. Resulta que se estaban generando una gran cantidad de eventos de cambio para cada dispositivo de bloque en el sistema. Esto es bastante inusual, por lo que será necesario averiguar qué genera todos esos eventos.
Usando la Caja de Herramientas BCC
Como ya hemos descubierto, el núcleo (y el demonio ceph en la llamada al sistema) pasa mucho tiempo en generic_make_request(). Vamos a medir la velocidad de trabajo de esta función. En ya hay una maravillosa utilidad — funclatency. Vamos a seguir el demonio por su PID con un intervalo entre las salidas de información de 1 segundo y mostrar el resultado en milisegundos.
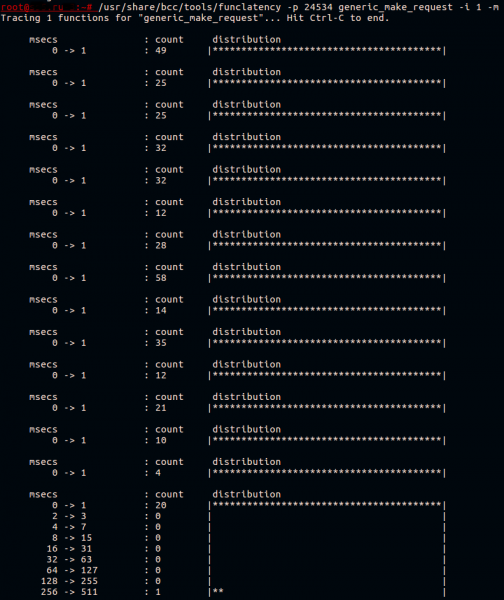
Normalmente, esta función funciona rápido. Todo lo que hace es pasar la solicitud a la cola del controlador del dispositivo.
Bcache es un dispositivo complejo que en realidad consta de tres discos:
- dispositivo de respaldo (disco en caché), en este caso es un HDD lento;
- dispositivo de caché (disco que almacena en caché), aquí es una partición de un dispositivo NVMe;
- dispositivo virtual bcache, con el que trabaja la aplicación.
Sabemos que la transferencia de la solicitud se ralentiza, pero ¿cuál de estos dispositivos es el problemático? Lo resolveremos más adelante.
Ahora sabemos que los eventos uevent probablemente están causando problemas. No es tan fácil encontrar qué exactamente los está generando. Supongamos que es algún software que se ejecuta periódicamente. Veremos qué software se está ejecutando en el sistema mediante el script execsnoop del mismo . Lo ejecutaremos y redirigiremos la salida a un archivo.
Por ejemplo, así:
/usr/share/bcc/tools/execsnoop | tee ./execdump
No proporcionaremos aquí la salida completa de execsnoop, pero una línea que nos interesa se veía así:
sh 1764905 5802 0 sudo arcconf getconfig 1 AD | grep Temperature | awk -F '[:\/]' '{print $2}' | sed 's\/^ ([0-9]*) C.*\/1\/'
La tercera columna es PPID (PID padre) del proceso. El proceso con PID 5802 resultó ser uno de los hilos de nuestro sistema de monitoreo. Al verificar la configuración del sistema de monitoreo, se encontraron parámetros configurados erróneamente. La temperatura del adaptador HBA se estaba tomando cada 30 segundos, lo que era mucho más frecuente de lo necesario. Después de cambiar el intervalo de verificación a uno más largo, descubrimos que la latencia en el procesamiento de solicitudes en este host dejó de destacarse frente a los demás hosts.
Pero aún no está claro por qué el dispositivo bcache estaba tan lento. Preparábamos una plataforma de prueba con una configuración idéntica y tratamos de reproducir el problema, ejecutando fio en bcache y desencadenando periódicamente udevadm trigger para generar eventos uevents.
Escribiendo Herramientas Basadas en BCC
Intentaremos escribir una simple utilidad para rastrear y mostrar en pantalla las llamadas más lentas generic_make_request(). También nos interesa el nombre del disco para el cual se invocó esta función.
El plan es simple:
- Registramos kprobe en generic_make_request():
- Guardamos en memoria el nombre del disco, accesible a través del argumento de la función;
- Guardamos la marca de tiempo.
- Registramos kretprobe en el retorno de generic_make_request():
- Obtenemos la marca de tiempo actual;
- Buscamos la marca de tiempo guardada y la comparamos con la actual;
- Si el resultado es mayor que el especificado, encontramos el nombre del disco guardado y lo mostramos en la terminal.
Kprobes y kretprobes utilizan un mecanismo de puntos de interrupción para modificar el código de las funciones sobre la marcha. Puedes leer y artículo sobre este tema. Si miramos el código de varias utilidades en , podemos notar que tienen una estructura idéntica. Así que en este artículo omitiremos el análisis de los argumentos del script y pasaremos directamente al programa BPF.
El texto de eBPF dentro del script de python se ve así:
bpf_text = """ # Aquí estará el código del programa bpf """
Para intercambiar datos entre funciones, los programas eBPF usan . Así que haremos lo mismo. Usaremos el PID del proceso como clave y definiremos la estructura como valor:
struct data_t {
	u64 pid;
	u64 ts;
	char comm[TASK_COMM_LEN];
	u64 lat;
	char disk[DISK_NAME_LEN];
};

BPF_HASH(p, u64, struct data_t);
BPF_PERF_OUTPUT(events);
Aquí registramos una tabla hash que se llama p, con una clave de tipo u64 y un valor de tipo struct data_t. La tabla estará disponible en el contexto de nuestro programa BPF. El macro BPF_PERF_OUTPUT registra otra tabla, llamada events, que se utiliza para al espacio de usuario.
Al medir retrasos entre la llamada a una función y su retorno, o entre llamadas a diferentes funciones, se debe tener en cuenta que los datos obtenidos deben pertenecer a un mismo contexto. En otras palabras, se debe recordar la posible ejecución paralela de funciones. Tenemos la posibilidad de medir el retraso entre la llamada a una función en el contexto de un proceso y el retorno de esta función en el contexto de otro proceso, pero probablemente esto no tenga utilidad. Un buen ejemplo aquí podría ser , donde como clave de la tabla hash se asigna un puntero a struct request, que refleja una solicitud a disco.
A continuación, necesitamos escribir el código que se ejecutará al llamar a la función bajo examen:
void start(struct pt_regs *ctx, struct bio *bio) {
	u64 pid = bpf_get_current_pid_tgid();
	struct data_t data = {};
	u64 ts = bpf_ktime_get_ns();
	data.pid = pid;
	data.ts = ts;
	bpf_probe_read_str(&data.disk, sizeof(data.disk), (void*)bio->bi_disk->disk_name);
	p.update(&pid, &data);
}
Aquí como segundo argumento se insertará el primer argumento de la función llamada. . Después de esto, obtenemos el PID del proceso en el contexto del cual estamos trabajando y la marca de tiempo actual en nanosegundos. Registramos todo esto en la memoria recién asignada struct data_t data. Obtenemos el nombre del disco de la estructura bio, que se pasa al invocar generic_make_request(), y lo guardamos en la misma estructura data. El último paso es agregar un registro a la tabla hash mencionada anteriormente.
La siguiente función se invocará al retornar de generic_make_request():
void stop(struct pt_regs *ctx) {
    u64 pid = bpf_get_current_pid_tgid();
    u64 ts = bpf_ktime_get_ns();
    struct data_t* data = p.lookup(&pid);
    if (data != 0 && data->ts > 0) {
        bpf_get_current_comm(&data->comm, sizeof(data->comm));
        data->lat = (ts - data->ts) / 1000;
        if (data->lat > MIN_US) {
            FACTOR
            data->pid >>= 32;
            events.perf_submit(ctx, data, sizeof(struct data_t));
        }
        p.delete(&pid);
    }
}
Esta función es similar a la anterior: obtenemos el PID del proceso y la marca de tiempo, pero no asignamos memoria para una nueva estructura de datos. En su lugar, buscamos en la tabla hash una estructura existente con la clave == el PID actual. Si encontramos la estructura, obtenemos el nombre del proceso en ejecución y lo agregamos a ella.
El desplazamiento binario que utilizamos aquí es necesario para obtener el GID del hilo, es decir, el PID del proceso principal que lanzó el hilo en el contexto del cual estamos trabajando. La función que invocamos devuelve tanto el GID del hilo como su PID en un solo valor de 64 bits.
Cuando se muestra en la terminal, no nos interesa el hilo, sino el proceso principal. Después de comparar la latencia obtenida con el umbral dado, pasamos nuestra estructura data al espacio de usuario a través de la tabla events, después de lo cual eliminamos la entrada de p.
En el script de Python que cargará este código, necesitamos reemplazar MIN_US y FACTOR por los umbrales de latencia y las unidades de tiempo que pasaremos como argumentos:
bpf_text = bpf_text.replace('MIN_US',str(min_usec))
if args.milliseconds:
	bpf_text = bpf_text.replace('FACTOR','data->lat /= 1000;')
	label = "msec"
else:
	bpf_text = bpf_text.replace('FACTOR','')
	label = "usec"
Ahora necesitamos preparar el programa BPF a través de y registrar las pruebas:
b = BPF(text=bpf_text)
b.attach_kprobe(event="generic_make_request",fn_name="start")
b.attach_kretprobe(event="generic_make_request",fn_name="stop")
También tendremos que definir struct data_t en nuestro script, de lo contrario no podremos leer nada:
TASK_COMM_LEN = 16	# linux/sched.h
DISK_NAME_LEN = 32	# linux/genhd.h
class Data(ct.Structure):
	_fields_ = [("pid", ct.c_ulonglong),
            	("ts", ct.c_ulonglong),
            	("comm", ct.c_char * TASK_COMM_LEN),
            	("lat", ct.c_ulonglong),
            	("disk",ct.c_char * DISK_NAME_LEN)]
El último paso es mostrar los datos en el terminal:
def print_event(cpu, data, size):
    global start
    event = ct.cast(data, ct.POINTER(Data)).contents
    if start == 0:
        start = event.ts
    time_s = (float(event.ts - start)) / 1000000000
    print("%-18.9f %-16s %-6d   %-1s %s   %s" % (time_s, event.comm, event.pid, event.lat, label, event.disk))

b["events"].open_perf_buffer(print_event)
# formatear salida
start = 0
while 1:
    try:
        b.perf_buffer_poll()
    except KeyboardInterrupt:
        exit()
El script está disponible en . Intentemos ejecutarlo en una plataforma de pruebas donde se esté ejecutando fio, escribiendo en bcache, y llamemos a udevadm monitor:
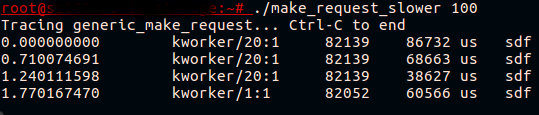
¡Finalmente! Ahora vemos que lo que parecía un dispositivo bcache con problemas es, de hecho, una llamada que está causando la ralentización generic_make_request() para el disco en caché.
Profundiza en el Kernel
¿Qué es lo que realmente ralentiza durante la transmisión de la solicitud? Vemos que la latencia ocurre incluso antes de que comience el conteo de la solicitud, es decir, el seguimiento de una solicitud específica para la posterior salida de estadísticas ( /proc/diskstats o iostat) aún no ha comenzado. Esto se puede comprobar fácilmente ejecutando iostat durante la reproducción del problema, o , que se basa en el inicio y finalización del conteo de solicitudes. Ninguna de estas utilidades mostrará problemas para las solicitudes al disco en caché.
Si miramos la función generic_make_request(), veremos que antes de que comience el conteo de la solicitud, se llaman a otras dos funciones. La primera es generic_make_request_checks(), que realiza comprobaciones de legitimidad de la solicitud en relación con la configuración del disco. La segunda es , en la que hay una llamada interesante a :
ret = wait_event_interruptible(q->mq_freeze_wq,
	(atomic_read(&q->mq_freeze_depth) == 0 &&
	(preempt || !blk_queue_preempt_only(q))) ||
	blk_queue_dying(q));
En ella, el núcleo espera a que se desbloquee la cola. Midamos la latencia blk_queue_enter():
~# /usr/share/bcc/tools/funclatency  blk_queue_enter -i 1 -m
Rastreando 1 funciones para "blk_queue_enter"... Presione Ctrl-C para terminar.

 	msecs           	: count 	distribution
     	0 -> 1      	: 341  	|****************************************|

 	msecs           	: count 	distribution
     	0 -> 1      	: 316  	|****************************************|

 	msecs           	: count 	distribution
     	0 -> 1      	: 255  	|****************************************|
     	2 -> 3      	: 0    	|                                    	|
     	4 -> 7      	: 0    	|                                    	|
     	8 -> 15     	: 1    	|                                    	|
Parece que estamos cerca de resolverlo. Las funciones utilizadas para "congelar/descongelar" la cola son y . Se utilizan cuando es necesario cambiar la configuración de la cola de solicitudes, potencialmente peligrosa para las solicitudes que se encuentran en esta cola. Al llamar a blk_mq_freeze_queue() la función se incrementa el contador q->mq_freeze_depth. Después de esto, el núcleo espera a que la cola se vacíe en .
El tiempo de espera para vaciar esta cola es equivalente al retraso del disco, ya que el núcleo espera que se completen todas las operaciones en cola. Una vez que la cola está vacía, se aplican los cambios de configuración. Después se llama a , que decremente el contador freeze_depth.
Ahora sabemos lo suficiente como para corregir la situación. El comando udevadm trigger llevará a la aplicación de la configuración para el dispositivo de bloques. Estas configuraciones están descritas en las reglas de udev. Podemos averiguar qué configuraciones están "congelando" la cola intentando modificarlas a través de sysfs o revisando el código fuente del núcleo. También podemos intentar la utilidad BCC , que mostrará en la terminal las trazas de la pila del núcleo y del espacio de usuario para cada llamada a blk_freeze_queue, por ejemplo:
~# /usr/share/bcc/tools/trace blk_freeze_queue -K -U
PID 	TID 	COMM        	FUNC
3809642 3809642 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	elevator_switch+0x29 [kernel]
    	elv_iosched_store+0x197 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[unknown]

3809631 3809631 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	queue_requests_store+0xb6 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[unknown]
Las reglas de udev cambian con poca frecuencia y generalmente esto ocurre bajo control. Así que vemos que incluso aplicar valores ya establecidos provoca un aumento en la latencia de transmisión de solicitudes desde la aplicación al disco. Por supuesto, generar eventos de udev cuando no hay cambios en la configuración de los discos (por ejemplo, un dispositivo no se conecta/desconecta) no es una buena práctica. Sin embargo, podemos ayudar al núcleo a no realizar trabajo innecesario y no "congelar" la cola de solicitudes, si no hay necesidad de ello. corrigen la situación.
Conclusión
eBPF es una herramienta muy flexible y potente. En este artículo revisamos un caso práctico y demostramos una pequeña parte de lo que es posible hacer. Si estás interesado en el desarrollo de utilidades BCC, vale la pena mirar en , que describe bien los fundamentos de la operación.
Hay otras herramientas interesantes para depuración y perfilado basadas en eBPF. Una de ellas es , que permite escribir potentes comandos de una sola línea y pequeños programas en un lenguaje similar a awk. Otra es , que permite recolectar métricas de bajo nivel de alta resolución directamente en tu servidor prometheus, con la posibilidad de obtener una visualización atractiva y alertas incluso en el futuro.
Fuente: habr.com
