

En este artículo, hablaré sobre cómo el proyecto en el que trabajo ha evolucionado de un gran monolito a un conjunto de microservicios.
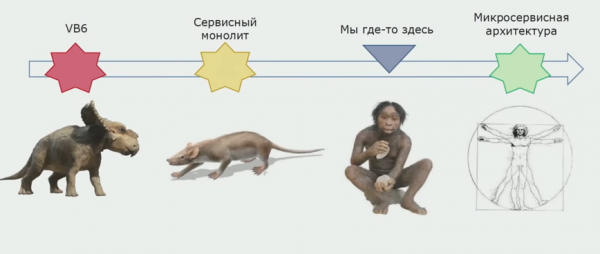
El proyecto comenzó su historia hace bastante tiempo, a principios de 2000. Las primeras versiones fueron escritas en Visual Basic 6. Con el tiempo, quedó claro que el desarrollo en este lenguaje sería difícil de mantener en el futuro, dado que el IDE y el propio lenguaje evolucionaban lentamente. A finales de la década de 2000, se decidió migrar a un C# más prometedor. La nueva versión se desarrolló en paralelo con las mejoras de la antigua, y poco a poco, se fueron integrando más códigos en .NET. El backend en C# inicialmente se orientó a una arquitectura de servicios, sin embargo, durante el desarrollo se utilizaron bibliotecas comunes con lógica, y los servicios se ejecutaban en un único proceso. Así, se obtuvo una aplicación que nosotros denominamos 'monolito de servicios'.
Una de las pocas ventajas de esta combinación era la capacidad para que los servicios se invocaran entre sí a través de una API externa. Había evidentes presunciones para pasar a una arquitectura de servicios más adecuada, y a la larga, a una arquitectura de microservicios.
Comenzamos nuestro trabajo de descomposición alrededor de 2015. Aún no hemos alcanzado un estado ideal; quedan partes del gran proyecto que ya son difíciles de considerar monolitos, pero tampoco son realmente microservicios. Sin embargo, el progreso ha sido significativo.
Sobre esto hablaré en el artículo.
Contenido
Arquitectura y problemas de la solución existente
Inicialmente, la arquitectura se veía de la siguiente manera: la interfaz de usuario era una aplicación independiente, la parte monolítica estaba escrita en Visual Basic 6, y la aplicación en .NET consistía en un conjunto de servicios relacionados que trabajaban con una base de datos bastante grande.
Desventajas de la solución anterior
Punto único de fallo
Teníamos un punto único de fallo: la aplicación en .NET se ejecutaba en un solo proceso. Si había un fallo en alguno de los módulos, la aplicación fallaba completamente y había que reiniciarla. Dado que automatizamos una gran cantidad de procesos para diferentes usuarios, debido a un fallo en uno de ellos, todos no podían trabajar durante un tiempo. Y en caso de un error de programación, la reserva no ayudaba.
Cola de mejoras
Esta deficiencia es más bien organizativa. En nuestra aplicación hay muchos clientes, y todos quieren mejorarla lo antes posible. Anteriormente, era imposible hacerlo en paralelo, y todos los clientes se ponían en cola. Este proceso generaba descontento en el negocio, ya que necesitaban demostrar que su tarea tenía valor. Y el equipo de desarrollo gastaba tiempo organizando esta cola. Esto consumía mucho tiempo y esfuerzo, y el producto no podía cambiar tan rápido como ellos deseaban.
Uso subóptimo de recursos
Al alojar servicios en un solo proceso, siempre copiábamos completamente la configuración de servidor a servidor. Queríamos alojar los servicios más demandantes por separado, para no desperdiciar recursos y tener un control más flexible sobre nuestro esquema de despliegue.
Dificultad para implementar tecnologías modernas
Problema conocido para todos los desarrolladores: hay ganas de implementar tecnologías modernas en el proyecto, pero no hay posibilidades. Con una gran solución monolítica, cualquier actualización de la biblioteca actual, sin mencionar la transición a una nueva, se convierte en una tarea bastante no trivial. Es necesario convencer durante mucho tiempo al líder de equipo de que esto traerá más beneficios que nervios gastados.
Complejidad de la entrega de cambios
Este fue el problema más serio: lanzábamos versiones cada dos meses.
Cada lanzamiento se convertía en una verdadera catástrofe para el banco, a pesar de las pruebas y los esfuerzos de los desarrolladores. El negocio entendía que no tendría parte de la funcionalidad funcionando al inicio de la semana. Y los desarrolladores sabían que les esperaba una semana de incidentes serios.
Todos tenían el deseo de cambiar la situación.
Expectativas sobre los microservicios
Entrega de componentes según disponibilidad. Entrega de componentes a medida que están listos gracias a la descomposición de la solución y la separación de diferentes procesos.
Pequeños equipos de productos. Esto es importante porque es difícil de gestionar un gran equipo que trabaja en un antiguo monolito. Tal equipo se ve obligado a seguir un proceso estricto, mientras que se desea más creatividad e independencia. Esto solo podían permitirse equipos pequeños.
Aislamiento de servicios en procesos separados. Idealmente, se debería aislar en contenedores, pero un gran número de servicios escritos en .NET Framework solo se ejecutan en Windows. Ahora están surgiendo servicios en .NET Core, aunque todavía son pocos.
Flexibilidad de despliegue. Nos gustaría combinar servicios según nuestras necesidades y no de la manera que impone el código.
Uso de nuevas tecnologías. Esto es interesante para cualquier programador.
Problemas de la transición
Por supuesto, si fuera sencillo dividir un monolito en microservicios, no se hablaría de ello en conferencias ni se escribirían artículos. Este proceso tiene muchos escollos, describiré los principales que nos dificultaron.
El primer problema es típico de la mayoría de los monolitos: la coherencia de la lógica de negocio. Cuando escribimos un monolito, deseamos reutilizar nuestras clases para no escribir código innecesario. Pero al pasar a microservicios, esto se convierte en un problema: todo el código está bastante rígidamente vinculado y es difícil dividir los servicios.
En el momento de comenzar el trabajo, había más de 500 proyectos en el repositorio y más de 700 mil líneas de código. Es una solución bastante grande y el segundo problemaNo era posible simplemente dividirlo en microservicios.
El tercer problema es la falta de la infraestructura necesaria. De hecho, nos dedicamos a copiar manualmente el código fuente en los servidores.
Cómo pasar de un monolito a microservicios
Identificación de microservicios
En primer lugar, definimos de inmediato que la separación de microservicios es un proceso iterativo. Siempre se nos exigió que simultáneamente desarrolláramos tareas comerciales. Cómo lo vamos a llevar a cabo técnicamente es nuestro problema. Por lo tanto, estuvimos preparados para un proceso iterativo. De otra manera no funcionará, si tienes una gran aplicación que no está lista desde el principio para ser reescrita.
¿Qué métodos utilizamos para identificar microservicios?
Primer método — extraer módulos existentes como servicios. En este sentido, tuvimos suerte: ya existían servicios configurados que funcionaban con el protocolo WCF. Estaban distribuidos en ensamblajes separados. Los trasladamos individualmente, añadiendo un pequeño módulo de inicio a cada ensamblaje. Este fue escrito con la magnífica biblioteca Topshelf, que permite ejecutar la aplicación tanto como servicio como consola. Esto es conveniente para la depuración, ya que no se requieren proyectos adicionales en la solución.
Los servicios estaban conectados por lógica de negocio, ya que utilizaban ensamblajes comunes y trabajaban con una base de datos compartida. Era difícil llamarlos micorservicios en el sentido más puro. Sin embargo, podíamos presentar estos servicios por separado, en diferentes procesos. Esto ya permitía reducir la influencia que tenían unos sobre otros, disminuyendo el problema con el desarrollo paralelo y el punto único de falla.
El ensamblaje con el host es solo una línea de código en la clase Program. Ocultamos el trabajo con Topshelf en una clase auxiliar.
namespace RBA.Services.Accounts.Host
{
   internal class Program
   {
      private static void Main(string[] args)
      {
        HostRunner.Run("RBA.Services.Accounts.Host");

       }
    }
}
La segunda forma de destacar microservicios: crearlos para resolver nuevas tareas. Si el monolito no crece, eso ya es excelente, significa que estamos avanzando en la dirección correcta. Para resolver nuevas tareas, tratamos de crear servicios separados. Siempre que fuera posible, creamos servicios más "canónicos", que controlan completamente su modelo de datos y tienen su propia base de datos.
Al igual que muchos, comenzamos con servicios de autenticación y autorización. Son perfectos para esto. Son independientes, por lo general tienen un modelo de datos separada. No interactúan con el monolito, solo este se dirige a ellos para resolver ciertas tareas. En estos servicios podemos comenzar la transición a la nueva arquitectura, depurar la infraestructura en ellos, probar enfoques relacionados con bibliotecas de red, etc. En nuestra organización, no hay equipos que no puedan configurar un servicio de autenticación.
La tercera forma de destacar microservicios, que utilizamos, es un poco específico para nosotros. Se trata de separar la lógica del negocio de la capa de UI. Nuestra aplicación principal de UI es de escritorio, y tanto esta como el backend están escritas en C#. Los desarrolladores cometen errores de forma periódica y colocan en la UI partes de lógica que deberían existir en el backend y ser reutilizables.
Si miramos un ejemplo real del código de la parte de UI, se puede ver que la mayor parte de esta solución contiene verdadera lógica de negocio, que es útil en otros procesos, no solo para construir formularios de UI.
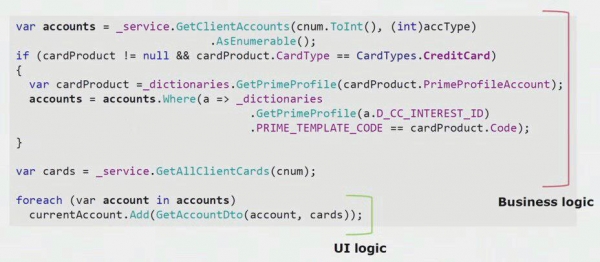
La verdadera lógica de UI está solo en las últimas líneas. La trasladamos al servidor para poder reutilizarla, lo que reduce la UI y nos permite lograr una arquitectura correcta.
La cuarta y más importante forma de destacar microservicios, que permite reducir el monolito, es la extracción de servicios existentes con reestructuración. Cuando extraemos módulos existentes tal como están, el resultado no siempre es satisfactorio para los desarrolladores, y el proceso de negocio puede haber quedado obsoleto desde que se creó la funcionalidad. Gracias a la refactorización, podemos mantener un nuevo proceso de negocio, porque los requisitos cambian constantemente. Podemos mejorar el código fuente, eliminar defectos conocidos y crear un modelo de datos de mayor calidad. Se acumulan muchas ventajas.
La separación de servicios con reestructuración está inextricablemente relacionada con el concepto de contexto limitado. Este concepto proviene del diseño orientado a objetos. Se refiere a un área del modelo de dominio donde todos los términos de un lenguaje único están definidos de manera unívoca. Tomemos como ejemplo el contexto de seguros y cuentas. Tenemos una aplicación monolítica, y es necesario trabajar en los seguros con la cuenta. Esperamos que el desarrollador encuentre en otro ensamblaje la clase existente 'Cuenta', haga referencia a ella desde la clase 'Seguro', y obtendremos código funcional. Se cumplirá el principio DRY, y la tarea se completará más rápido gracias al uso del código existente.
En consecuencia, resulta que los contextos de las cuentas y los seguros están relacionados. Cuando surjan nuevos requisitos, esta relación obstaculizará el desarrollo, aumentando la complejidad de una lógica de negocio que ya es complicada. Para abordar este problema, es necesario encontrar en el código las fronteras entre contextos y eliminar sus violaciones. Por ejemplo, para los contextos de seguros, es probable que un número de cuenta del Banco Central de 20 dígitos y la fecha de apertura de la cuenta sean suficientes.
Para separar estos contextos limitados entre sí y comenzar el proceso de extracción de microservicios de una solución monolítica, utilizamos un enfoque como la creación de API externas dentro de la aplicación. Si sabíamos que algún módulo debería convertirse en un microservicio, de alguna manera transformarse dentro del proceso, inmediatamente hacíamos llamadas a la lógica que pertenece a otro contexto limitado a través de llamadas externas. Por ejemplo, a través de REST o WCF.
Nosotros decidimos firmemente que no evitaríamos el código que requeriría realizar transacciones distribuidas. En nuestro caso, resultó bastante fácil seguir esta regla. Hasta ahora, no hemos tenido situaciones en las que realmente se necesitaran transacciones distribuidas estrictas; la consistencia final entre los módulos ha sido más que suficiente.
Consideremos un ejemplo concreto. Tenemos el concepto de orquestador: un canal que procesa la entidad "solicitud". Crea al cliente, la cuenta y la tarjeta bancaria uno tras otro. Si el cliente y la cuenta se crean con éxito, pero la creación de la tarjeta falla, la solicitud no cambia a estado "exitoso" y permanece en estado "tarjeta no creada". En el futuro, una actividad en segundo plano la recogerá y finalizará. El sistema permanece en un estado de inconsistencia durante algún tiempo, pero en general, estamos satisfechos con ello.
En caso de que surja una situación en la que sea necesario guardar de manera coherente parte de los datos, es probable que optemos por consolidar el servicio para manejar esto en un solo proceso.
Consideremos un ejemplo de extracción de un microservicio. ¿Cómo se puede llevarlo de manera relativamente segura a producción? En este ejemplo, tenemos una parte separada del sistema: el módulo de servicios de nómina, uno de cuyos fragmentos de código nos gustaría convertir en microservicio.
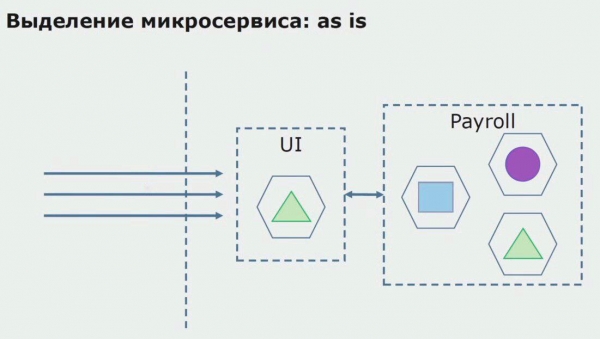
Primero creamos un microservicio, reescribiendo el código. Mejoramos algunos aspectos que no nos satisfacían. Implementamos nuevos requisitos comerciales del cliente. Agregamos un API Gateway en la conexión entre la interfaz de usuario y el backend, que proporcionará el paso de llamadas.
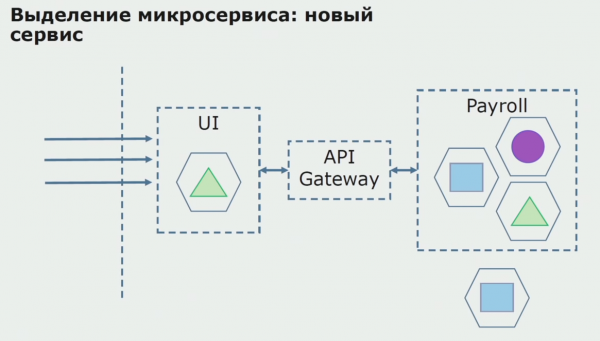
A continuación, lanzamos esta configuración en producción, pero en estado piloto. La mayoría de nuestros usuarios todavía trabaja con los antiguos procesos comerciales. Para los nuevos usuarios, estamos desarrollando una nueva versión de la aplicación monolítica, que ya no contiene este proceso. De hecho, tenemos en modo piloto la combinación del monolito y el microservicio.
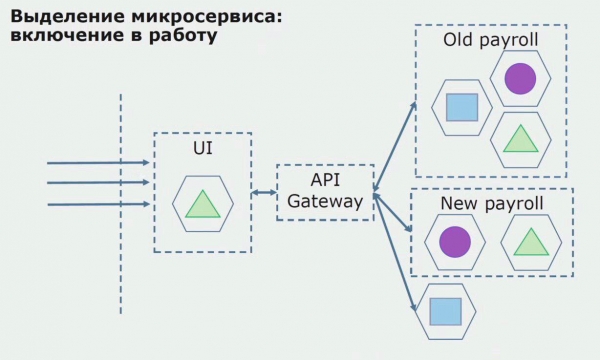
Con un piloto exitoso, entendemos que la nueva configuración realmente funciona, podemos eliminar el viejo monolito de la ecuación y dejar la nueva configuración en el lugar de la antigua solución.
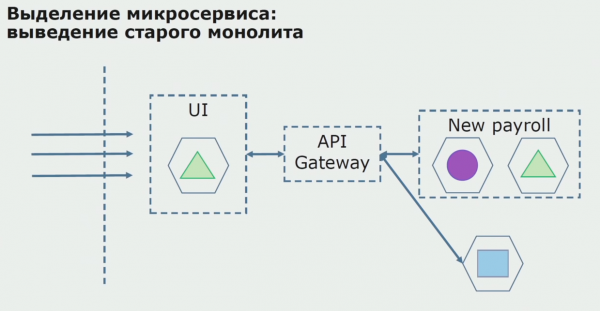
En resumen, utilizamos prácticamente todos los métodos existentes para dividir el código fuente del monolito. Todos ellos nos permiten reducir el tamaño de las partes de la aplicación y trasladarlas a nuevas bibliotecas, creando un código fuente de mayor calidad.
Trabajo con la base de datos
La base de datos es más difícil de dividir que el código fuente, ya que contiene no solo el esquema actual, sino también datos históricos acumulados.
Nuestra base de datos, al igual que muchas otras, tenía otra desventaja importante: su gran tamaño. Esta base de datos fue diseñada de acuerdo con la compleja lógica empresarial del monolito, y entre las tablas de varios contextos limitados se acumularon vínculos.
En nuestro caso, para colmo de males (base de datos grande, numerosos vínculos, a veces límites poco claros entre las tablas), surgió un problema que se encuentra en muchos grandes proyectos: el uso del patrón de base de datos compartida. Los datos se extraían de las tablas a través de views, mediante replicación y se trasladaban a otros sistemas donde se necesitaba esta replicación. Como resultado, no podíamos mover las tablas a un esquema separado porque estaban siendo utilizadas activamente.
La segmentación nos ayuda con la mencionada división en contextos limitados en el código. Normalmente, nos proporciona una buena visión de cómo dividimos los datos a nivel de base de datos. Entendemos qué tablas pertenecen a un contexto limitado y cuáles a otro.
Hemos aplicado dos enfoques globales para separar la base de datos: separación de tablas existentes y separación con reestructuración.
La separación de tablas existentes es un método que se aplica bien cuando la estructura de datos es de calidad, satisface los requisitos comerciales y todos están de acuerdo. En este caso, podemos destacar como un esquema separado las tablas existentes.
La separación con reestructuración es necesaria cuando el modelo de negocio ha cambiado drásticamente y las tablas ya no nos satisfacen en absoluto.
Separación de tablas existentes. Necesitamos determinar qué vamos a separar. Sin este conocimiento, no podremos avanzar, y aquí nos ayudará la separación de contextos limitados en el código. Por lo general, si logramos comprender los límites de los contextos en el código fuente, se hace claro qué tablas deben estar en la lista para ser separadas.
Imaginemos que tenemos una solución en la que dos módulos del monolito interactúan con una única base de datos. Necesitamos hacer que el segmento de tablas separadas sea accedido solo por un módulo, mientras que el otro comience a interactuar con él a través de la API. Para comenzar, es suficiente que solo se puedan realizar escrituras a través de la API. Esta es una condición necesaria para poder hablar de la independencia de los microservicios. Las conexiones de lectura pueden permanecer, mientras no haya un gran problema con ello.
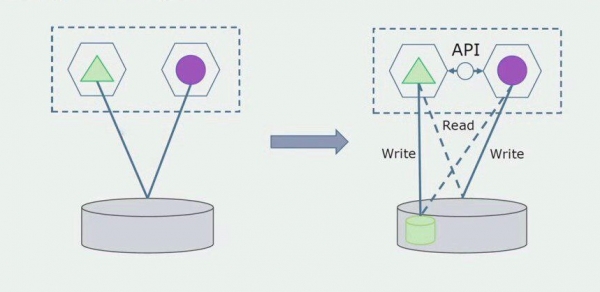
El siguiente paso es que ya podemos extraer el segmento de código que trabaja con las tablas separadas, con o sin reestructuración, a un microservicio separado y ejecutarlo en un proceso y contenedor independientes. Este será un servicio separado con conexión a la base de datos del monolito y aquellas tablas que no están directamente relacionadas con él. El monolito seguirá interactuando en lectura con la parte separada.
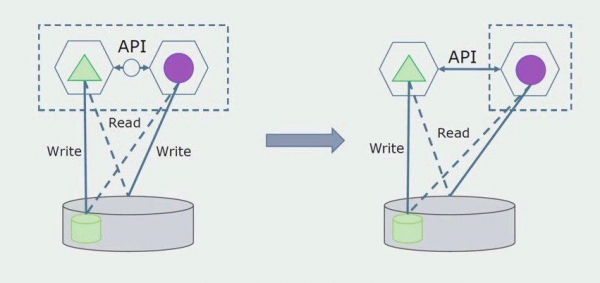
Más adelante, eliminaremos esta conexión, es decir, también trasladaremos la lectura de datos de la aplicación monolítica de las tablas separadas a través de la API.
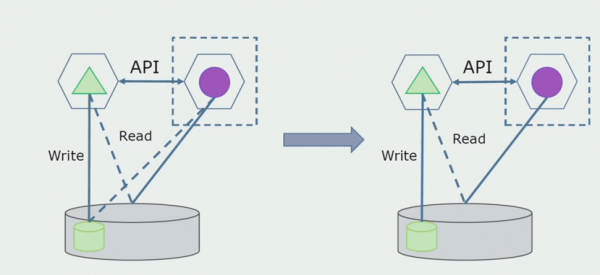
A continuación, extraeremos de la base de datos general las tablas con las que trabaja solo el nuevo microservicio. Podemos mover las tablas a un esquema separado o incluso a una base de datos física separada. Queda una conexión de lectura entre el microservicio y la base de datos del monolito, pero no hay nada de qué preocuparse; en tal configuración, puede funcionar durante un tiempo razonablemente largo.
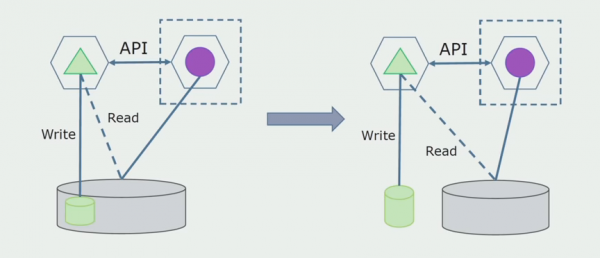
El último paso es eliminar todas las relaciones por completo. En este caso, es posible que necesitemos la migración de datos desde la base de datos principal. A veces, queremos reutilizar en varias bases algunos datos replicables desde sistemas externos o diccionarios. Esto ocurre periódicamente en nuestro caso.
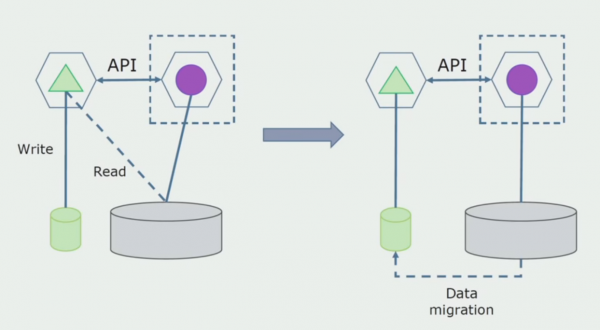
Departamento de reestructuración. Este método es muy similar al primero, solo que va en orden inverso. De inmediato se destaca una nueva base de datos y un nuevo microservicio que interactúa con el monolito a través de API. Sin embargo, permanece un conjunto de tablas de BD que queremos eliminar en el futuro. Ya no las necesitaremos; en el nuevo modelo las hemos reemplazado.
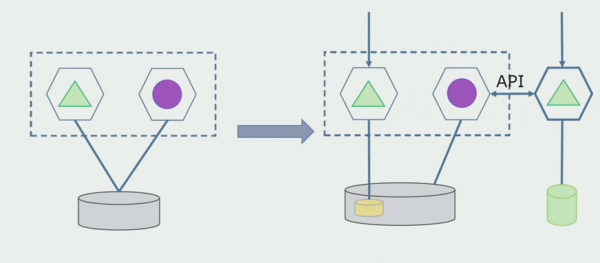
Para que este esquema funcione, probablemente necesitaremos un período de transición.
A continuación, hay dos enfoques posibles.
Primero: duplicamos todos los datos en las nuevas y viejas bases. En este caso, tenemos redundancia de datos, pueden surgir problemas de sincronización. Pero a cambio, podemos tener dos clientes diferentes. Uno trabajará con la nueva versión, el otro con la antigua.
Segundo: separamos los datos por alguna característica comercial. Por ejemplo, teníamos 5 productos en el sistema que se almacenan en la antigua base de datos. El sexto, en el marco de una nueva tarea comercial, lo colocamos en la nueva BD. Pero necesitaremos un API Gateway que sincronice estos datos y muestre al cliente de dónde y qué tomar.
Ambos enfoques son viables, elija según la situación.
Después de asegurarnos de que todo funcione, se puede desconectar la parte del monolito que trabaja con las antiguas estructuras de BD.
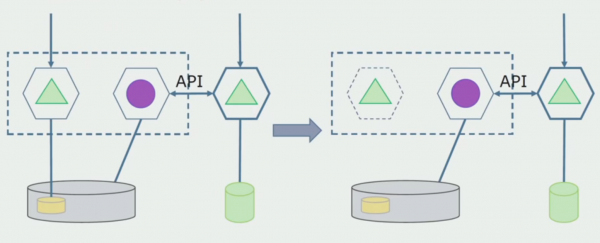
El último paso será eliminar las viejas estructuras de datos.
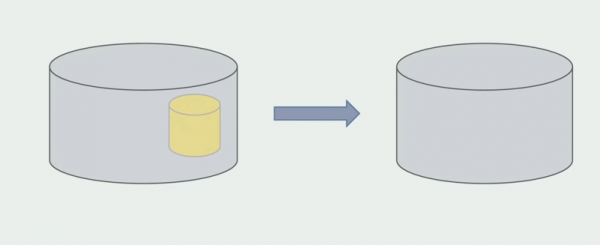
Resumiendo, podemos decir que tenemos problemas con la BD: es más difícil trabajar con ella en comparación con el código fuente, es más complicado dividirla, pero se puede y se debe hacer. Hemos encontrado algunas maneras que permiten hacerlo de manera bastante segura; de hecho, cometer un error con los datos es más fácil que con el código fuente.
Trabajo con el código fuente
Así es como se veía el esquema del código fuente cuando comenzamos a analizar el proyecto monolítico.
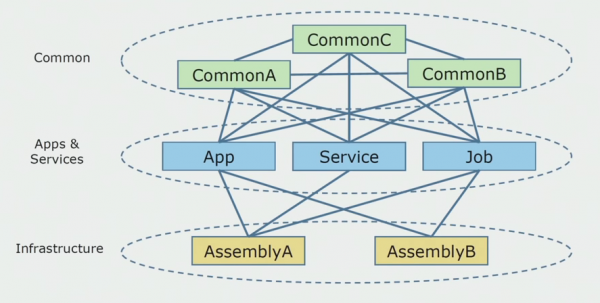
Se puede dividir condicionalmente en tres capas. Esta es la capa de módulos ejecutables, plugins, servicios y actividades individuales. De hecho, estos eran los puntos de entrada dentro de la solución monolítica. Todos estaban firmemente interconectados por la capa Común. En esta capa se encontraba la lógica empresarial que era utilizada en conjunto por los servicios, así como numerosas interconexiones. Cada servicio y plugin utilizaba hasta 10 o más ensamblados comunes, dependiendo de su tamaño y la ética de los desarrolladores.
Tuvimos la suerte de contar con bibliotecas de infraestructura que se podían utilizar de forma independiente.
A veces surgía la situación en la que algunos objetos Comunes en realidad no pertenecían a esta capa, sino que eran bibliotecas de infraestructura. Esto se resolvía mediante un cambio de nombre.
Los contextos limitados eran los que más preocupación generaban. A veces, 3-4 contextos se mezclaban en un solo ensamblado Común y se utilizaban entre sí en el marco de funciones empresariales. Era necesario entender dónde se podía dividir esto y cuáles eran los límites, y qué hacer a continuación con el mapeo de esta división a los ensamblados del código fuente.
Formulamos varias reglas para el proceso de separación de código.
Primera: ya no queríamos compartir la lógica empresarial entre servicios, actividades y plugins. Queríamos hacer que la lógica empresarial fuese independiente dentro de los microservicios. Por otro lado, los microservicios, en un mundo ideal, se perciben como servicios que existen de manera completamente independiente. Creo que este enfoque es un poco derrochador, y es difícil lograrlo, ya que, por ejemplo, los servicios en C# estarán conectados a la biblioteca estándar de todos modos. Nuestro sistema está escrito en C#, por lo que no hemos tenido que utilizar otras tecnologías hasta ahora. Por lo tanto, decidimos que podíamos permitirnos utilizar ensamblados técnicos comunes. Lo importante es que no contengan fragmentos de lógica empresarial. Si tiene un envoltorio práctico sobre el ORM que utiliza, copiarlo de un servicio a otro puede resultar muy costoso.
Nuestro equipo es un gran admirador del diseño orientado a dominios, por lo que la "arquitectura cebolla" se ajusta perfectamente a nosotros. La base de nuestros servicios se convirtió no en una capa de acceso a datos, sino en una ensambladura con lógica de dominio que contiene únicamente la lógica empresarial y carece de vínculos con la infraestructura. Así, podemos desarrollar de forma independiente la ensambladura de dominio para resolver problemas relacionados con los frameworks.
En esta etapa, nos encontramos con el primer problema serio. El servicio debía referirse a una ensambladura de dominio, queríamos que la lógica fuera independiente, y el principio DRY se interponía mucho. Los desarrolladores querían evitar la duplicación reutilizando clases de ensambladuras adyacentes, y como resultado, los dominios nuevamente comenzaron a vincularse entre sí. Analizamos los resultados y decidimos que, posiblemente, el problema radicaba también en la manera en que se organiza el almacenamiento del código fuente. Teníamos un gran repositorio donde estaban todos los códigos fuente. Era muy difícil construir una solución para todo el proyecto en la máquina local. Por lo tanto, se creaban soluciones pequeñas y separadas para partes del proyecto y nadie prohibía añadir una ensambladura común o de dominio y reutilizarla. La única herramienta que nos impedía hacerlo era la revisión de código. Pero a veces, incluso esta fallaba.
Entonces comenzamos a pasar a un modelo con repositorios separados. La lógica empresarial dejó de filtrarse de un servicio a otro, los dominios realmente se volvieron independientes. Los contextos delimitados se mantienen con mayor claridad. ¿Cómo reutilizamos las bibliotecas de infraestructura en este caso? Las destacamos en un repositorio separado, luego las colocamos en paquetes Nuget, que almacenamos en Artifactory. Con cualquier cambio, la ensambladura y publicación se llevan a cabo automáticamente.
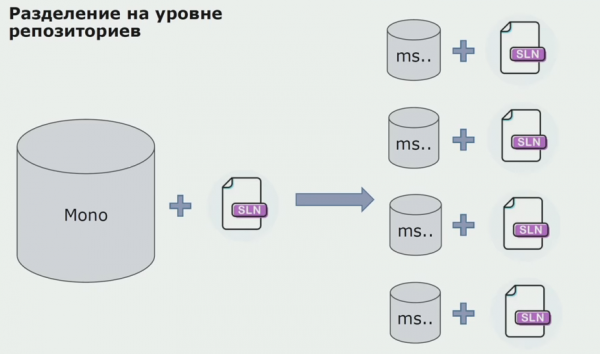
Nuestros servicios comenzaron a referirse a los paquetes de infraestructura internos de la misma manera que a los externos. Descargamos las bibliotecas externas de Nuget. Para trabajar con Artifactory, donde almacenamos estos paquetes, aplicamos dos gestores de paquetes. En pequeños repositorios también usamos Nuget. En repositorios con varios servicios, utilizamos Paket, que garantiza una mayor coherencia de versiones entre los módulos.
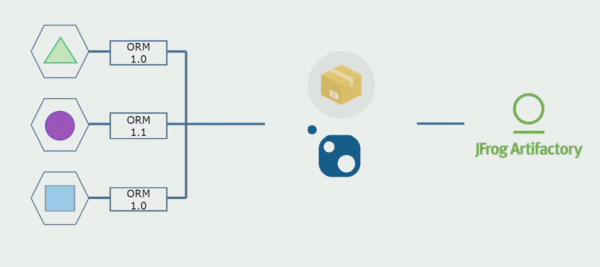
De este modo, al trabajar en el código fuente, al modificar un poco la arquitectura y dividir los repositorios, hacemos que nuestros servicios sean más independientes.
Problemas de infraestructura
La mayoría de las desventajas al pasar a microservicios están relacionadas con la infraestructura. Necesitará un despliegue automatizado y nuevas bibliotecas para la infraestructura.
Instalación manual en entornos
Inicialmente, configurábamos la solución en los entornos de manera manual. Para automatizar este proceso, creamos un pipeline de CI/CD. Elegimos el proceso de entrega continua, ya que el despliegue continuo no es viable para nosotros en términos de procesos de negocio. Por lo tanto, el envío a producción se realiza con un botón, mientras que las pruebas son automáticas.
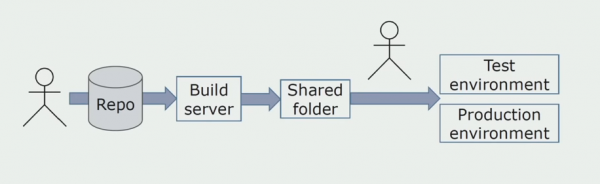
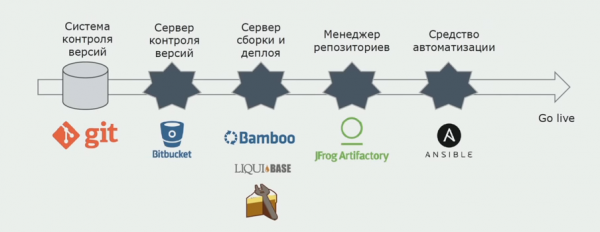
Utilizamos Atlassian, Bitbucket para almacenar los códigos fuente y Bamboo para la construcción. Nos gusta escribir scripts de construcción en Cake, porque es el mismo C#. Los paquetes listos llegan a Artifactory, y Ansible se despliega automáticamente en los servidores de prueba, donde pueden ser probados de inmediato.
Registro separado
En su momento, una de las ideas del monolito era proporcionar un registro conjunto. También necesitábamos entender qué hacer con los registros individuales que están en los discos. Los logs se escriben en archivos de texto. Decidimos utilizar la pila ELK estándar. No escribimos directamente en ELK a través de los proveedores, sino que decidimos mejorar los logs de texto y registrar los IDs de trazabilidad como un identificador, añadiendo el nombre del servicio para que esos logs pudieran ser analizados posteriormente.
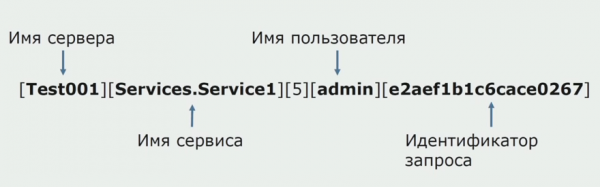
Con Filebeat tenemos la capacidad de recopilar nuestros registros desde servidores, luego transformarlos, construir consultas en la interfaz de usuario con Kibana y ver cómo fue la llamada entre los servicios. Esto se ve muy beneficiado por el ID de trazabilidad.
Pruebas y depuración de servicios relacionados
Al principio, no entendíamos completamente cómo depurar los servicios en desarrollo. Con el monolito era sencillo, lo ejecutábamos en la máquina local. Al principio, también intentamos hacer lo mismo con los microservicios, pero a veces para ejecutar un microservicio completo es necesario iniciar varios otros, lo cual es inconveniente. Nos dimos cuenta de que necesitábamos adoptar un modelo en el que dejáramos en la máquina local solo el o los servicios que queríamos depurar. Los demás servicios se utilizan desde servidores con una configuración idéntica a la de producción. Después de la depuración, en la fase de prueba, solo se despliegan los servicios modificados en el servidor de pruebas para cada tarea. De este modo, la solución se prueba tal como estará en producción en el futuro.
Hay servidores en los que solo están las versiones de producción de los servicios. Estos servidores son necesarios en caso de incidentes, para verificar la entrega antes del despliegue y para formaciones internas.
Hemos añadido un proceso de pruebas automáticas utilizando la popular biblioteca Specflow. Las pruebas se ejecutan automáticamente con NUnit justo después del despliegue desde Ansible. Si la cobertura de la tarea es completamente automática, no hay necesidad de pruebas manuales. Aunque a veces se requiere una prueba manual adicional. Para determinar qué pruebas ejecutar para una tarea específica, utilizamos etiquetas en Jira.
Además, ha crecido la necesidad de realizar pruebas de carga, que anteriormente se llevaban a cabo solo en raras ocasiones. Para ejecutar las pruebas utilizamos JMeter, para almacenarlas — InfluxDB, y para construir gráficos del proceso — Grafana.
¿Qué hemos logrado?
En primer lugar, nos hemos deshecho del concepto de "lanzamiento". Han desaparecido los monstruosos lanzamientos de dos meses, cuando esta maquinaria se desplegaba en el entorno de producción, interrumpiendo temporalmente los procesos de negocio. Ahora desplegamos servicios en promedio cada 1.5 días, agrupándolos, porque entran en producción tras su aprobación.
En nuestro sistema no hay fallos fatales. Si lanzamos un microservicio con un error, la funcionalidad relacionada se verá afectada, pero el resto de la funcionalidad no se verá perjudicada. Esto mejora significativamente la experiencia del usuario.
Podemos gestionar el esquema de implementación. Se pueden destacar grupos de servicios por separado del resto de la solución, si es necesario.
Además, hemos reducido considerablemente el problema de la gran cola de tareas pendientes. Tenemos equipos de productos separados que trabajan de manera independiente en parte de los servicios. Aquí el proceso de Scrum encaja bien. Un equipo específico puede tener un propietario de producto separado que le asigna tareas.
Currículum
- Los microservicios son adecuados para la descomposición de sistemas complejos. A través del proceso empezamos a entender lo que hay en nuestro sistema, cuáles son los contextos limitados y dónde están sus límites. Esto permite distribuir correctamente las modificaciones entre los módulos y evitar la confusión del código.
- Los microservicios ofrecen ventajas organizativas. A menudo se habla de ellos solo como una arquitectura, pero cualquier arquitectura es necesaria para satisfacer las necesidades del negocio, no por sí misma. Por lo tanto, podemos decir que los microservicios son buenos para abordar tareas con pequeños equipos, considerando que Scrum es muy popular en la actualidad.
- La separación es un proceso iterativo. No se puede tomar una aplicación y simplemente dividirla en microservicios. El producto resultante probablemente no será funcional. Al destacar los microservicios, es beneficioso reescribir el legado existente, es decir, transformarlo en un código que nos guste y que satisfaga mejor las necesidades del negocio en términos de funcionalidad y velocidad.
Una pequeña advertencia: los costos de transición a microservicios son bastante significativos. Solo resolver el problema de la infraestructura llevó mucho tiempo. Por lo tanto, si tienes una aplicación pequeña que no requiere una escalabilidad específica, y no hay un gran número de clientes compitiendo por la atención y tiempo de tu equipo, tal vez los microservicios no sean lo que necesitas hoy. Es bastante costoso. Si comienzas el proceso con microservicios, los costos iniciales serán mayores que si comenzaras el mismo proyecto con el desarrollo de un monolito.
P.D. Un relato más emocional (como si te hablara personalmente) – en .
Aquí está la versión completa de la presentación.
Fuente: habr.com
