

LINQ se introdujo en .NET como un nuevo y poderoso lenguaje para la manipulación de datos. LINQ to SQL, como parte de esto, permite interactuar de manera bastante conveniente con bases de datos utilizando, por ejemplo, Entity Framework. Sin embargo, con bastante frecuencia, los desarrolladores olvidan observar qué tipo de consulta SQL generará el proveedor queryable, en su caso, Entity Framework.
Analicemos dos puntos principales con un ejemplo.
Para esto, crearemos una base de datos Test en SQL Server, y dentro de ella, crearemos dos tablas con la siguiente consulta:
Creación de tablas
USE [TEST]
GO

SET ANSI_NULLS ON
GO

SET QUOTED_IDENTIFIER ON
GO

CREATE TABLE [dbo].[Ref](
	[ID] [int] NOT NULL,
	[ID2] [int] NOT NULL,
	[Name] [nvarchar](255) NOT NULL,
	[InsertUTCDate] [datetime] NOT NULL,
 CONSTRAINT [PK_Ref] PRIMARY KEY CLUSTERED
(
	[ID] ASC
)WITH (PAD_INDEX = OFF, STATISTICS_NORECOMPUTE = OFF, IGNORE_DUP_KEY = OFF, ALLOW_ROW_LOCKS = ON, ALLOW_PAGE_LOCKS = ON) ON [PRIMARY]
) ON [PRIMARY]
GO

ALTER TABLE [dbo].[Ref] ADD  CONSTRAINT [DF_Ref_InsertUTCDate]  DEFAULT (getutcdate()) FOR [InsertUTCDate]
GO

USE [TEST]
GO

SET ANSI_NULLS ON
GO

SET QUOTED_IDENTIFIER ON
GO

CREATE TABLE [dbo].[Customer](
	[ID] [int] NOT NULL,
	[Name] [nvarchar](255) NOT NULL,
	[Ref_ID] [int] NOT NULL,
	[InsertUTCDate] [datetime] NOT NULL,
	[Ref_ID2] [int] NOT NULL,
 CONSTRAINT [PK_Customer] PRIMARY KEY CLUSTERED
(
	[ID] ASC
)WITH (PAD_INDEX = OFF, STATISTICS_NORECOMPUTE = OFF, IGNORE_DUP_KEY = OFF, ALLOW_ROW_LOCKS = ON, ALLOW_PAGE_LOCKS = ON) ON [PRIMARY]
) ON [PRIMARY]
GO

ALTER TABLE [dbo].[Customer] ADD  CONSTRAINT [DF_Customer_Ref_ID]  DEFAULT ((0)) FOR [Ref_ID]
GO

ALTER TABLE [dbo].[Customer] ADD  CONSTRAINT [DF_Customer_InsertUTCDate]  DEFAULT (getutcdate()) FOR [InsertUTCDate]
GO
Ahora llenaremos la tabla Ref ejecutando el siguiente script:
Llenado de la tabla Ref
USE [TEST]
GO

DECLARE @ind INT=1;

WHILE(@ind<1200000)
BEGIN
	INSERT INTO [dbo].[Ref]
           ([ID]
           ,[ID2]
           ,[Name])
    SELECT
           @ind
           ,@ind
           ,CAST(@ind AS NVARCHAR(255));

	SET @ind=@ind+1;
END
GO
De manera similar, llenaremos la tabla Customer utilizando el siguiente script:
Llenado de la tabla Customer
USE [TEST]
GO

DECLARE @ind INT=1;
DECLARE @ind_ref INT=1;

WHILE(@ind<=12000000)
BEGIN
	IF(@ind%3=0) SET @ind_ref=1;
	ELSE IF (@ind%5=0) SET @ind_ref=2;
	ELSE IF (@ind%7=0) SET @ind_ref=3;
	ELSE IF (@ind=0) SET @ind_ref=4;
	ELSE IF (@ind=0) SET @ind_ref=5;
	ELSE IF (@ind=0) SET @ind_ref=6;
	ELSE IF (@ind=0) SET @ind_ref=7;
	ELSE IF (@ind=0) SET @ind_ref=8;
	ELSE IF (@ind=0) SET @ind_ref=9;
	ELSE IF (@ind=0) SET @ind_ref=10;
	ELSE IF (@ind=0) SET @ind_ref=11;
	ELSE SET @ind_ref=@ind90000;

	INSERT INTO [dbo].[Customer]
	 ([ID]
	 ,[Name]
	 ,[Ref_ID]
	 ,[Ref_ID2])
	 SELECT
	 @ind,
	 CAST(@ind AS NVARCHAR(255)),
	 @ind_ref,
	 @ind_ref;


	SET @ind=@ind+1;
END
GO
De este modo, hemos obtenido dos tablas, una de las cuales tiene más de 1 millón de filas de datos, y la otra más de 10 millones de filas de datos.
Ahora en Visual Studio es necesario crear un proyecto de prueba Visual C# Console App (.NET Framework):
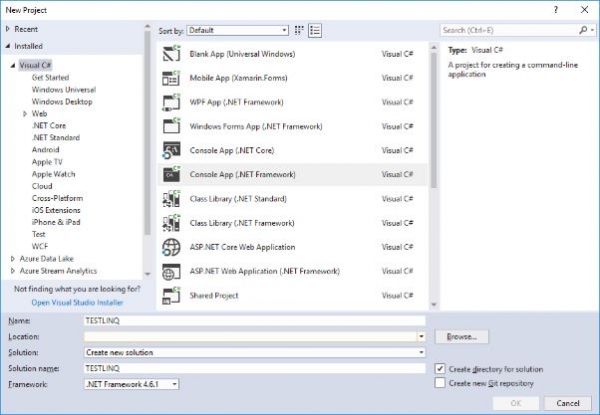
A continuación, es necesario agregar la biblioteca para Entity Framework para interactuar con la base de datos.
Para añadirlo, haremos clic derecho en el proyecto y elegiremos en el menú contextual Administrar paquetes NuGet:
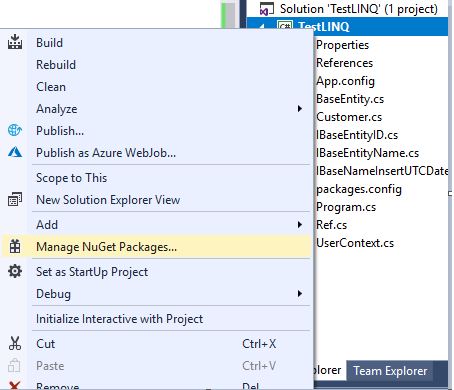
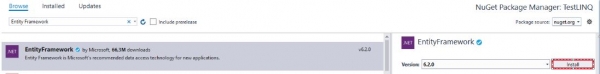
Luego, en la ventana de administración de paquetes NuGet que aparece, escribimos la palabra «Entity Framework» en la barra de búsqueda, seleccionamos el paquete Entity Framework y lo instalamos:
Después, en el archivo App.config, tras cerrar el elemento configSections, debemos agregar el siguiente bloque:
En connectionString, se debe escribir la cadena de conexión.
Ahora, crearemos 3 interfaces en archivos separados:
- Implementación de la interfaz IBaseEntityID
namespace TestLINQ { public interface IBaseEntityID { int ID { get; set; } } } - Implementación de la interfaz IBaseEntityName
namespace TestLINQ { public interface IBaseEntityName { string Name { get; set; } } } - Implementación de la interfaz IBaseNameInsertUTCDate
namespace TestLINQ
{
    public interface IBaseNameInsertUTCDate
    {
        DateTime InsertUTCDate { get; set; }
    }
}
Y en un archivo separado, crearemos la clase base BaseEntity para nuestras dos entidades, que incluirá los campos comunes:
Implementación de la clase base BaseEntity
namespace TestLINQ
{
    public class BaseEntity : IBaseEntityID, IBaseEntityName, IBaseNameInsertUTCDate
    {
        public int ID { get; set; }
        public string Name { get; set; }
        public DateTime InsertUTCDate { get; set; }
    }
}
Luego, en archivos separados, crearemos nuestras dos entidades:
- Implementación de la clase Ref
using System.ComponentModel.DataAnnotations.Schema; namespace TestLINQ { [Table("Ref")] public class Ref : BaseEntity { public int ID2 { get; set; } } } - Implementación de la clase Customer
using System.ComponentModel.DataAnnotations.Schema;

namespace TestLINQ
{
    [Table("Customer")]
    public class Customer : BaseEntity
    {
        public int Ref_ID { get; set; }
        public int Ref_ID2 { get; set; }
    }
}
Ahora, crearemos el contexto UserContext en un archivo separado:
Implementación de la clase UserContext
using System.Data.Entity;

namespace TestLINQ
{
    public class UserContext : DbContext
    {
        public UserContext()
            : base("DbConnection")
        {
            Database.SetInitializer(null);
        }

        public DbSet Customer { get; set; }
        public DbSet Ref { get; set; }
    }
}
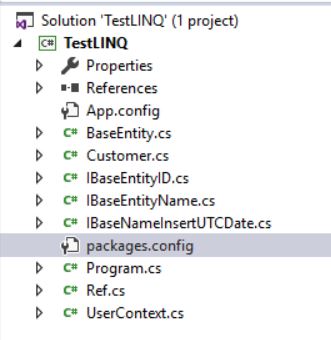
Hemos obtenido una solución lista para realizar pruebas de optimización con LINQ to SQL a través de EF para MS SQL Server:
Ahora en el archivo Program.cs introduciremos el siguiente código:
Archivo Program.cs
usando System;
usando System.Collections.Generic;
usando System.Linq;

namespace TestLINQ
{
    clase Programa
    {
        estático void Main(string[] args)
        {
            usando (UserContext db = new UserContext())
            {
                var dblog = new List();
                db.Database.Log = dblog.Add;

                var query = from e1 in db.Customer
                            from e2 in db.Ref
                            donde (e1.Ref_ID == e2.ID)
                                 && (e1.Ref_ID2 == e2.ID2)
                            seleccionar nuevo { Data1 = e1.Name, Data2 = e2.Name };

                var result = query.Take(1000).ToList();

                Console.WriteLine(dblog[1]);

                Console.ReadKey();
            }
        }
    }
}
A continuación, ejecutaremos nuestro proyecto.
Al final de la ejecución, se mostrará en la consola:
Consulta SQL generada
SELECT TOP (1000)
    [Extent1].[Ref_ID] AS [Ref_ID],
    [Extent1].[Name] AS [Name],
    [Extent2].[Name] AS [Name1]
    FROM  [dbo].[Customer] AS [Extent1]
    INNER JOIN [dbo].[Ref] AS [Extent2] ON ([Extent1].[Ref_ID] = [Extent2].[ID]) AND ([Extent1].[Ref_ID2] = [Extent2].[ID2])
Es decir, en general, la consulta LINQ generó bastante bien la consulta SQL para el SGBD MS SQL Server.
Ahora cambiemos la condición de Y a O en la consulta LINQ:
Consulta LINQ
var query = from e1 in db.Customer
                            from e2 in db.Ref
                            donde (e1.Ref_ID == e2.ID)
                                || (e1.Ref_ID2 == e2.ID2)
                            seleccionar nuevo { Data1 = e1.Name, Data2 = e2.Name };
Y nuevamente ejecutamos nuestra aplicación.
La ejecución fallará con un error relacionado con el tiempo de espera de comando de 30 segundos:
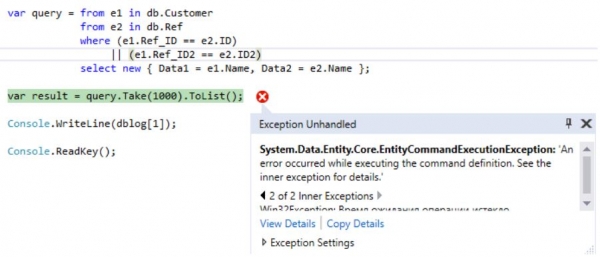
Si miramos qué consulta se generó con LINQ:
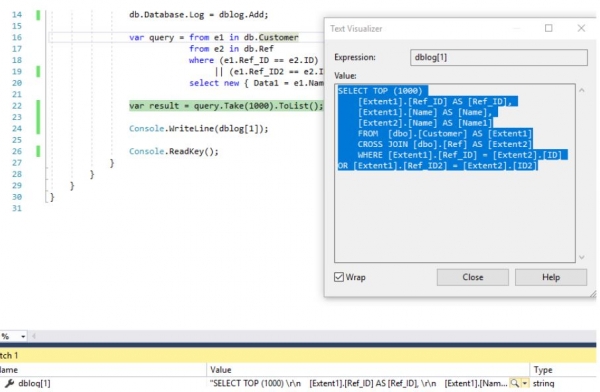
, podemos darnos cuenta de que la selección se realiza a través del producto cartesiano de dos conjuntos (tablas):
Consulta SQL generada
SELECT TOP (1000)
    [Extent1].[Ref_ID] AS [Ref_ID],
    [Extent1].[Name] AS [Name],
    [Extent2].[Name] AS [Name1]
    FROM  [dbo].[Customer] AS [Extent1]
    CROSS JOIN [dbo].[Ref] AS [Extent2]
    WHERE [Extent1].[Ref_ID] = [Extent2].[ID] OR [Extent1].[Ref_ID2] = [Extent2].[ID2]
Reescribamos la consulta LINQ de la siguiente manera:
Consulta LINQ optimizada
var query = (from e1 in db.Customer
                   join e2 in db.Ref
                   on e1.Ref_ID equals e2.ID
                   seleccionar nuevo { Data1 = e1.Name, Data2 = e2.Name }).Union(
                        from e1 in db.Customer
                        join e2 in db.Ref
                        on e1.Ref_ID2 equals e2.ID2
                        seleccionar nuevo { Data1 = e1.Name, Data2 = e2.Name });
Entonces obtendremos la siguiente consulta SQL:
Consulta SQL
SELECCIONAR
    [Limit1].[C1] COMO [C1],
    [Limit1].[C2] COMO [C2],
    [Limit1].[C3] COMO [C3]
    DE ( SELECCIONAR DISTINTO TOP (1000)
        [UnionAll1].[C1] COMO [C1],
        [UnionAll1].[Name] COMO [C2],
        [UnionAll1].[Name1] COMO [C3]
        DE  (SELECCIONAR
            1 COMO [C1],
            [Extent1].[Name] COMO [Name],
            [Extent2].[Name] COMO [Name1]
            DE  [dbo].[Customer] COMO [Extent1]
            UNIR INTERNO [dbo].[Ref] COMO [Extent2] EN [Extent1].[Ref_ID] = [Extent2].[ID]
        UNION ALL
            SELECCIONAR
            1 COMO [C1],
            [Extent3].[Name] COMO [Name],
            [Extent4].[Name] COMO [Name1]
            DE  [dbo].[Customer] COMO [Extent3]
            UNIR INTERNO [dbo].[Ref] COMO [Extent4] EN [Extent3].[Ref_ID2] = [Extent4].[ID2]) COMO [UnionAll1]
    )  COMO [Limit1]
Lamentablemente, en las consultas LINQ, solo puede haber una condición de unión, por lo que aquí es posible hacer una consulta equivalente mediante dos consultas para cada condición, combinándolas luego a través de Union para eliminar duplicados entre las filas.
Sí, las consultas en términos generales resultarán no equivalentes, dado que se pueden devolver duplicados completos de filas. Sin embargo, en la vida real, las filas duplicadas completas no son necesarias y se intenta deshacerse de ellas.
Ahora comparemos los planes de ejecución de estas dos consultas:
- para CROSS JOIN el tiempo de ejecución promedio es de 195 seg:

- para INNER JOIN-UNION el tiempo de ejecución promedio es de menos de 24 seg:

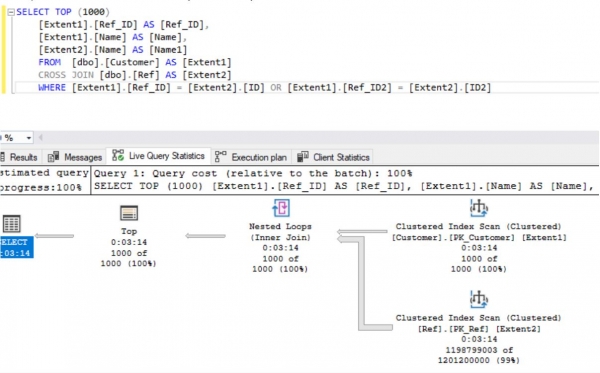
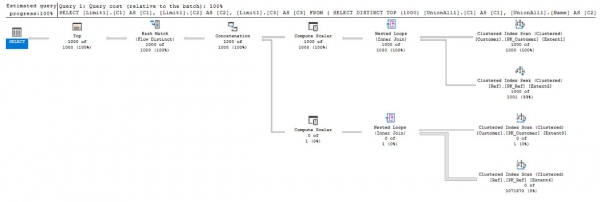
Como se puede ver en los resultados, para dos tablas con millones de registros, la consulta LINQ optimizada funciona varias veces más rápido que la no optimizada.
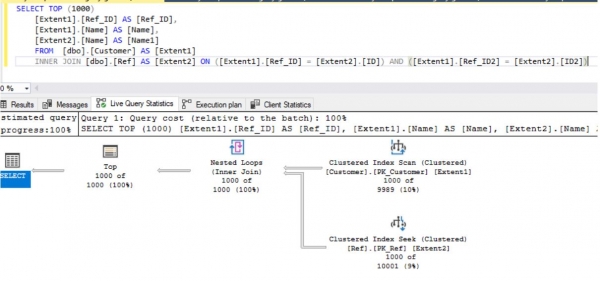
Para la variante con AND en las condiciones, la consulta LINQ sería:
Consulta LINQ
var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                 && (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };
casi siempre se generará una consulta SQL correcta, que se ejecutará en un promedio de aproximadamente 1 seg:
También, para manipulaciones LINQ to Objects en lugar de la consulta de tipo:
Consulta LINQ (1ª variante)
var query = from e1 in seq1
                            from e2 in seq2
                            where (e1.Key1==e2.Key1)
                               && (e1.Key2==e2.Key2)
                            select new { Data1 = e1.Data, Data2 = e2.Data };
se puede usar una consulta de tipo:
Consulta LINQ (2ª variante)
var query = from e1 in seq1
                            join e2 in seq2
                            on new { e1.Key1, e1.Key2 } equals new { e2.Key1, e2.Key2 }
                            select new { Data1 = e1.Data, Data2 = e2.Data };
donde:
Definición de dos arreglos
Para[] seq1 = new[] { new Para { Key1 = 1, Key2 = 2, Data = "777" }, new Para { Key1 = 2, Key2 = 3, Data = "888" }, new Para { Key1 = 3, Key2 = 4, Data = "999" } };
Para[] seq2 = new[] { new Para { Key1 = 1, Key2 = 2, Data = "777" }, new Para { Key1 = 2, Key2 = 3, Data = "888" }, new Para { Key1 = 3, Key2 = 5, Data = "999" } };
, y el tipo Para se define de la siguiente manera:
Definición del tipo Para
clase Para
{
        public int Clave1, Clave2;
        public string Datos;
}
Así, hemos considerado algunos aspectos en la optimización de las consultas LINQ a MS SQL Server.
Desafortunadamente, incluso los desarrolladores de .NET más experimentados a veces olvidan que es crucial entender lo que ocurre detrás de las instrucciones que utilizan. De lo contrario, se convierten en configuradores y pueden colocar una bomba de tiempo en el futuro, tanto al escalar la solución de software como al hacer cambios menores en las condiciones externas del entorno.
También se realizó una breve revisión y .
Los archivos fuente para la prueba: el proyecto, la creación de tablas en la base de datos TEST, así como la carga de datos en estas tablas se encuentra .
También en este repositorio, en la carpeta Plans, se encuentran los planes para ejecutar consultas con condiciones O.
Fuente: habr.com
