

3. Opciones de estructuras al utilizar globales
Una estructura como un árbol ordenado tiene varios casos particulares. Analicemos los que tienen valor práctico al trabajar con globales.
3.1 Caso particular 1. Un nodo sin ramas
 Los globales se pueden utilizar no solo como un arreglo, sino también como variables normales. Por ejemplo, como un contador:
Set ^counter = 0  ; establecer el contador
Set id=$Increment(^counter) ;  incremento atómico
En este caso, un global, además del valor, también puede tener ramas. Uno no excluye al otro.
3.2 Caso particular 2. Un vértice y múltiples ramas
En general, se trata de una base de datos clásica de clave-valor. Y si guardamos una tupla de valores como valor, obtendremos una tabla común con una clave primaria.
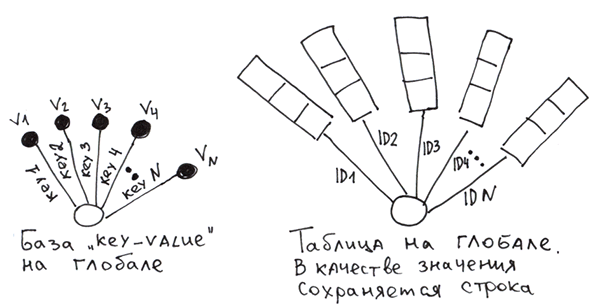
Para implementar la tabla en globales, deberemos formar las filas a partir de los valores de las columnas y luego guardarlas en el global por clave primaria. Para que al leer se pueda dividir la fila nuevamente en columnas, se pueden usar:
- símbolos separadores.
Set ^t(id1) = "col11/col21/col31" Set ^t(id2) = "col12/col22/col32" - un esquema rígido, donde cada campo ocupa un número de bytes previamente definido. Como se hace en bases de datos relacionales.
- una función especial $LB (disponible en Cache), que construye una cadena a partir de valores.
Set ^t(id1) = $LB("col11", "col21", "col31")
Set ^t(id2) = $LB("col12", "col22", "col32")
Curiosamente, no es difícil en globales hacer algo parecido a los índices secundarios en bases de datos relacionales. Llamaremos a estas estructuras globales indexadas. Un global indexado es un árbol auxiliar para búsqueda rápida por campos que no son partes compuestas de la clave primaria del global principal. Para llenarlo y usarlo, hay que escribir código adicional.
Creemos un global indexado por la primera columna.
Set ^i("col11", id1) = 1
Set ^i("col12", id2) = 1
Ahora, para buscar rápidamente información en la primera columna, debemos mirar en el global ^i y encontrar las claves primarias (id) que corresponden al valor deseado de la primera columna.
Al insertar un valor, podemos crear tanto el valor como los globales indexados para los campos necesarios de inmediato. Y para mayor seguridad, envolveremos todo en una transacción.
TSTART
Set ^t(id1) = $LB("col11", "col21", "col31")
Set ^i("col11", id1) = 1
TCOMMIT
Detalles sobre cómo hacer en M , .
Las tablas funcionarán con la misma rapidez que en bases de datos tradicionales (o incluso más rápido), si las funciones de inserción/actualización/eliminación de filas se escriben en COS/M y se compilan.He comprobado esta afirmación con pruebas de inserciones masivas y selecciones en una tabla de dos columnas, incluyendo el uso de comandos TSTART y TCOMMIT (transacciones).
No he probado escenarios más complejos con acceso concurrente y transacciones paralelas.
Sin usar transacciones, la velocidad de inserciones fue de 778,361 inserciones/segundo para un millón de valores.
Con 300 millones de valores — 422,141 inserciones/segundo.
Al usar transacciones — 572,082 inserciones/segundo para 50M de inserciones. Todas las operaciones se realizaron desde código M compilado.
Los discos duros son normales, no SSD. RAID5 con Write-back. Procesador Phenom II 1100T.
Para pruebas similares en una base de datos SQL, se necesita escribir un procedimiento almacenado que realice inserciones en un bucle. Al probar MySQL 5.5 (almacenamiento InnoDB), obtuve cifras no mayores a 11K inserciones por segundo con este método.
Sí, la implementación de tablas en globales parece más compleja que en bases de datos relacionales. Por eso, las bases de datos industriales en globales tienen acceso SQL para simplificar el trabajo con datos tabulares.
 En general, si el esquema de datos no cambiará con frecuencia, la velocidad de inserción no es crítica y toda la base se puede representar fácilmente en forma de tablas normalizadas, es más sencillo trabajar con SQL, ya que proporciona un nivel de abstracción más alto.
 En este caso particular, quería mostrar que los globales pueden funcionar como un constructor para la creación de otras bases de datos. Como un ensamblador, en el que se pueden escribir otros lenguajes. Y aquí hay ejemplos de cómo se pueden crear en globales análogos a
Si necesitas crear algún tipo de base de datos no estándar con un esfuerzo mínimo, vale la pena mirar hacia los globales.
3.3 Caso particular 3. Árbol de dos niveles, cada nodo de segundo nivel tiene un número fijo de ramas.
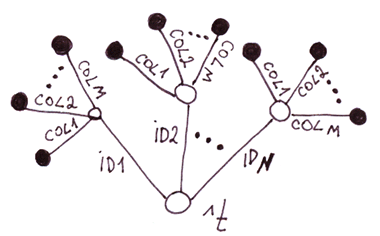 Probablemente adivinaste: esta es una implementación alternativa de tablas en globales. Compararemos esta implementación con la anterior.
Tablas en árbol de dos niveles vs. en árbol de un nivel.
Desventajas
Ventajas
- Más lentas en inserciones, ya que se debe establecer el número de nodos igual al número de columnas.
- Mayor consumo de espacio en disco. Dado que los índices globales (en el sentido de índices en arreglos) con los nombres de las columnas ocupan espacio en disco y se duplican para cada fila.
- Acceso más rápido a los valores de columnas individuales, ya que no es necesario analizar la fila. Según mis pruebas, es un 11.5% más rápido en 2 columnas y aún más con un mayor número de columnas.
- Más fácil cambiar el esquema de datos
- Código más claro
Salida: depende del gusto. Dado que la velocidad es una de las principales ventajas de los globales, prácticamente no tiene sentido utilizar esta implementación, ya que probablemente funcionará no más rápido que las tablas en bases de datos relacionales.
3.4 Caso general. Árboles y árboles ordenados
Cualquier estructura de datos que puede representarse como un árbol se adapta perfectamente a los globales.
3.4.1 Objetos con subobjetos
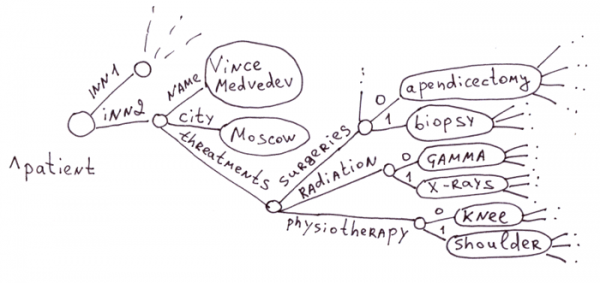
Este es el área de aplicación tradicional de los globales. En el ámbito médico hay un gran número de enfermedades, medicamentos, síntomas y métodos de tratamiento. Crear una tabla con un millón de campos para cada paciente no es racional. Más aún, el 99% de los campos estarán vacíos.
Imagina una base de datos SQL con tablas: "paciente" ~ 100,000 campos, "medicamento" — 100,000 campos, "terapia" — 100,000 campos, "complicaciones" — 100,000 campos, etc. O se puede crear una base de datos con miles de tablas, cada una para un tipo específico de paciente (y es que pueden cruzarse), tratamientos, medicamentos, y miles de tablas más para las relaciones entre ellas.
Los globales son perfectos para la medicina, ya que permiten crear una descripción precisa de la historia clínica de cada paciente, diversas terapias, acciones de medicamentos, en forma de árbol, sin desperdiciar espacio en disco en columnas vacías, como sería en el caso relacional.
 Es conveniente hacer bases de datos sobre personas con globales, cuando es importante acumular y sistematizar la máxima variedad de información sobre el cliente. Esto es muy demandado en medicina, sector bancario, marketing, archivística y otras áreas.
.
Sin duda, también se puede emular un árbol en SQL con solo unas pocas tablas (, ,,,,,,,,,), sin embargo, esto es significativamente más complicado y funcionará más lentamente. En esencia, habría que escribir un global que funcione en tablas y ocultar todo el trabajo con tablas bajo una capa de abstracción. No es correcto emular una tecnología de nivel inferior (globales) con herramientas de nivel superior (SQL). No es práctico.
No es un secreto que cambiar el esquema de datos en tablas gigantes (ALTER TABLE) puede llevar un tiempo considerable. MySQL, por ejemplo, realiza ALTER TABLE ADD|DROP COLUMN copiando toda la información de la tabla antigua a la nueva (he probado los motores MyISAM, InnoDB). Esto puede colapsar una base de datos en funcionamiento con miles de millones de registros durante días, si no semanas.
 Cambiar la estructura de datos, si usamos globales, no nos cuesta nada. En cualquier momento podemos añadir nuevas propiedades que necesitemos a cualquier objeto, en cualquier nivel de la jerarquía. Los cambios relacionados con el renombrado de ramas se pueden ejecutar en segundo plano en una base de datos activa.
Por lo tanto, cuando se trata de almacenar objetos con una gran cantidad de propiedades opcionales, los globales son una excelente opción.
Además, recuerdo que el acceso a cualquiera de las propiedades es instantáneo, ya que en los globales todos los caminos son B-tree.
Las bases de datos en globales, en general, son una variedad de bases de datos orientadas a documentos, con la capacidad de almacenar información jerárquica. Por lo tanto, en el ámbito del almacenamiento de historiales médicos, los globales pueden competir con las bases de datos orientadas a documentos. Pero aún así, no es exactamente lo mismoTomemos como comparación, por ejemplo, MongoDB. En este ámbito pierde ante los globales por las siguientes razones:
- Tamaño del documento. La unidad de almacenamiento es un texto en formato JSON (más precisamente BSON) con un tamaño máximo de alrededor de 16MB. Esta limitación se estableció intencionadamente para que la base de datos JSON no se ralentizara al analizar, si se guarda un documento JSON enorme, y luego se accede a él por campos. En este documento debe concentrarse toda la información del paciente. Todos sabemos lo gruesos que pueden ser los historiales de pacientes. El tamaño máximo del historial de 16MB hace que sea inviable para pacientes cuyos historiales de enfermedades incluyan archivos de IRM, escaneos de rayos X y otras investigaciones. En una rama de un global se puede tener información en gigabytes y terabytes. En principio, esto podría ser el final, pero continuaré.
- El tiempo de conciencia/cambio/eliminación de nuevas propiedades en el mapa del paciente. Esta base de datos debe cargar toda la carta en memoria (¡es un gran volumen!), analizar BSON, agregar/modificar/eliminar un nuevo nodo, actualizar los índices, empaquetar en BSON y guardar en el disco. A la global le basta con acceder a una propiedad específica y realizar manipulaciones con ella.
- La rapidez de acceso a propiedades individuales. Con muchas propiedades en el documento y su estructura jerárquica, el acceso a propiedades individuales será más rápido dado que cada ruta en la global es un B-tree. En BSON, tendrá que analizar el documento linealmente para encontrar la propiedad deseada.
3.3.2 Arreglos asociativos
Los arreglos asociativos (incluso con arreglos anidados) se ajustan perfectamente a las globales. Por ejemplo, este arreglo de PHP se mostrará en la primera imagen 3.3.1.
$a = array(
  "name" => "Vince Medvedev",
  "city" => "Moscú",
  "treatments" => array(
    "surgeries" => array("apedicectomía", "biopsia"),
    "radiation" => array("gamma", "rayos-X"),
    "physiotherapy" => array("rodilla", "hombro")
  )
);
3.3.3 Documentos jerárquicos: XML, JSON
También se almacenan fácilmente en globales. Para el almacenamiento, se pueden desglosar de varias maneras.
XML
La forma más simple de desglosar XML en globales es cuando almacenamos los atributos de las etiquetas en los nodos. Si se requiere un acceso rápido a los atributos de las etiquetas, podemos sacarlos a ramas separadas.
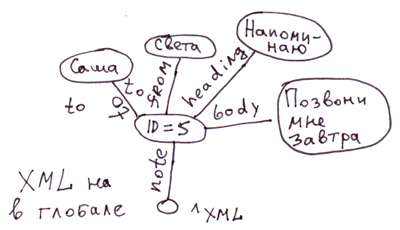
<note id="5">
<to>Vasya</to>
<from>Sveta</from>
<heading>Recordatorio</heading>
<body>¡Llámame mañana!</body>
</note>
En COS, esto correspondería al código:
Set ^xml("note")="id=5"
Set ^xml("note","to")="Sasha"
Set ^xml("note","from")="Sveta"
Set ^xml("note","heading")="Recordatorio"
Set ^xml("note","body")="¡Llama me mañana!"
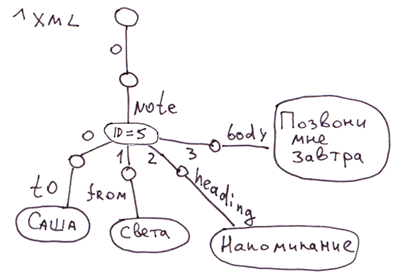
Nota: Para XML, JSON, y arreglos asociativos se pueden idear muchas formas diferentes de representación en globales. En este caso, no reflejamos el orden de las etiquetas anidadas en la etiqueta note. En la global ^xml las etiquetas anidadas se mostrarán en orden alfabético. Para reflejar estrictamente el orden, se puede utilizar, por ejemplo, esta representación:
JSON.
En la primera imagen del apartado 3.3.1 se muestra la representación de este documento JSON:
var document = {
  "name": "Vince Medvedev",
  "city": "Moscú",
  "treatments": {
    "surgeries": ["apedicectomía", "biopsia"],
    "radiation": ["gamma", "rayos-X"],
    "physiotherapy": ["rodilla", "hombro"]
  },
};
3.3.4 Estructuras idénticas, relacionadas por relaciones jerárquicas
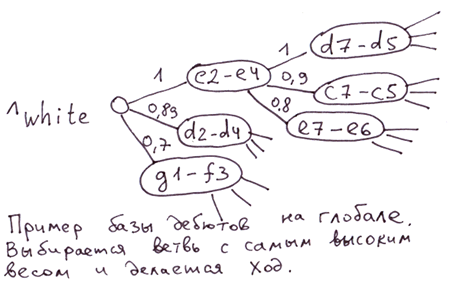
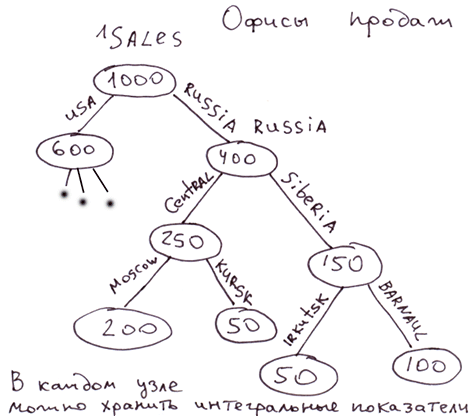
Ejemplos: estructura de oficinas de ventas, ubicación de personas en una estructura MLM, base de aperturas en ajedrez.
Base de aperturas. Se puede usar la evaluación de la fuerza del movimiento como valor del índice del nodo global. Entonces, para elegir el movimiento más fuerte, solo será necesario seleccionar la rama con el peso más alto. En el global, todas las ramas en cada nivel estarán ordenadas por la fuerza del movimiento.
La estructura de las oficinas de ventas, la estructura de las personas en MLM. En los nodos se pueden almacenar ciertos valores en caché que reflejan las características de todo el subárbol. Por ejemplo, el volumen de ventas de dicho subárbol. En cualquier momento, podemos obtener una cifra que refleje los logros de cualquier rama.
4. En qué casos es más beneficioso utilizar globals.
En la primera columna se presentan los casos en los que obtendrás una ganancia significativa en velocidad al usar globals, y en la segunda cuando la programación o el modelo de datos se simplificará.
Velocidad
Facilidad de procesamiento/presentación de datos.
- Inserción [con clasificación automática en cada nivel], [indexación por clave principal].
- Eliminación de subárboles.
- Objetos con una gran cantidad de propiedades anidadas, que requieren acceso individual.
- Estructura jerárquica con posibilidad de recorrer ramas hijas desde cualquier nodo, incluso si no existe.
- Recorrido de subárboles en profundidad.
- Objetos/entidades con una enorme cantidad de propiedades/entidades opcionales [y/o anidadas].
- Datos sin esquema (sin esquema). Cuando pueden aparecer con frecuencia nuevas propiedades y desaparecer las antiguas.
- Es necesario crear una base de datos no estándar.
- Bases de rutas y árboles de decisiones. Cuando es conveniente representar rutas en forma de árbol.
- Eliminación de estructuras jerárquicas sin utilizar recursión.
Continuación .
Descargo de responsabilidad: Este artículo y mis comentarios al respecto son mi opinión personal y no representan la posición oficial de la corporación InterSystems.
Fuente: habr.com
