

¿Cómo multiplicar por diez la cantidad de consultas a la base de datos sin trasladarse a un servidor más potente y manteniendo la operatividad del sistema? Te contaré cómo luchamos contra la caída del rendimiento de nuestra base de datos, cómo optimizamos las consultas SQL para atender al mayor número posible de usuarios y sin aumentar los costos de recursos computacionales.
Estoy desarrollando un servicio para la gestión de procesos empresariales en empresas de construcción. Con nosotros colaboran alrededor de 3 mil compañías. Más de 10 mil personas trabajan cada día con nuestro sistema de 4 a 10 horas. Resuelve diversas tareas de planificación, notificación, alertas, validación… Utilizamos PostgreSQL 9.6. En la base de datos tenemos alrededor de 300 tablas y cada día recibe hasta 200 millones de consultas (10 mil diferentes). En promedio, tenemos entre 3 y 4 mil consultas por segundo, y en los momentos más álgidos, más de 10 mil consultas por segundo. La mayor parte de las consultas son OLAP. Las adiciones, modificaciones y eliminaciones son considerablemente menos, es decir, la carga de OLTP es relativamente pequeña. Todas estas cifras las he presentado para que puedas evaluar la magnitud de nuestro proyecto y entender cuán útil puede ser nuestra experiencia para ti.
Cuadro primero. Lírico
Cuando comenzamos el desarrollo, no pensamos mucho en cuánta carga recaería sobre la base de datos y qué haríamos si el servidor no pudiera soportarlo. Al diseñar la base de datos, seguimos recomendaciones generales y tratamos de no dispararnos en el pie, pero más allá de consejos generales como “no uses el patrón no profundizamos. Diseñamos basándonos en principios de normalización, evitando la redundancia de datos y no nos preocupamos por acelerar ciertas consultas. Una vez que llegaron los primeros usuarios, nos enfrentamos al problema del rendimiento. Como suele suceder, estábamos completamente despreparados para esto. Los primeros problemas resultaron ser simples. Generalmente, se resolvían añadiendo un nuevo índice. Pero llegó un momento en que las soluciones simples dejaron de funcionar. Al darnos cuenta de que nos faltaba experiencia y que nos costaba cada vez más comprender la causa de los problemas, contratamos a especialistas que nos ayudaron a configurar correctamente el servidor, conectar el monitoreo y nos mostraron dónde mirar para obtener. .
Cuadro segundo. Estadístico
Tenemos alrededor de 10,000 consultas diferentes que se ejecutan en nuestra base de datos diariamente. De estas 10,000, hay monstruos que se ejecutan 2-3 millones de veces con un tiempo promedio de ejecución de 0.1-0.3 ms, y hay consultas con un tiempo promedio de ejecución de 30 segundos, que se llaman 100 veces al día.
Optimizar las 10,000 consultas no era posible, así que decidimos averiguar hacia dónde dirigir nuestros esfuerzos para mejorar el rendimiento de la base de datos de manera efectiva. Después de varias iteraciones, comenzamos a clasificar las consultas por tipo.
Consultas TOP
Estas son las consultas más pesadas, que consumen más tiempo (tiempo total). Son consultas que o se llaman con mucha frecuencia o que tardan mucho en ejecutarse (las consultas lentas y frecuentes ya fueron optimizadas en las primeras iteraciones para mejorar la velocidad). En total, el servidor dedica más tiempo a ejecutarlas. Además, es importante diferenciar las consultas top por el tiempo total de ejecución y por el tiempo de I/O. Los métodos de optimización para estas consultas son un poco diferentes.
La práctica común de todas las empresas es trabajar con las consultas TOP. Son pocas, y la optimización de una sola consulta puede liberar entre el 5% y el 10% de los recursos. Sin embargo, a medida que el proyecto 'madura', la optimización de las consultas TOP se convierte en una tarea cada vez más no trivial. Todos los métodos simples ya se han probado, y el ‘más pesado’ de los pedidos consume ‘solo’ entre el 3% y el 5% de los recursos. Si las consultas TOP en conjunto ocupan menos del 30%-40% del tiempo, lo más probable es que ya haya hecho esfuerzos para que trabajen rápido y ha llegado el momento de pasar a la optimización de las consultas del siguiente grupo.
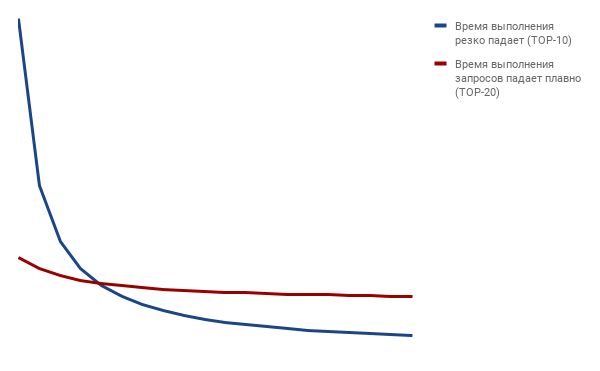
Queda por responder cuántas consultas superiores incluir en este grupo. Generalmente tomo no menos de 10, pero no más de 20. Intento que el tiempo de la primera y la última consulta en el grupo TOP no difiera más de 10 veces. Es decir, si el tiempo de ejecución de las consultas cae drásticamente del primer lugar al décimo, elijo TOP-10; si la caída es más gradual, aumento el tamaño del grupo a 15 o 20.
Medianos (medium)
Estas son todas las consultas que vienen justo después de las CONSULTAS TOP, excepto las últimas 5-10%. Generalmente, la oportunidad de aumentar significativamente el rendimiento del servidor radica en la optimización de estas consultas. Pueden representar hasta el 80%. Pero incluso si su cuota supera el 50%, es hora de mirarlas más de cerca.
Cola (tail)
Como se mencionó, estas consultas se llevan a cabo al final y ocupan del 5 al 10% del tiempo. Se pueden olvidar, a menos que utilices herramientas automáticas de análisis de consultas, ya que su optimización también puede ser económica.
¿Cómo evaluar cada grupo?
Utilizo una consulta SQL que ayuda a hacer esta evaluación para PostgreSQL (estoy seguro de que se puede escribir una consulta similar para muchos otros SGBD).
Consulta SQL para evaluar el tamaño de los grupos TOP-MEDIUM-TAIL
SELECT sum(time_top) AS sum_top, sum(time_medium) AS sum_medium, sum(time_tail) AS sum_tail
FROM
(
  SELECT CASE WHEN rn  20 AND rn  800 THEN tt_percent ELSE 0 END AS time_tail
  FROM (
    SELECT total_time / (SELECT sum(total_time) FROM pg_stat_statements) * 100 AS tt_percent, query,
    ROW_NUMBER () OVER (ORDER BY total_time DESC) AS rn
    FROM pg_stat_statements
    ORDER BY total_time DESC
  ) AS t
)
AS ts
El resultado de la consulta son tres columnas, cada una de las cuales contiene el porcentaje de tiempo dedicado al procesamiento de las consultas de ese grupo. Dentro de la consulta hay dos números (en mi caso 20 y 800) que separan las consultas de un grupo de las de otro.
Así es como se relacionan aproximadamente las proporciones de consultas en el momento del inicio de la optimización y ahora.
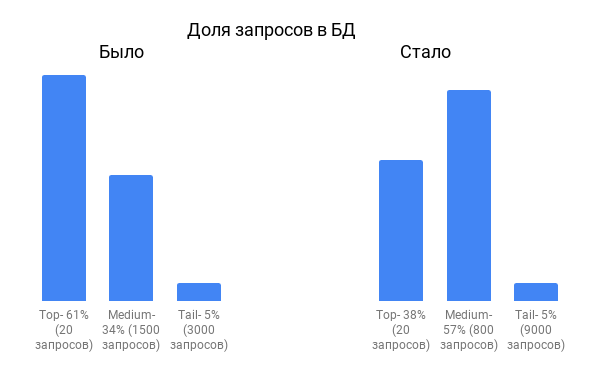
En el diagrama se puede ver que la proporción de consultas TOP ha disminuido drásticamente, mientras que han aumentado las de ‘media’.
Al principio, en las consultas TOP había errores evidentes. Con el tiempo, los problemas iniciales desaparecieron, la proporción de consultas TOP se redujo, y se requerían cada vez más esfuerzos para acelerar las consultas pesadas.
Para obtener el texto de las consultas, utilizamos la siguiente consulta
SELECT * FROM (
  SELECT ROW_NUMBER () OVER (ORDER BY total_time DESC) AS rn, total_time / (SELECT sum(total_time) FROM pg_stat_statements) * 100 AS tt_percent, query
  FROM pg_stat_statements
  ORDER BY total_time DESC
) AS T
WHERE
rn  20 AND rn  800  -- TAIL
Aquí está la lista de las técnicas más utilizadas que nos ayudaron a acelerar las consultas TOP:
- Rediseño del sistema, por ejemplo, reestructuración de la lógica de notificaciones en un message broker en lugar de consultas periódicas a la base de datos.
- Adición o modificación de índices.
- Reescritura de consultas ORM a SQL puro.
- Reescritura de la lógica de carga diferida de datos.
- Caché a través de la denormalización de datos. Por ejemplo, tenemos una relación de tablas Entrega -> Factura -> Consulta -> Solicitud. Es decir, cada entrega está relacionada con una solicitud a través de otras tablas. Para evitar vincular todas las tablas en cada consulta, duplicamos la referencia a la solicitud en la tabla Entrega.
- Cache de tablas estáticas con diccionarios y tablas que cambian raramente en la memoria del programa.
A veces, los cambios requerían un rediseño considerable, pero proporcionaban una descarga del sistema del 5-10% y eran justificados. Con el tiempo, la mejora se hacía cada vez menor y el rediseño requería ser más serio.
Entonces, prestamos atención al segundo grupo de consultas: el grupo de los intermedios. Había muchas más consultas en este grupo y parecía que el análisis de todo el grupo llevaría mucho tiempo. Sin embargo, la mayoría de las consultas resultaron ser muy simples de optimizar y muchos problemas se repetían decenas de veces en diferentes variaciones. Aquí hay ejemplos de algunas optimizaciones típicas que aplicamos a decenas de consultas similares y cada grupo de consultas optimizadas liberó la base de datos en un 3-5%.
- En lugar de verificar la existencia de registros mediante COUNT y escanear completamente la tabla, comenzamos a usar EXISTS.
- Eliminamos DISTINCT (no hay una receta general, pero a veces se puede eliminar fácilmente, acelerando la consulta entre 10 y 100 veces).
Por ejemplo, en lugar de una consulta para extraer todos los conductores de una gran tabla de entregas (DELIVERY).
SELECT DISTINCT P.ID, P.FIRST_NAME, P.LAST_NAME
FROM DELIVERY D JOIN PERSON P ON D.DRIVER_ID = P.ID
realizamos la consulta sobre una tabla relativamente pequeña de PERSON.
SELECT P.ID, P.FIRST_NAME, P.LAST_NAME
FROM PERSON
WHERE EXISTS(SELECT D.ID FROM DELIVERY WHERE D.DRIVER_ID = P.ID)
Parecería que estábamos utilizando una subconsulta correlacionada, pero esta proporciona una aceleración de más de 10 veces.
- En muchos casos, incluso renunciamos a COUNT y
- en lugar de
UPPER(s) LIKE JOHN%VPS KVM
s ILIKE “John%”
Cada consulta concreta logró acelerarse entre 3 y 1000 veces. A pesar de las cifras impresionantes, al principio nos parecía que no tenía sentido optimizar una consulta que se ejecutaba en 10 ms, que estaba en el puesto 300 de las consultas más pesadas y que en general ocupaba una fracción de un porcentaje del tiempo de carga de la base de datos. Pero aplicando la misma receta a un grupo de consultas similares, recuperamos varios puntos porcentuales. Para no perder tiempo revisando manualmente todas las cientos de consultas, escribimos algunos scripts simples que, mediante expresiones regulares, encontraban consultas similares. Como resultado, la búsqueda automática de grupos de consultas nos permitió mejorar aún más nuestra productividad, invirtiendo esfuerzos modestos.
Después de todo, ya llevamos tres años trabajando con el mismo hardware. La carga media diaria es de alrededor del 30%, y en picos asciende al 70%. La cantidad de solicitudes, al igual que el número de usuarios, ha crecido aproximadamente 10 veces. Todo esto gracias al monitoreo constante de los grupos de solicitudes TOP y MEDIUM. Cada vez que aparece una nueva solicitud en el grupo TOP, la analizamos y tratamos de optimizarla. Revisamos el grupo MEDIUM una vez a la semana utilizando scripts de análisis de solicitudes. Si encontramos nuevas solicitudes que ya sabemos cómo optimizar, las modificamos rápidamente. A veces encontramos nuevas formas de optimización que se pueden aplicar de inmediato a varias solicitudes.
Según nuestras proyecciones, el servidor actual soportará un aumento en la cantidad de usuarios de 3 a 5 veces más. Sin embargo, tenemos otro as bajo la manga: todavía no hemos trasladado las consultas SELECT al espejo, como se recomienda hacer. Pero no lo hacemos conscientemente, ya que queremos agotar primero las posibilidades de la optimización 'inteligente', antes de recurrir a la 'artillería pesada'.
Una perspectiva crítica sobre el trabajo realizado puede sugerir la utilización de escalado vertical. Comprar un servidor más potente, en lugar de perder tiempo de especialistas. El servidor puede no ser tan caro, especialmente considerando que nuestros límites de escalado vertical aún no se han agotado. Sin embargo, el número de solicitudes solo ha aumentado 10 veces. A lo largo de los años, las funcionalidades del sistema han crecido y ahora hay más variedades de solicitudes. La funcionalidad que existía, gracias a la caché, se ejecuta con menos solicitudes, además de que son más eficaces. Esto significa que se puede multiplicar por 5 para obtener un factor real de aceleración. Por lo tanto, se puede decir, con los cálculos más modestos, que la aceleración ha sido de 50 veces o más. Escalar el servidor verticalmente 50 veces habría costado más. Especialmente teniendo en cuenta que una optimización realizada una vez funciona todo el tiempo, mientras que la factura del servidor alquilado llega cada mes.
Fuente: habr.com
