

¡Bienvenido, Habr!
En su momento, fuimos los primeros en introducir el tema y continuamos su desarrollo. En particular, nos ha parecido interesante el tema de la interacción entre Kafka y . Se publicó un artículo (bastante cauteloso) sobre este tema en el blog de Confluent en octubre del año pasado, escrito por Gwen Shapiro. Hoy, queremos llamar su atención sobre un artículo más reciente de abril escrito por Johann Gyger, quien, aunque no se abstuvo de un signo de interrogación en el título, aborda el tema de manera más concreta, acompañando el texto con enlaces interesantes. ¡Perdón por nuestra libre traducción de «chaos monkey», si pueden! Kubernetes está diseñado para trabajar con cargas que no mantienen estado. En general, estas cargas de trabajo se presentan en forma de arquitecturas de microservicios, son ligeras, se escalan horizontalmente bien, siguen los principios de las aplicaciones de 12 factores, permiten trabajar con interruptores automáticos (circuit breaker) y monos del caos (chaos monkeys).
Introducción
Kafka, por otro lado, actúa esencialmente como una base de datos distribuida. Por lo tanto, al trabajar, debes tratar con el estado, que es mucho más pesado que un microservicio. Kubernetes admite cargas con estado, pero, como señala Kelsey Hightower en dos de sus tweets, se debe tener cuidado al hacerlo:
Algunos piensan que si aplican Kubernetes a una carga con estado, se convierte en una base de datos completamente gestionada capaz de competir con RDS. No es así. Puede que, si se trabaja lo suficiente, se integren componentes adicionales y se reclute a un equipo de ingenieros SRE, se pueda configurar RDS sobre Kubernetes.
Siempre recomiendo tener una extrema precaución al ejecutar cargas con estado en Kubernetes. La mayoría de aquellos que se preguntan, «¿puedo ejecutar cargas con estado en Kubernetes?» no tienen suficiente experiencia trabajando con Kubernetes y, a menudo, ni con la carga de la que están preguntando.
Siempre recomiendo tener una cautela excepcional al ejecutar cargas con estado en Kubernetes. La mayoría de aquellos que se preguntan: "¿puedo ejecutar cargas con estado en Kubernetes?" no tienen la experiencia suficiente para trabajar con Kubernetes, y a menudo, ni con la carga en cuestión.
¿Debería ejecutar Kafka en Kubernetes? Pregunta inversa: ¿funcionará mejor Kafka sin Kubernetes? Por eso quiero enfatizar en este artículo cómo Kafka y Kubernetes se complementan entre sí, y cuáles son los posibles escollos al combinarlos.
Tiempo de ejecución
Hablemos de lo básico: el entorno de tiempo de ejecución en sí.
El proceso
Los brokers de Kafka son convenientes en el uso de CPU. TLS puede añadir algunos costos. Sin embargo, los clientes de Kafka pueden cargar más la CPU si utilizan cifrado, pero esto no afecta a los brokers.
Memoria
Los brokers de Kafka consumen memoria. El tamaño del heap de la JVM generalmente se puede limitar a 4-5 GB, pero también necesitarás mucha memoria del sistema, ya que Kafka utiliza de manera muy activa la memoria caché de páginas. En Kubernetes, establece adecuadamente los límites de recursos y las solicitudes del contenedor.
Almacenamiento de datos
El almacenamiento de datos en contenedores es efímero: los datos se pierden al reiniciar. Para los datos de Kafka, puedes utilizar un volumen emptyDir, y el efecto será similar: los datos de tu broker se perderán después de terminar. Sin embargo, tus mensajes aún pueden permanecer en otros brokers como réplicas. Por lo tanto, después de reiniciar, el broker fallido debe primero replicar todos los datos, lo que puede llevar tiempo.
Por eso se debe utilizar almacenamiento de datos a largo plazo. Debe ser un almacenamiento a largo plazo no local con un sistema de archivos XFS o, más precisamente, ext4. No utilices NFS. Te lo advierto. NFS versiones v3 o v4 no funcionarán. En resumen, un broker de Kafka fallará si no puede eliminar un directorio de datos debido a problemas con 'renombrados tontos', que son relevantes en NFS. Si aún no te he convencido, lee muy detenidamente . El almacenamiento de datos debe ser no local, para que Kubernetes pueda elegir más flexiblemente un nuevo nodo después de un reinicio o reubicación.
Red
Al igual que en la mayoría de los sistemas distribuidos, el rendimiento de Kafka depende en gran medida de minimizar la latencia de la red y maximizar el ancho de banda. No intentes alojar todos los brokers en una sola máquina, ya que esto reducirá la disponibilidad. Si un nodo de Kubernetes falla, todo el clúster de Kafka también fallará. Además, no distribuyas el clúster de Kafka entre diferentes centros de datos. Lo mismo se aplica al clúster de Kubernetes. Un buen compromiso en este caso es elegir diferentes zonas de disponibilidad.
Configuración
Manifiestos comunes
En el sitio de Kubernetes hay sobre cómo configurar ZooKeeper usando manifiestos. Dado que ZooKeeper forma parte de Kafka, es conveniente comenzar a familiarizarse con los conceptos de Kubernetes que son aplicables aquí. Una vez que comprendas esto, podrás utilizar los mismos conceptos con el clúster de Kafka.
- Por: un Pod es la unidad mínima desplegable en Kubernetes. Un pod contiene tu carga de trabajo, y el pod corresponde a un proceso en tu clúster. En un pod puede haber uno o más contenedores. Cada servidor de ZooKeeper en el conjunto y cada broker en el clúster de Kafka funcionarán en un pod separado.
- StatefulSet: StatefulSet es un objeto de Kubernetes que maneja múltiples cargas de trabajo con estado, y estas cargas requieren coordinación. StatefulSet proporciona garantías sobre el orden de los pods y su unicidad.
- Servicios sin cabeza: Los servicios permiten desacoplar los pods de los clientes mediante un nombre lógico. Kubernetes se encarga de la distribución de carga en este caso. Sin embargo, en operaciones con cargas de trabajo con estado, como sucede con ZooKeeper y Kafka, los clientes necesitan intercambiar información con una instancia específica. Aquí es donde entran los servicios sin cabeza: en este caso, el cliente aún tendrá un nombre lógico, pero no necesitará acceder directamente al pod.
- Volumen para almacenamiento persistente: se requieren volúmenes como este para la configuración de almacenamiento persistente, no local, que se mencionó anteriormente.
En proporciona un conjunto completo de manifiestos, que facilitan comenzar a trabajar con Kafka en Kubernetes.
Diagramas de Helm
Helm es un gestor de paquetes para Kubernetes, comparable a los gestores de paquetes para sistemas operativos, como yum, apt, Homebrew o Chocolatey. Con él, es fácil instalar paquetes de software predefinidos que están descritos en los charts de Helm. Un chart de Helm bien diseñado facilita la compleja tarea de cómo configurar correctamente todos los parámetros para utilizar Kafka en Kubernetes. Existen varios charts de Kafka: el oficial se encuentra , hay uno de , y otro de .
Operadores
Dado que Helm tiene ciertas desventajas, ha ganado popularidad otro recurso: los operadores de Kubernetes. Un operador no solo empaqueta software para Kubernetes, sino que también permite desplegar dicho software y gestionarlo.
En la lista se mencionan dos operadores para Kafka. Uno de ellos es . Con Strimzi, levantar un clúster de Kafka es pan comido. Practicamente no se requiere configuración, además, el propio operador ofrece algunas funcionalidades agradables, como el cifrado TLS punto a punto dentro del clúster. Confluent también proporciona .
Rendimiento
Es muy importante probar el rendimiento, dotando a su instancia de Kafka de puntos de control. Estas pruebas le ayudarán a detectar cuellos de botella potenciales antes de que surjan problemas. Afortunadamente, Kafka ya ofrece dos herramientas para probar el rendimiento: kafka-producer-perf-test.sh y kafka-consumer-perf-test.sh. Úselas activamente. Para más información, puede consultar los resultados descritos en de Jay Kreps, o referirse a de Amazon MSK por Stéphane Maarek.
Operaciones
Monitoreo
La transparencia en el sistema es muy importante; de lo contrario, no entenderá lo que está sucediendo. Hoy en día, existe una sólida caja de herramientas que proporciona monitoreo basado en métricas al estilo cloud native. Dos herramientas populares para este propósito son Prometheus y Grafana. Prometheus puede recopilar métricas de todos los procesos de Java (Kafka, Zookeeper, Kafka Connect) mediante el exportador JMX de la manera más simple. Si se añaden las métricas de cAdvisor, se podrá tener una visión más completa de cómo se utilizan los recursos en Kubernetes.
Strimzi tiene un ejemplo muy útil de un dashboard de Grafana para Kafka. Visualiza métricas clave, como aquellas relacionadas con sectores sin replicar o que están fuera de línea. Todo es muy claro. Estas métricas se complementan con información sobre el uso de recursos y rendimiento, así como indicadores de estabilidad. ¡Así, obtienes una supervisión básica del clúster de Kafka sin complicaciones!
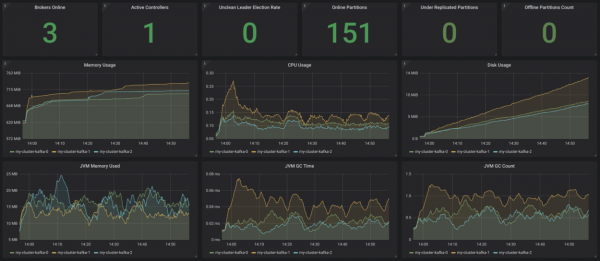
Fuente:
Todo esto sería bueno complementarlo con la supervisión de clientes (métricas de consumidores y productores), así como con una supervisión de latencia (para esto hay ) y monitoreo integral – para esto usa .
Registro
El registro es otra tarea crucial. Asegúrate de que todos los contenedores en tu instalación de Kafka registren en stdout y stderr, y también asegúrate de que tu clúster de Kubernetes agregue todos los registros en una infraestructura de logging centralizada, por ejemplo, en .
Verificación de funcionamiento
Kubernetes utiliza sondas de "vitalidad" (liveness) y disponibilidad (readiness) para comprobar si tus pods están funcionando correctamente. Si la verificación de vitalidad falla, Kubernetes detendrá ese contenedor y lo reiniciará automáticamente, si la política de reinicio está configurada adecuadamente. Si la verificación de disponibilidad falla, Kubernetes aislará este pod de la atención a las solicitudes. Por lo tanto, en tales casos, no se requiere intervención manual, lo que es una gran ventaja.
Implementación de actualizaciones
StatefulSets admiten actualizaciones automáticas: al elegir la estrategia RollingUpdate, cada pod de Kafka se actualizará uno por uno. Así se puede reducir la duración de los tiempos de inactividad a cero.
Escalado
Escalar un clúster de Kafka es una tarea complicada. Sin embargo, en Kubernetes es muy fácil escalar los pods a un número determinado de réplicas, lo que significa que puedes definir de manera declarativa cuántos brokers de Kafka desees. Lo más complicado en este caso es reasignar sectores después de escalar hacia arriba o antes de escalar hacia abajo. Nuevamente, Kubernetes te ayudará con esta tarea.
Administración
Las tareas relacionadas con la administración de su clúster Kafka, especialmente la creación de tópicos y la reasignación de particiones, se pueden realizar mediante los scripts de shell disponibles, abriendo la interfaz de línea de comandos en sus pods. Sin embargo, esta solución no es muy elegante. Strimzi soporta la gestión de tópicos mediante otro operador. Aquí hay trabajo que hacer.
Copia de seguridad y recuperación
Ahora la disponibilidad de Kafka dependerá también de la disponibilidad de Kubernetes. Si su clúster de Kubernetes falla, en el peor de los casos, también fallará el clúster de Kafka. Según la ley de Murphy, esto sucederá seguro y perderá datos. Para disminuir el riesgo de este tipo, trabaje bien en el concepto de copias de seguridad. Puede usar MirrorMaker, otra opción es utilizar S3 para esto, como se describe en este de Zalando.
Conclusión
Al trabajar con clústeres Kafka pequeños o medianos, definitivamente es sensato usar Kubernetes, ya que proporciona flexibilidad adicional y facilita el trabajo con operadores. Si enfrenta requisitos no funcionales muy severos relacionados con la latencia y/o el rendimiento, puede que sea mejor considerar alguna otra opción de despliegue.
Fuente: habr.com
